Dasar-dasar AI
Apa itu RNN dan LSTM dalam Pembelajaran Mendalam?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
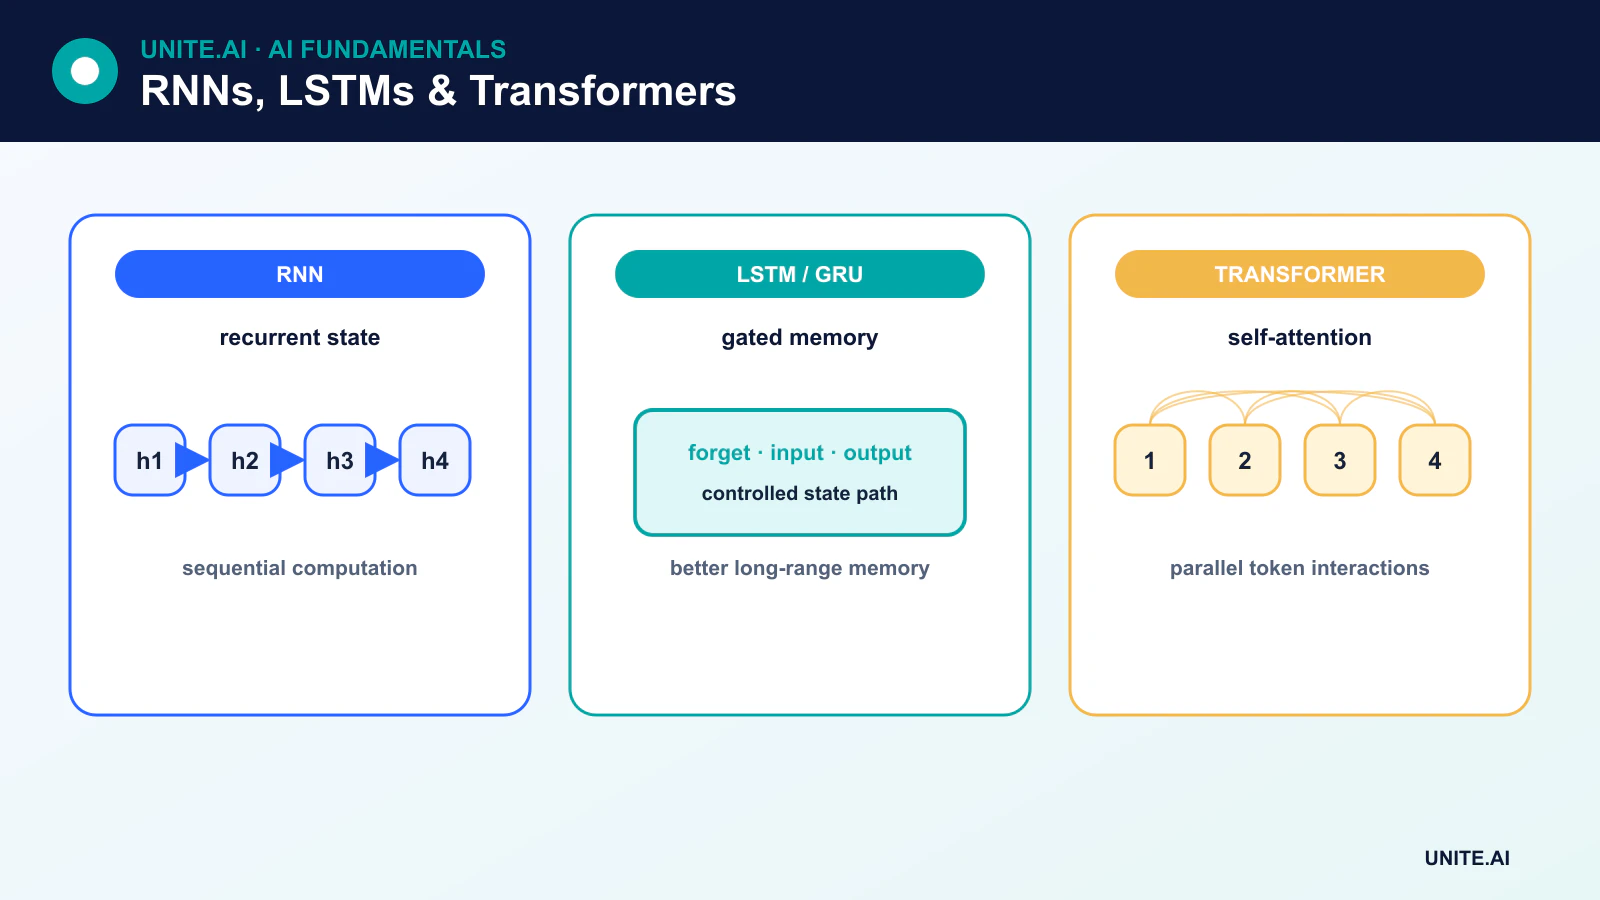
Recurrent neural networks (RNNs) memproses urutan dengan memperbarui status tersembunyi seiring waktu. Long short-term memory (LSTM) adalah jaringan RNN ber-gate yang dirancang untuk mempertahankan dan mengendalikan informasi lebih efektif dibandingkan unit berulang dasar.
RNN dan LSTM pernah mendominasi banyak tugas bahasa, namun chatbot besar modern kini terutama berbasis transformer. Model berulang tetap berguna untuk streaming, deret waktu, ucapan, kontrol, dan sistem dengan sumber daya terbatas di mana status inkremental dan latensi rendah penting.
Key takeaways
- RNN menggunakan kembali parameter yang sama pada setiap langkah urutan dan membawa status tersembunyi ke depan.
- Pelatihan seiring waktu dapat menghasilkan gradien yang menghilang atau meledak.
- LSTM menambahkan status sel serta gate input, forget, dan output.
- Transformer menangani hubungan jarak jauh dan pelatihan paralel secara berbeda; tidak ada arsitektur yang terbaik untuk setiap penerapan.
How a basic RNN works
Pada langkah t, unit berulang sederhana menggabungkan masukan saat ini xₜ dengan status tersembunyi sebelumnya hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Status tersembunyi adalah rangkuman yang dipelajari untuk digunakan pada langkah berikutnya dan, tergantung tugas, sebagai keluaran. Diagram “unrolled” menggambar satu salinan per langkah waktu, namun semua salinan berbagi parameter. Keluaran tidak sekadar disalin kembali sebagai masukan mentah baru; proses berulang mengoper status tersembunyi melalui transformasi yang ditentukan.
Backpropagation through time
RNN dilatih dengan backpropagation through time (BPTT). Urutan yang di‑unroll membentuk grafik komputasi dalam, dan backpropagation menghitung bagaimana kerugian bergantung pada parameter berulang yang dibagi.
Perkalian berulang dapat membuat gradien menyusut mendekati nol atau tumbuh tanpa batas. Gradien yang menghilang menghalangi pembelajaran ketergantungan panjang; gradien yang meledak menghasilkan pembaruan tidak stabil. Pemotongan gradien (gradient clipping) mengatasi gradien meledak, sementara gate, inisialisasi, normalisasi, dan jendela pelatihan yang lebih pendek dapat membantu.
Inside an LSTM cell
LSTM mempertahankan cell state cₜ selain status tersembunyi hₜ. Gate‑gate‑nya adalah kontrol yang dipelajari dan bergantung pada data:
- Forget gate mengatur seberapa banyak status sel sebelumnya yang dipertahankan.
- Input gate mengatur seberapa banyak informasi kandidat yang ditulis.
- Output gate mengatur seberapa banyak informasi sel yang berkontribusi pada status tersembunyi.
Output sigmoid antara nol dan satu berfungsi sebagai gate lunak, sementara kandidat yang ditransformasikan dengan tanh menyediakan konten baru. Jalur penjumlahan status sel membantu gradien tetap, namun LSTM tidak menjamin memori tak terbatas atau menghilangkan semua masalah optimisasi.
GRUs and bidirectional recurrence
Gated recurrent unit (GRU) menggabungkan mekanisme gate ke dalam sel berulang yang lebih sederhana tanpa status sel terpisah seperti LSTM. GRU dapat dilatih lebih cepat dan memberikan performa serupa pada beberapa tugas.
RNN bidirectional memproses urutan lengkap dalam kedua arah dan menggabungkan statusnya. Ini dapat menggunakan konteks masa depan untuk penandaan atau enkoding, namun tidak cocok untuk streaming kausal ketika masukan masa depan belum tersedia.
Sequence-to-sequence models
Encoder‑decoder RNN memetakan satu urutan ke urutan lain. Attention diperkenalkan agar decoder dapat merujuk ke berbagai status encoder alih‑alih bergantung pada satu vektor tetap. Garis kerja ini melahirkan arsitektur transformer, yang menggantikan rekursi dengan blok berbasis attention.
RNNs versus transformers
Transformer memproses posisi pelatihan secara paralel dan menciptakan jalur attention pendek antara token yang jauh. RNN memproses status secara berurutan, membatasi paralelisme namun menyediakan status berulang berukuran konstan selama streaming. Inferensi transformer mungkin memerlukan cache key‑value yang terus berkembang, sementara RNN mengompres riwayat ke dalam status tersembunyi dan dapat kehilangan detail.
Pilih berdasarkan panjang urutan, skala data, perangkat keras, latensi, memori, dan apakah tugasnya offline atau streaming. Arsitektur hibrida dan state‑space menawarkan trade‑off tambahan.
Current use cases
RNN dan LSTM tetap relevan untuk peramalan, deteksi anomali, pemrosesan sensor, komponen ucapan, tulisan tangan, kontrol tertanam, dan pemodelan urutan berlatensi rendah. Mereka bukan penjelasan default untuk model bahasa besar atau chatbot AI saat ini.
Recurrence, gates, and sequence memory
Jaringan saraf berulang memproses urutan dengan menggabungkan masukan saat ini dengan status tersembunyi yang dibawa dari langkah sebelumnya. Bobot yang dibagi memungkinkan panjang urutan variabel, dan unrolling menampilkan komputasi melalui waktu untuk pelatihan. RNN dasar dapat mewakili ketergantungan temporal namun gradien yang dikalikan berulang pada urutan panjang cenderung menghilang atau meledak. Backpropagation terpotong membatasi memori dan komputasi, sementara gradient clipping mengendalikan pembaruan ekstrem. Status tersembunyi adalah rangkuman yang dipelajari, bukan penyimpanan setia setiap token sebelumnya.
Jaringan Long short-term memory menambahkan status sel serta gate input, forget, dan output yang mengatur penulisan, retensi, dan paparan informasi. Gated recurrent units menggunakan struktur reset dan update yang lebih sederhana. Varian bidirectional memakai konteks masa depan sehingga tidak dapat streaming secara kausal tanpa penundaan. Model berulang berlapis, residual, dan yang ditambah attention menambah kapasitas. Padding dan mask harus mencegah elemen urutan buatan memengaruhi status atau loss, dan status harus direset pada batas urutan yang sebenarnya untuk menghindari kebocoran antar contoh.
Training, comparison, and stateful serving
RNN dan LSTM tetap berguna untuk streaming, model kompak pada perangkat, deret waktu, dan beban kerja di mana status berurutan efisien. Transformer memparalelkan pelatihan dan memodelkan interaksi jarak jauh secara berbeda namun dapat memerlukan memori dan cache yang lebih besar. Bandingkan arsitektur berdasarkan akurasi, latensi, throughput, memori, daya, dan performa seiring perubahan panjang urutan. Evaluasi peramalan dengan pembagian waktu bergulir, bahasa dengan metrik yang sadar urutan, dan deteksi anomali dengan ukuran tingkat peristiwa. Periksa kegagalan setelah jeda panjang, perubahan rezim, sampel yang hilang, dan batas urutan yang tiba‑tiba.
Penerapan stateful harus mengaitkan status tersembunyi dengan sesi yang tepat, mengatur kedaluwarsa, mengenkripsinya bila sensitif, dan meresetnya setelah kesalahan atau perubahan model. Peristiwa yang keluar urutan atau duplikat dapat merusak status; sertakan timestamp, nomor urutan, dan idempotensi. Pantau usia status, panjang urutan, kehilangan data, drift output, dan latensi. Kuantisasi memerlukan validasi sensitif gate karena perubahan numerik kecil dapat terakumulasi seiring waktu. Memori RNN memungkinkan konteks, namun juga dapat menyimpan informasi pribadi atau usang, sehingga retensi dan kontrol pengguna harus menjadi bagian dari desain.
Worked example: an LSTM for streaming sensor sequences
Sebuah utilitas menggunakan LSTM untuk meramalkan beban jangka pendek dari pengukuran terbaru, kalender, dan cuaca. Urutan dibangun dengan urutan waktu yang ketat; status tersembunyi direset pada batas feeder, dan padding dimask. Baseline naive musiman dan berbasis gradient‑boost dibandingkan dengan LSTM pada jendela bergulir. Pengujian mencakup interval yang hilang, cuaca tertunda, hari libur, pemadaman, dan panjang urutan di luar pelatihan tipikal.
Layanan streaming mengaitkan status dengan satu feeder, menolak duplikat yang keluar urutan, dan menghapus status setelah jeda panjang atau pembaruan model. Peramalan statistik yang aman menggantikan output ketika sensor atau status tidak valid. Inferensi terkuantisasi diperiksa pada urutan panjang untuk drift yang terakumulasi. Pemantauan melacak usia status, kehilangan data, latensi, bias, dan kesalahan interval. Model dilatih ulang hanya setelah perubahan jaringan listrik dan hasil tinjauan menunjukkan hubungan temporal yang dipelajari tidak lagi dapat digeneralisasi.
Implementation evidence and operational readiness
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Definisikan pengguna yang ditargetkan, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Definisikan ambang batas peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan performa offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan terdokumentasi, pembelajaran insiden, penghapusan dan retensi, serta titik yang jelas kapan harus dinonaktifkan atau diganti.
Frequently asked questions
Is an LSTM always better than a basic RNN?
Tidak. Gate membantu banyak masalah ketergantungan panjang namun menambah komputasi dan parameter. RNN dasar dapat cukup untuk urutan pendek dan sederhana, dan arsitektur lain mungkin lebih baik untuk konteks yang sangat panjang.
Can an LSTM process an unlimited history?
Tidak. Statusnya memiliki kapasitas terbatas, gradien dan data pelatihan memberi batas, serta detail relevan dapat tertimpa. Kinerja pada konteks panjang harus diukur, bukan diasumsikan dari nama arsitekturnya.
Primary references