
Dasar-dasar AI
Apa itu KNN (K-Nearest Neighbors)?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
K-nearest neighbors (KNN) memprediksi hasil dari contoh pelatihan berlabel yang paling dekat dengan titik kueri. Untuk klasifikasi, tetangga memberikan suara untuk kelas. Untuk regresi, nilai target mereka dirata‑rata atau digabungkan dengan cara lain.
KNN adalah metode berbasis contoh, non‑generalisasi: proses pelatihan sebagian besar hanya menyimpan contoh pelatihan dan indeks pencarian opsional. Hal itu tidak menghilangkan kebutuhan akan pembagian data menjadi pelatihan, validasi, dan pengujian. Evaluasi pada data yang ditahan sangat penting untuk memilih k, metrik jarak, pemrosesan fitur, dan aturan pemungutan suara.
Poin-poin utama
- KNN memprediksi secara lokal; ia tidak membagi dataset menjadi klaster terlebih dahulu.
- Skala fitur sangat penting karena jarak menentukan contoh mana yang dihitung sebagai tetangga.
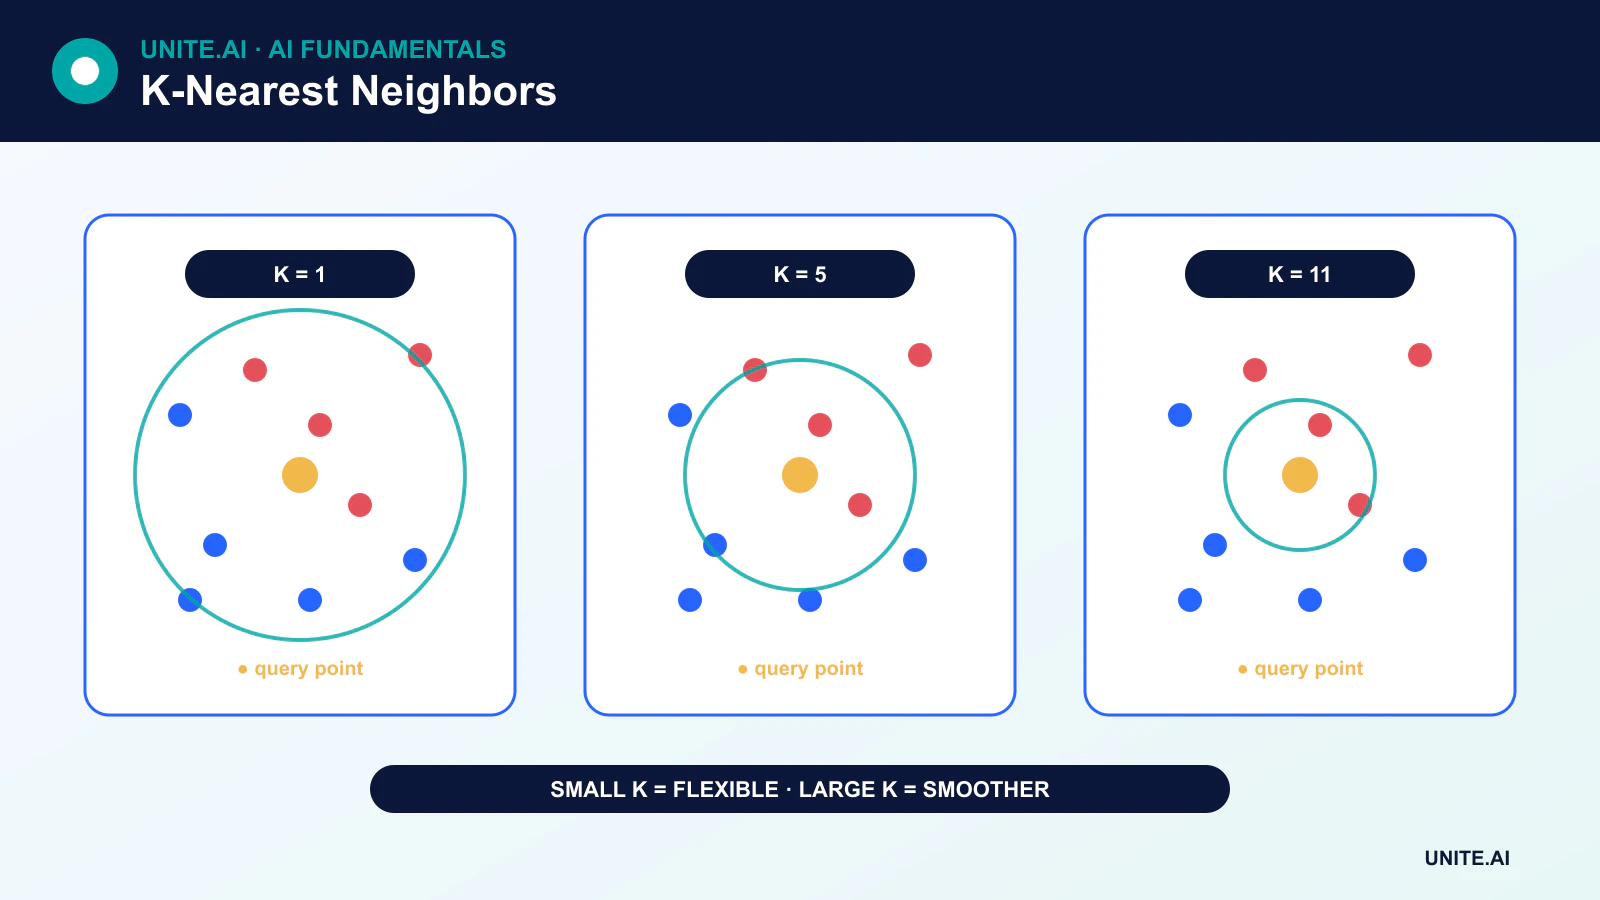
- k kecil dapat menghasilkan kebisingan, sementara k besar dapat menghaluskan struktur lokal.
- Dimensi tinggi, fitur yang tidak relevan, ketidakseimbangan kelas, dan pencarian yang lambat dapat membatasi kinerja.
Cara kerja klasifikasi KNN
- Representasikan kueri dan contoh pelatihan dalam ruang fitur yang sama.
- Hitung jarak dari kueri ke contoh pelatihan.
- Pilih k contoh terdekat.
- Prediksi kelas mayoritas atau gunakan pemungutan suara berbobot jarak.
Pemungutan suara berbobot memberikan pengaruh lebih besar kepada tetangga yang lebih dekat. Situasi seri memerlukan aturan yang terdokumentasi, dan tetangga dengan jarak sama namun label berbeda dapat membuat hasil bergantung pada urutan atau detail implementasi.
Regresi KNN
Untuk regresi, prediksi biasanya berupa rata‑rata target tetangga. Pembobotan jarak dapat mengurangi pengaruh observasi yang lebih jauh. Median atau agregasi yang robust dapat berguna ketika target lokal mengandung outlier.
Metrik jarak
Jarak Euclidean umum digunakan untuk fitur kontinu, jarak Manhattan menjumlahkan selisih absolut, dan jarak kosinus menekankan arah daripada magnitudo. Metrik lain diterapkan pada data biner, kategorikal, geografis, urutan, atau embedding yang dipelajari.
Menyebut KNN “non‑parametrik” berarti ia tidak mengasumsikan bentuk fungsional berdimensi tetap yang terbatas untuk batas keputusan. Namun ia tetap mengasumsikan bahwa representasi dan metrik yang dipilih membuat titik‑titik yang berdekatan relevan satu sama lain.
Mengapa skala penting
Jika satu fitur berkisar antara 0 hingga 1 dan fitur lain antara 0 hingga 100.000, jarak Euclidean biasa akan didominasi oleh fitur kedua. Standardisasi, normalisasi, atau transformasi khusus domain harus dipasang pada bagian pelatihan dan diterapkan pada data validasi, pengujian, dan produksi.
Fitur yang tidak relevan juga dapat mendistorsi lingkungan. Seleksi fitur, reduksi dimensi, atau representasi yang dipelajari dapat membantu, namun setiap pilihan harus divalidasi tanpa kebocoran data.
Memilih k
Dengan k = 1, model dapat mengikuti kebisingan dan contoh yang salah label. Seiring k meningkat, prediksi menjadi lebih halus dan kurang sensitif terhadap satu titik. Jika k menjadi terlalu besar, kelas atau wilayah yang jauh mendominasi dan model menjadi underfit.
Pilih k melalui cross‑validation pada data pelatihan. Untuk klasifikasi biner, k ganjil mengurangi namun tidak menghilangkan seri. Bobot kelas, pembagian stratifikasi, pemilihan ambang, dan metrik yang tepat penting ketika kelas tidak seimbang.
Kutukan dimensi tinggi
Dalam ruang berdimensi tinggi, jarak dapat menjadi kurang informatif karena contoh menjadi jarang dan jarak terdekat serta terjauh menjadi relatif serupa. KNN mungkin memerlukan data dalam jumlah besar untuk mempertahankan lingkungan lokal yang bermakna. Inilah kutukan dimensi tinggi.
Reduksi dimensi atau embedding khusus tugas dapat membantu, namun geometri embedding harus divalidasi untuk konsep kesamaan yang dimaksud.
Kinerja pencarian
Kueri brute‑force membandingkan titik baru dengan setiap contoh yang disimpan. Pohon KD dan pohon bola mempercepat beberapa pencarian eksak, meskipun manfaatnya berkurang pada dimensi tinggi. Indeks tetangga terdekat aproksimasi menukar sedikit recall untuk peningkatan kecepatan dan memori yang besar. Ide ini juga menjadi dasar pencarian kemiripan vektor.
Kekuatan dan keterbatasan
KNN sederhana, mendukung batas keputusan yang tidak teratur, dan memberikan penjelasan berbasis contoh yang intuitif. Namun ia juga dapat membutuhkan memori yang besar, mengungkap contoh pelatihan sensitif, melakukan prediksi secara lambat, dan berkinerja buruk ketika jarak tidak bermakna. Ia merupakan baseline yang berguna—bukan metode yang secara default sangat akurat pada kebanyakan masalah.
Jarak, lingkungan, dan perilaku hyperparameter
K-nearest neighbors menyimpan contoh pelatihan dan memprediksi dari k terdekat berdasarkan jarak yang dipilih. Klasifikasi menggunakan mayoritas atau pemungutan suara berbobot jarak; regresi merata‑rata target tetangga. Skala sangat penting karena fitur dengan rentang tinggi dapat mendominasi jarak Euclidean. Data kategorikal, jarang, urutan, atau geografis mungkin memerlukan jarak Hamming, kosinus, edit, great‑circle, atau yang dipelajari. Metrik merupakan asumsi pemodelan tentang kemiripan, dan harus divalidasi terhadap makna sebenarnya dari kasus yang berdekatan.
k kecil menghasilkan batas yang fleksibel, bervariansi tinggi, dan sensitif terhadap kebisingan; k besar menghaluskan prediksi dan dapat menghapus struktur minoritas. k ganjil hanya menghindari beberapa seri pada klasifikasi biner dan bukan aturan umum. Pilih k, jarak, pembobotan, set fitur, dan pra‑pemrosesan dalam cross‑validation. Ketidakseimbangan kelas dapat membuat pemungutan suara mayoritas lokal mengabaikan hasil yang jarang, sehingga periksa recall per kelas dan komposisi lingkungan. Jarak berdimensi tinggi cenderung terkonsentrasi, dan fitur yang tidak relevan merusak lingkungan; seleksi, reduksi dimensi, atau embedding yang dipelajari dapat membantu.
Pengindeksan, ketidakpastian, dan operasi produksi
Inferensi naïf membandingkan kueri dengan setiap titik pelatihan. Pohon KD dan pohon bola membantu pada dimensi rendah yang cocok; indeks tetangga terdekat aproksimasi menukar ketepatan dengan kecepatan dan skala. Ukur recall pencarian tetangga secara terpisah dari kualitas prediksi. Memori mencakup fitur, label, dan struktur indeks yang disimpan. Pembaruan secara konseptual sederhana namun dapat memerlukan pembangunan ulang indeks, konsistensi versi, dan propagasi penghapusan. Lindungi contoh pelatihan sensitif karena mengembalikan tetangga atau jarak dapat mengungkap data.
KNN dapat menampilkan contoh yang membuat prediksi dapat dipahami, namun kedekatan bukanlah penyebab atau keadilan. Sediakan jarak, selisih suara, dan aturan abstain ketika lingkungan jarang atau bertentangan. Pantau jarak kueri, label tetangga, drift fitur, latensi, dan hasil yang terkonfirmasi. Jaga agar versi pra‑pemrosesan dan indeks tetap sinkron, dan uji hasil eksak versus aproksimasi setelah perubahan. KNN merupakan baseline lokal dan metode retrieval yang efektif ketika jarak bermakna; namun ia kesulitan ketika kemiripan tidak dapat direpresentasikan oleh fitur yang tersedia.
Contoh kerja: KNN untuk substitusi produk
Seorang retailer merepresentasikan produk dengan atribut numerik standar, kompatibilitas kategorikal, dan embedding teks yang dipelajari, kemudian mendefinisikan jarak berbobot yang ditinjau oleh merchandiser. K dan bobot dipilih menggunakan peluncuran produk berikutnya, bukan baris item acak. Evaluasi memeriksa recall substitusi yang relevan, rekomendasi yang tidak kompatibel, jarak, cakupan kategori, dan hasil untuk item yang jarang. Baseline popularitas menunjukkan apakah kemiripan lokal menambah nilai.
Indeks aproksimasi diukur terhadap tetangga eksak untuk recall dan latensi. Kueri yang tidak memiliki item kompatibel yang dekat mengembalikan tidak ada saran daripada memaksa tetangga.
Penghapusan produk dan koreksi atribut menyebar ke indeks melalui pembaruan berversi. Pemantauan melacak distribusi jarak, hasil kosong, override, dan hasil komersial tanpa membingungkan penjualan dengan kompatibilitas sebenarnya. Istilah pemasok sensitif dikecualikan dari penjelasan, dan contoh yang dikembalikan tetap menjadi bukti kemiripan—bukan klaim bahwa produk setara.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Definisikan pengguna yang dituju, lingkungan operasional, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Tetapkan baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Definisikan ambang batas peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penerapan daripada mengasumsikan kinerja offline akan tetap. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah KNN memiliki fase pelatihan?
Ia memiliki sedikit penyesuaian parameter, namun tetap memiliki proses pengembangan: pra‑pemrosesan dipelajari dari data pelatihan, indeks dapat dibangun, dan k, metrik, bobot, serta fitur dipilih dengan validasi.
Apakah KNN sama dengan K-means?
Tidak. KNN terutama merupakan metode prediksi lokal yang diawasi. K-means adalah algoritma pengelompokan tak terawasi di mana K adalah jumlah pusat klaster.
Referensi utama












