Dasar-dasar AI
Apa Itu Pengelompokan K-Means?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
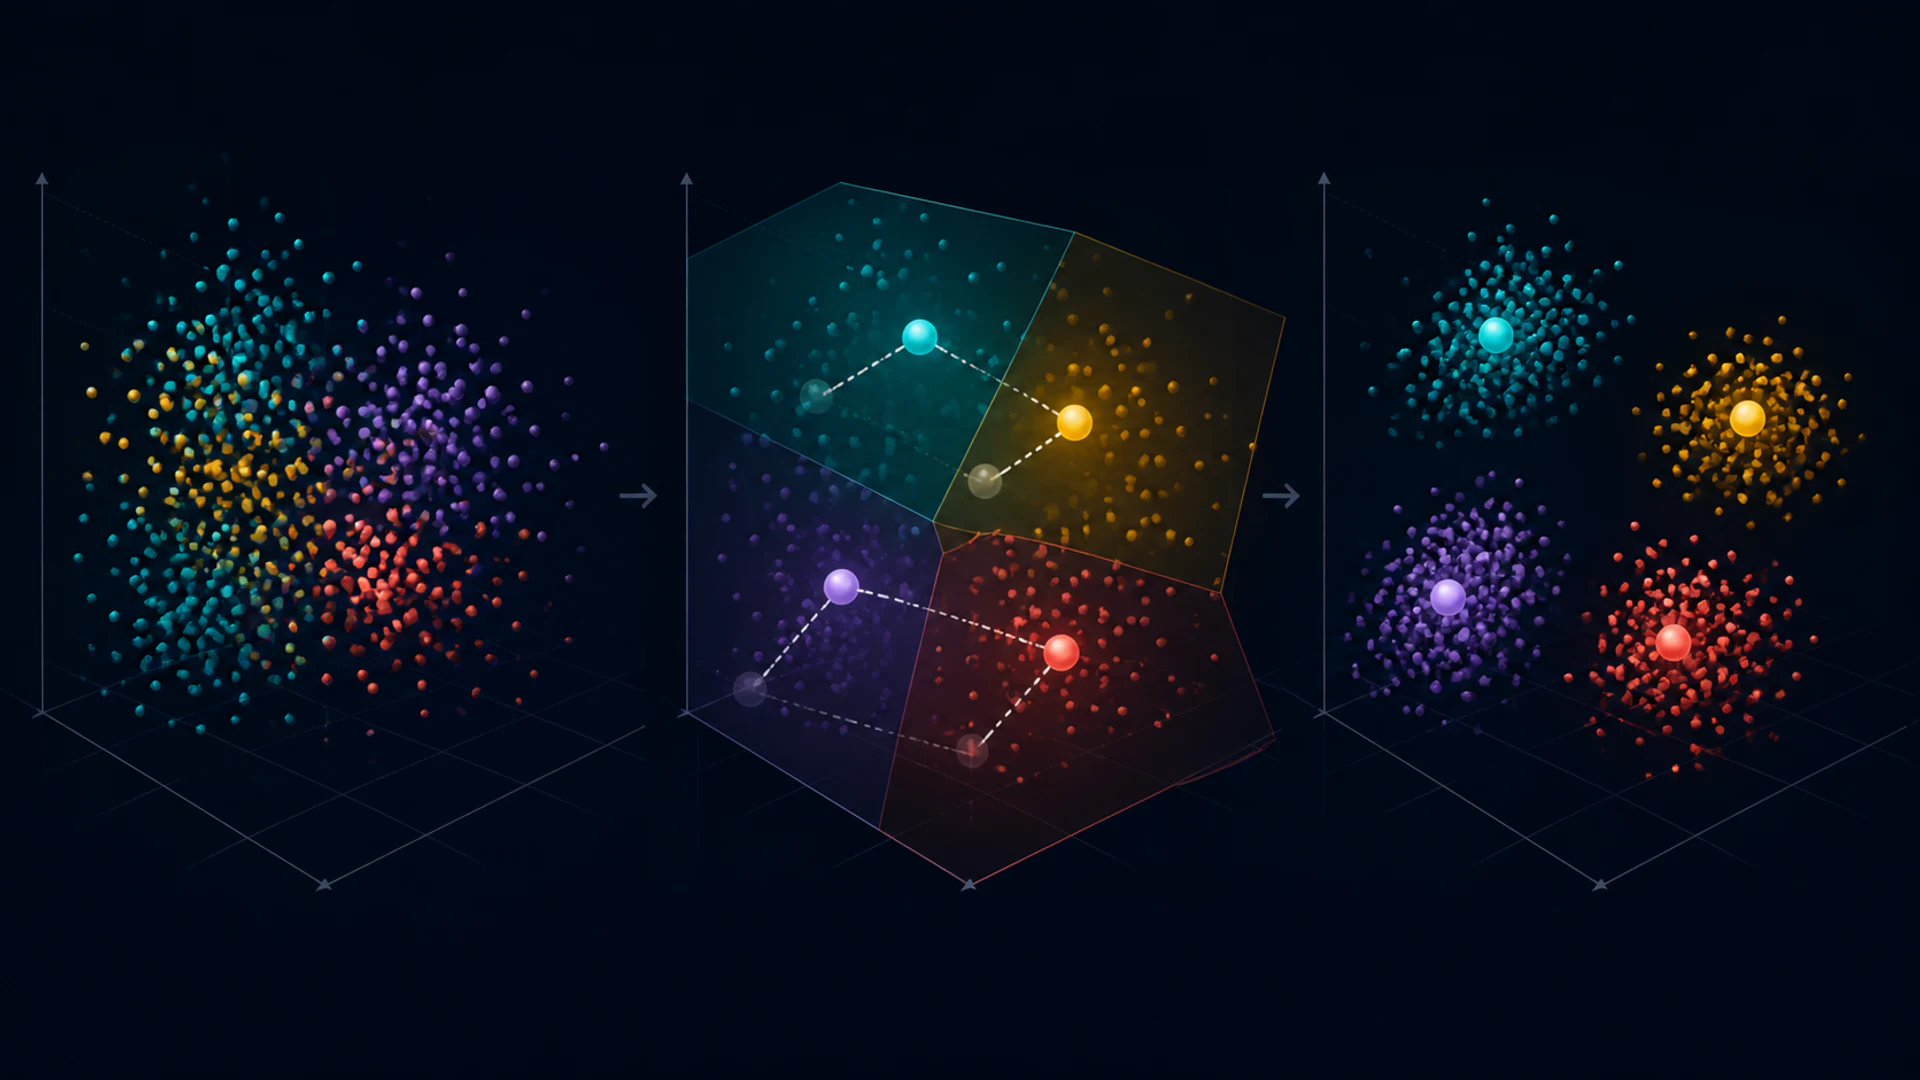
K-means adalah algoritma tak terawasi yang membagi observasi numerik menjadi k klaster. Algoritma ini bergantian antara menugaskan setiap titik ke centroid terdekat dan menghitung ulang setiap centroid sebagai rata‑rata titik yang ditugaskan kepadanya.
Algoritma ini cepat dan berguna, namun hasilnya dipengaruhi oleh skala, jarak, inisialisasi, dan nilai k yang dipilih. Sebuah klaster adalah partisi matematis, bukan otomatis kategori dunia nyata.
Poin Penting
- K-means meminimalkan jarak Euclidean kuadrat dalam‑klaster ke centroid.
- Inisialisasi penting; k-means++ menyebarkan centroid awal dan biasanya meningkatkan hasil.
- Standarkan fitur ketika satuan atau skalanya harus memberikan kontribusi yang sebanding.
- K-means kesulitan dengan pencilan, klaster non‑sferis, kepadatan tidak merata, dan data kategorikal.
Tujuan dan Siklus Pembaruan
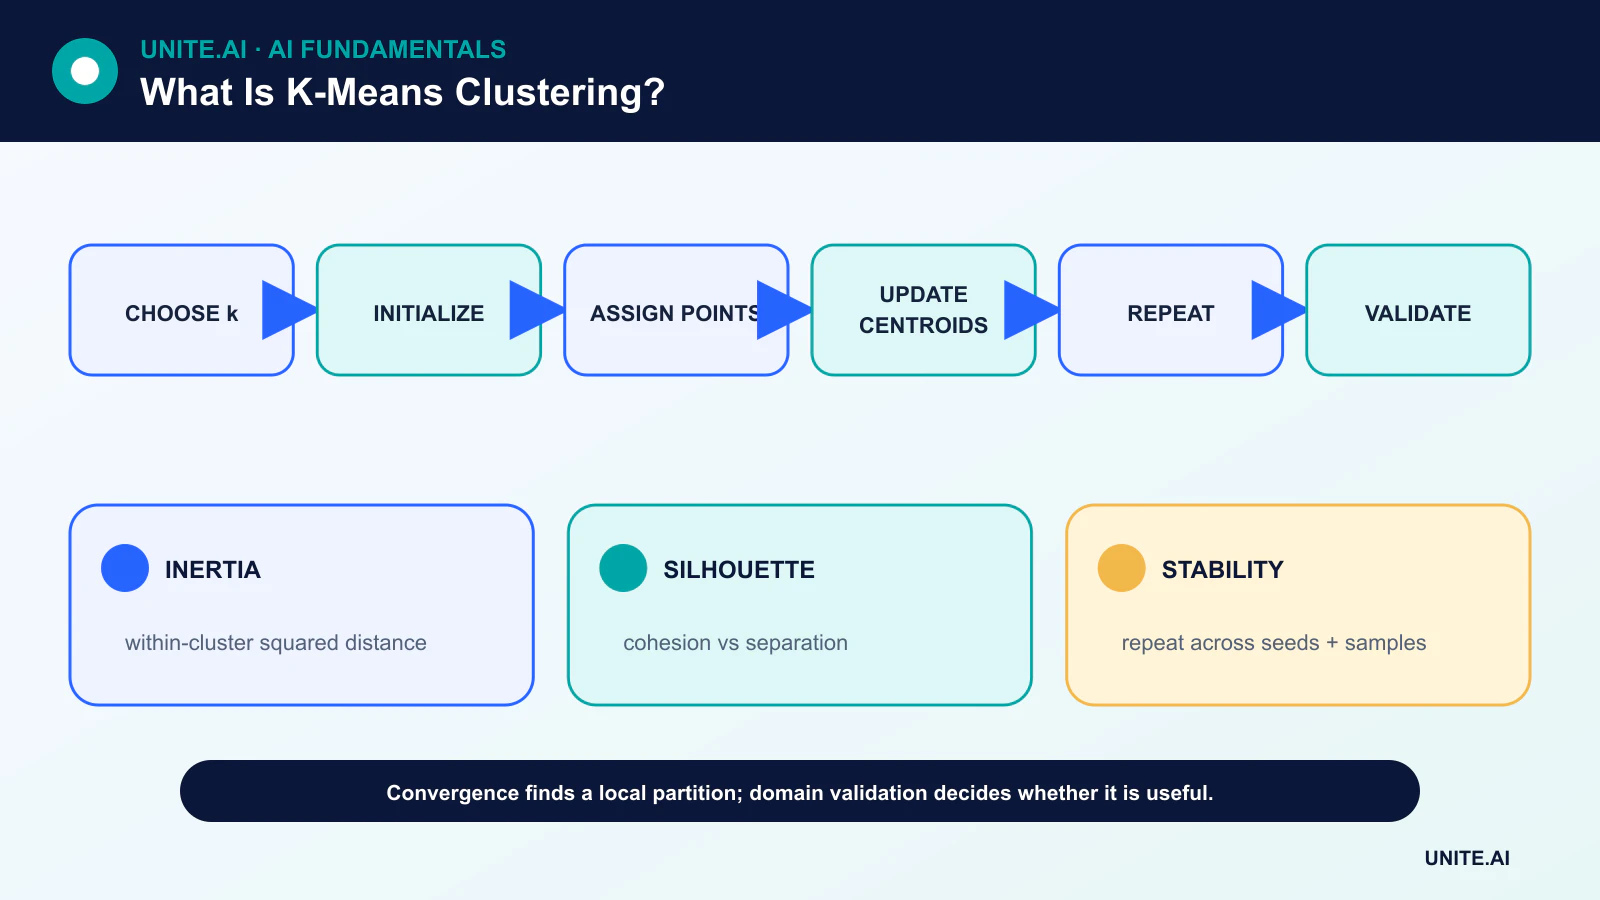
Dengan k centroid, langkah penugasan mengirim setiap observasi ke yang terdekat. Langkah pembaruan menggantikan setiap centroid dengan rata‑rata observasi yang ditugaskan kepadanya. Jumlah kuadrat dalam‑klaster tidak dapat meningkat pada langkah‑langkah ini, sehingga proses konvergen ke optimum lokal.
Konvergensi tidak menjamin optimum global. Centroid awal yang berbeda dapat menghasilkan partisi yang berbeda, itulah mengapa implementasi menjalankan beberapa inisialisasi dan menyimpan solusi dengan inersia terendah.
Inisialisasi dan k-means++
Memilih semua centroid awal secara acak dari satu wilayah padat dapat menghasilkan solusi yang buruk atau konvergensi yang lambat. k-means++ memilih benih dengan probabilitas yang terkait dengan jarak dari benih yang sudah ada, mendorong cakupan seluruh dataset.
Beberapa percobaan tetap berguna. Catat nilai acak (seed) dan jumlah inisialisasi agar hasil dapat direproduksi.
Skala dan Jarak
Jarak Euclidean kuadrat membuat K-means sensitif terhadap satuan. Fitur yang diukur dalam ribuan dapat mendominasi fitur lain yang diukur antara nol dan satu. Standarisasi umum dilakukan, namun pengetahuan domain harus menentukan apakah varians standar yang sama mencerminkan pentingnya yang setara.
Pencilan dapat menarik rata‑rata jauh dari titik‑titik tipikal. Skala robust, pemangkasan, atau metode berbasis medoid mungkin lebih baik. Fitur kategorikal one‑hot menciptakan geometri jarak yang mungkin tidak mencerminkan kesamaan kategori.
Memilih k dan Memvalidasi Klaster
Inersia menurun setiap kali k bertambah, sehingga tidak dapat memilih k secara tunggal. Heuristik siku mencari perbaikan yang semakin berkurang. Analisis siluet membandingkan kohesi dan pemisahan. Stabilitas antar sampel dan seed menambah pemeriksaan lain.
Validasi terkuat adalah kegunaan bagi domain yang dimaksud. Bandingkan klaster dengan hasil yang diketahui, tinjauan pakar, atau tugas hilir tanpa berpura‑pura bahwa label pasca‑hoc ditemukan secara objektif.
Batasan dan Alternatif
K-means menyukai kelompok yang kompak, kira‑kira sferis, dengan skala serupa. Model campuran Gaussian mewakili komponen elipsoidal probabilistik; metode gaya DBSCAN mengidentifikasi wilayah padat dan noise; clustering hierarkis menghasilkan pohon penggabungan.
Reduksi dimensi dapat meningkatkan kecepatan atau mengurangi noise pada masukan, tetapi melatihnya pada seluruh dataset dapat mengubah pertanyaan validasi. Mini‑batch K-means mengurangi komputasi untuk dataset besar dengan mengorbankan pembaruan yang bersifat perkiraan.
Tujuan, Inisialisasi, dan Konvergensi
K-means membagi observasi numerik menjadi k klaster dengan meminimalkan jarak Euclidean kuadrat dalam‑klaster ke centroid. Algoritma Lloyd bergantian menugaskan setiap titik ke centroid terdekat dan menghitung ulang centroid hingga penugasan atau tujuan stabil. Ia konvergen ke optimum lokal, tidak selalu optimum global. Inisialisasi k-means++ menyebarkan pusat awal dan biasanya meningkatkan hasil, namun beberapa seed tetap penting. Standarkan fitur ketika satuan harus berkontribusi secara sebanding karena jarak kuadrat memperbesar variabel berskala tinggi dan pencilan.
Metode ini mengasumsikan klaster yang kira‑kira kompak, sferis, dan berskala serupa di bawah geometri Euclidean. Ia kesulitan dengan manifold memanjang, kepadatan tidak merata, data kategorikal, pencilan berat, dan struktur bertingkat. Klaster kosong dan titik duplikat memerlukan penanganan yang ditentukan. Mini‑batch k-means dapat menangani data besar dengan kompromi perkiraan. Untuk teks yang jarang, k-means sferis berorientasi kosinus dapat lebih cocok dengan arah, sementara campuran, metode kepadatan, clustering hierarkis, atau k-medoids menyandikan asumsi lain.
Memilih k dan Memvalidasi Makna
Kurva siku, skor siluet, kriteria informasi pada model terkait, dan stabilitas dapat memberi petunjuk tentang k, namun tidak ada yang menemukan satu angka yang secara unik benar. Kegunaan bisnis dan interpretasi domain penting. Lakukan refit pada berbagai sampel dan seed, bandingkan pergerakan centroid dan konsistensi penugasan, serta validasi klaster pada hasil independen yang tidak digunakan untuk membentuknya. Proyeksi dua dimensi dapat mendistorsi pemisahan, sehingga periksa jarak dan contoh dalam ruang representasi asli atau yang telah divalidasi.
Klaster adalah kelompok deskriptif yang dibentuk oleh fitur dan metrik yang dipilih; mereka bukan jenis alami atau segmen kausal. Profil yang didasarkan pada variabel yang sama dengan clustering dapat bersifat melingkar. Gunakan atribut yang ditahan dan tinjauan kualitatif, serta periksa apakah klaster terutama mereproduksi geografi, sumber data, atau sifat sensitif. Klaster kecil mungkin merupakan anomali atau artefak. Menamai sebuah klaster tidak membuat setiap anggotanya cocok dengan label tersebut.
Penerapan dan Pemeliharaan
Simpan skala, urutan fitur, centroid, definisi jarak, dan label klaster secara bersamaan. Untuk titik baru, pantau jarak ke centroid yang ditugaskan dan proporsi yang jauh di luar dukungan pelatihan; berikan status tidak diketahui alih‑alih memaksa setiap kasus masuk ke klaster. Lacak ukuran klaster, centroid, dan relevansi hasil seiring waktu. Pelatihan ulang mengubah identitas klaster, sehingga petakan atau versi aturan hilir alih‑alih secara diam‑diam menggunakan nama lama. K-means merupakan baseline kompresi dan segmentasi yang berguna bila geometri‑nya cocok dengan pertanyaan, bukan mesin penemuan universal.
Contoh Praktis: Segmentasi Pelanggan dengan k-means
Sebuah perusahaan berlangganan menstandarkan fitur penggunaan selama jendela tetap, menghapus pengidentifikasi akun, dan menguji k pada berbagai seed. Stabilitas, siluet, dan hasil bisnis yang ditahan ditinjau, namun tim produk juga memeriksa akun representatif dan batas. Mereka menemukan satu klaster hanyalah pelanggan baru dengan observasi lebih singkat, sehingga masa kerja ditangani secara eksplisit. K-means dibandingkan dengan alternatif hierarkis dan berbasis kepadatan alih‑alih diasumsikan cocok. Latihan ini diperlakukan sebagai pembelajaran tak terawasi, bukan penemuan label.
Segmen mengarahkan riset dan percobaan pesan, bukan kelayakan atau harga. Akun baru yang jauh dari semua centroid menerima penugasan tidak diketahui. Skala, fitur, centroid, dan nama diberi versi, dan pelatihan ulang memetakan klaster baru ke lama hanya dengan bukti. Pemantauan melacak ukuran klaster, jarak, dan relevansi hasil. Atribut sensitif dan proksi diaudit, dan tim menghindari menggambarkan klaster sebagai tipe kepribadian alami ketika mereka sebenarnya partisi matematis dari perilaku yang dipilih.
Bukti Implementasi dan Kesiapan Operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas kapan sistem harus dinonaktifkan atau diganti.
Pertanyaan yang Sering Diajukan
Apakah K-means terawasi atau tidak terawasi?
Ini tidak terawasi karena menerima fitur dan jumlah klaster yang dipilih, bukan label target.
Apakah K-means mengklasifikasikan data baru?
Setelah model dilatih, sebuah titik baru dapat ditugaskan ke centroid terdekat. Itu merupakan penugasan klaster, bukan prediksi kelas terawasi.
Referensi Utama