Fundamentos de la IA
¿Qué son los Modelos de Lenguaje a Gran Escala (LLMs)?

 Añade Unite.AI a tus fuentes preferidas en Google
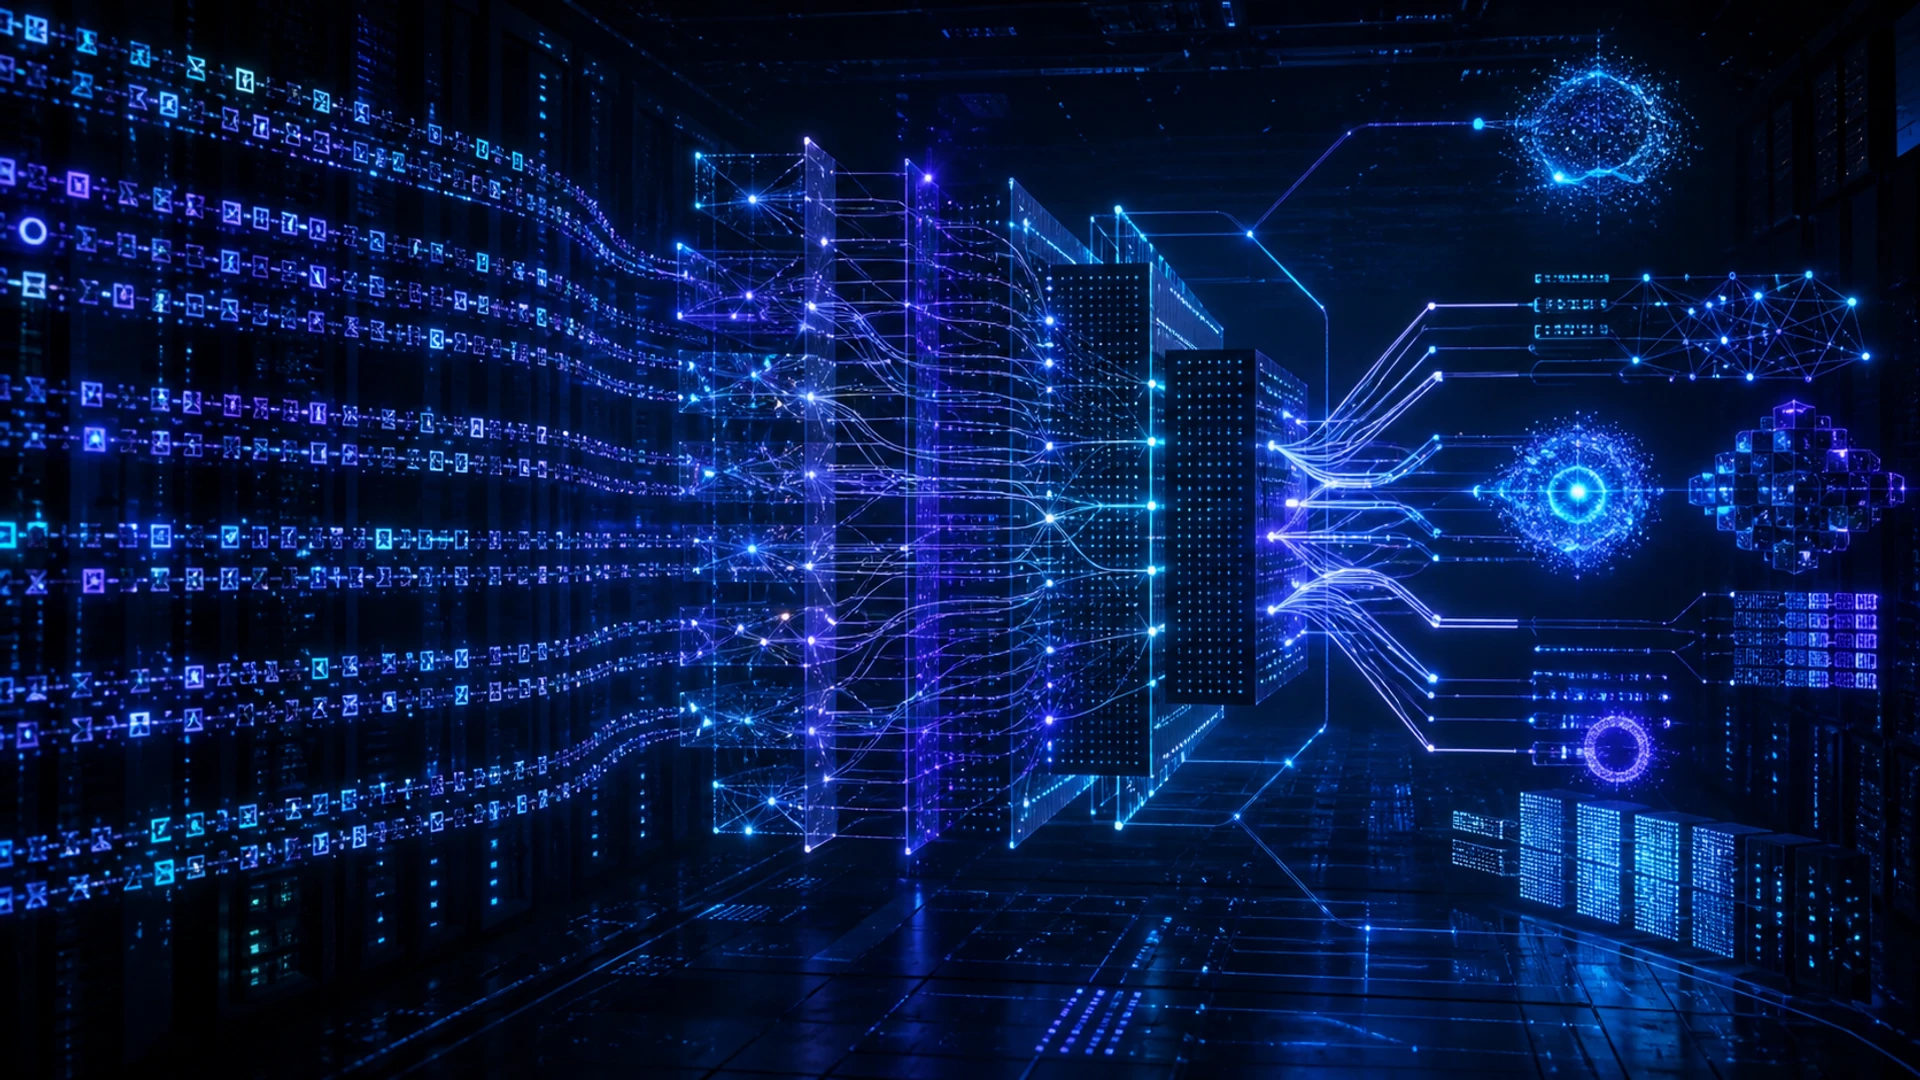
Un modelo de lenguaje a gran escala (LLM) es una red neuronal entrenada con grandes colecciones de secuencias para predecir tokens u objetivos lingüísticos relacionados. La mayoría de los LLM actuales utilizan arquitecturas transformer y pueden generar, clasificar, resumir, traducir, recuperar y transformar lenguaje mediante una interfaz común.
Un LLM no es una base de datos ni un razonador garantizado. Su salida es una predicción condicional moldeada por los datos de entrenamiento, el post‑entrenamiento, el contexto, las herramientas y la decodificación. La fluidez puede coexistir con errores fácticos, incertidumbre, sesgo o conductas inseguras.
Conclusiones clave
- La tokenización convierte el texto en unidades discretas; los embeddings y la atención construyen representaciones contextuales.
- El preentrenamiento aprende patrones generales, mientras el ajuste fino y los métodos de preferencia moldean el comportamiento en tareas.
- La recuperación y las herramientas pueden añadir evidencia o acciones actuales, pero requieren permisos y validación separados.
- Evalúe el sistema desplegado en cuanto a calidad, fundamentación, seguridad, latencia, costo y deriva.
Tokens, transformadores y preentrenamiento
El texto se divide en tokens. Un transformer los mapea a vectores, mezcla la información mediante capas de atención y feed‑forward, y produce una distribución de probabilidad sobre el token siguiente o ausente.
Los objetivos de auto‑supervisión generan señales de entrenamiento a partir de secuencias crudas. Escalar en parámetros, datos y cómputo puede mejorar la pérdida de forma predecible a lo largo de rangos, pero la calidad del conjunto de datos, la arquitectura, la optimización y la evaluación determinan qué capacidades emergen en la práctica.
Post‑entrenamiento e inferencia
El ajuste por instrucciones utiliza demostraciones; la optimización por preferencias puede hacer que las salidas se ajusten mejor a los juicios humanos o a una política. En la inferencia, un prompt y el historial de conversación definen el contexto, mientras que la temperatura y los parámetros de muestreo influyen en la variabilidad.
RLHF y métodos similares moldean el comportamiento en lugar de instalar un verificador de hechos completo. El modelo aún puede generar una respuesta plausible pero sin respaldo.
Recuperación, herramientas y agentes
La generación aumentada por recuperación proporciona pasajes seleccionados de una colección externa. La invocación de herramientas permite que el código de la aplicación consulte bases de datos, realice cálculos, búsquedas o acciones. Estos patrones separan parte del conocimiento y la ejecución de los pesos del modelo.
La aplicación debe validar los argumentos de la herramienta, aplicar los permisos, preservar las citas y tratar el contenido recuperado como entrada no confiable. La búsqueda por similitud vectorial ayuda en la recuperación, pero no prueba que un pasaje respalde la respuesta.
Limitaciones y evaluación
Los LLM pueden alucinar, exponer contenido memorizado, seguir instrucciones malintencionadas, reproducir sesgos y fallar en tareas que parecen similares a los ejemplos de entrenamiento. Un contexto largo no garantiza que cada hecho se utilice o reconcilie correctamente.
Evalúe en tareas privadas representativas con prompts y versiones documentados. Mida el soporte mediante fuentes, rechazos, calibración, seguridad, resultados por subgrupos, carga de trabajo humana, latencia y costo. Monitoree después del lanzamiento, ya que los modelos, los datos y el comportamiento de los usuarios cambian.
Datos de entrenamiento y desarrollo del modelo
Los corpus de preentrenamiento combinan páginas web, libros, código, material académico, conversaciones y fuentes licenciadas o curadas. Las canalizaciones detectan el idioma, eliminan duplicados, filtran contenido de calidad y no seguro, gestionan datos personales y eligen pesos de mezcla. Estas decisiones moldean el conocimiento, la cobertura lingüística, el estilo, el sesgo y la memorización.
Los procesos de optimización agrupan secuencias de tokens y minimizan la pérdida de predicción mediante descenso de gradiente. El entrenamiento distribuido divide datos, tensores del modelo, etapas de la canalización o expertos entre aceleradores. El guardado de checkpoints, la estabilidad numérica, la comunicación en red y la recuperación de fallos se convierten en importantes desafíos de ingeniería a gran escala.
La evaluación durante el entrenamiento sigue la pérdida y los conjuntos de capacidades, pero la contaminación de los benchmarks puede inflar los resultados. Reserve periodos de tiempo y tareas propietarias, busque superposiciones y reporte los prompts exactos, la decodificación, las herramientas y la puntuación. Un modelo puede mejorar la pérdida media mientras aparecen regresiones en seguridad o en un idioma de bajos recursos.
Ventanas de contexto, decodificación e inferencia
En la inferencia, la caché de claves‑valores almacena las proyecciones de atención de los tokens anteriores, de modo que no necesitan recomputarse en cada paso. La memoria de caché crece con las capas, la secuencia, el lote y la representación. La cuantización y la paginación reducen la presión, pero pueden alterar la calidad o la latencia.
La decodificación codiciosa selecciona el token de mayor probabilidad; la temperatura reescala las probabilidades; top‑k y top‑p restringen el conjunto de candidatos; la búsqueda en haz sigue varias secuencias. La mejor estrategia depende de si la tarea valora determinismo, diversidad, salida estructurada o probabilidad de la secuencia. Siempre valide el esquema después de la generación.
Un contexto largo aumenta la cantidad de información disponible, pero no garantiza recuerdo o razonamiento. La posición, los distractores, las contradicciones y la estructura del prompt afectan su uso. La recuperación puede seleccionar un conjunto de evidencia más pequeño, mientras que la resumición comprime la historia a riesgo de perder detalles. Mida el rendimiento según la longitud y la ubicación del contexto.
Adaptación, despliegue y economía
El ajuste fino completo actualiza todos los parámetros; los métodos eficientes en parámetros actualizan adaptadores o matrices de bajo rango; el preentrenamiento continuo adapta la distribución del dominio; el ajuste por instrucciones y preferencias moldea las respuestas. La recuperación suele ser mejor para hechos que cambian con frecuencia, mientras que el ajuste es mejor para el comportamiento y el formato de la tarea. Los métodos pueden combinarse.
Las opciones de despliegue incluyen APIs alojadas, puntos finales gestionados, pesos abiertos auto‑alojados, modelos en el dispositivo e híbridos. Compare el manejo de datos, control de versiones, latencia, rendimiento, regiones, disponibilidad, portabilidad del modelo, soporte y costo total. El auto‑alojamiento transfiere la responsabilidad de seguridad, escalado, actualizaciones y monitoreo de abusos.
El costo por token es incompleto. Un modelo débil puede requerir reintentos, prompts más largos, más revisiones o errores costosos. Mida el costo por tarea completada exitosamente a un nivel de calidad y riesgo requerido. Utilice caché, lotes, modelos más pequeños enrutados y código determinista donde mejoren el flujo de trabajo completo.
Ejemplo práctico: anclando un LLM en documentos empresariales
Un asistente de documentos debe comenzar con un corpus consciente de permisos, identificadores de documentos estables, versiones y fechas de vigencia, una estructura analizables y un conjunto de evaluación de preguntas respondibles, no respondibles, ambiguas y conflictivas. Los índices de recuperación segmentan en fragmentos y metadatos, pero el tamaño y solapamiento de los fragmentos deben coincidir con la estructura del documento. La calidad de búsqueda se mide independientemente antes de la generación, de modo que un modelo fluido no pueda ocultar evidencia faltante.
En tiempo de ejecución, autentique al usuario, filtre la recuperación por acceso, recupere y reordene la evidencia, construya un prompt limitado, genere una respuesta citada y valide la salida requerida. El modelo debe indicar cuando las fuentes entran en conflicto o no respaldan una respuesta. El uso de herramientas y acciones externas requiere autorización separada. Proteja contra instrucciones incrustadas en documentos recuperados tratando el contenido como datos en lugar de como una política del sistema de mayor prioridad.
Evalúe el recall de recuperación, la precisión de citación, la corrección de respuestas, la fundamentación, los rechazos, la latencia y el costo en diferentes roles y tipos de documentos. Registre versiones del modelo, prompt, índice, analizador y corpus para cada prueba. En producción, registre los IDs de evidencia y la retroalimentación sin exponer texto privado, monitoree nuevas preguntas no respondibles tras cambios de contenido y mantenga una alternativa segura. Una interfaz de LLM no reemplaza la gestión de registros, el control de acceso o la revisión responsable por parte de expertos.
La planificación de capacidad debe modelar las distribuciones de longitud de prompts y salidas, usuarios concurrentes, comportamiento de caché, latencia de herramientas y tasas de reintento. El streaming mejora la latencia percibida pero complica la moderación y cancelación, ya que contenido inseguro o incorrecto puede llegar al usuario antes de que se verifique la respuesta completa. Establezca presupuestos de tokens y herramientas, aísle a los inquilinos, proteja credenciales del proveedor y ensaye la conmutación por falla entre versiones del modelo sin cambiar silenciosamente el comportamiento del que dependen los usuarios.
Lista de verificación para implementación práctica
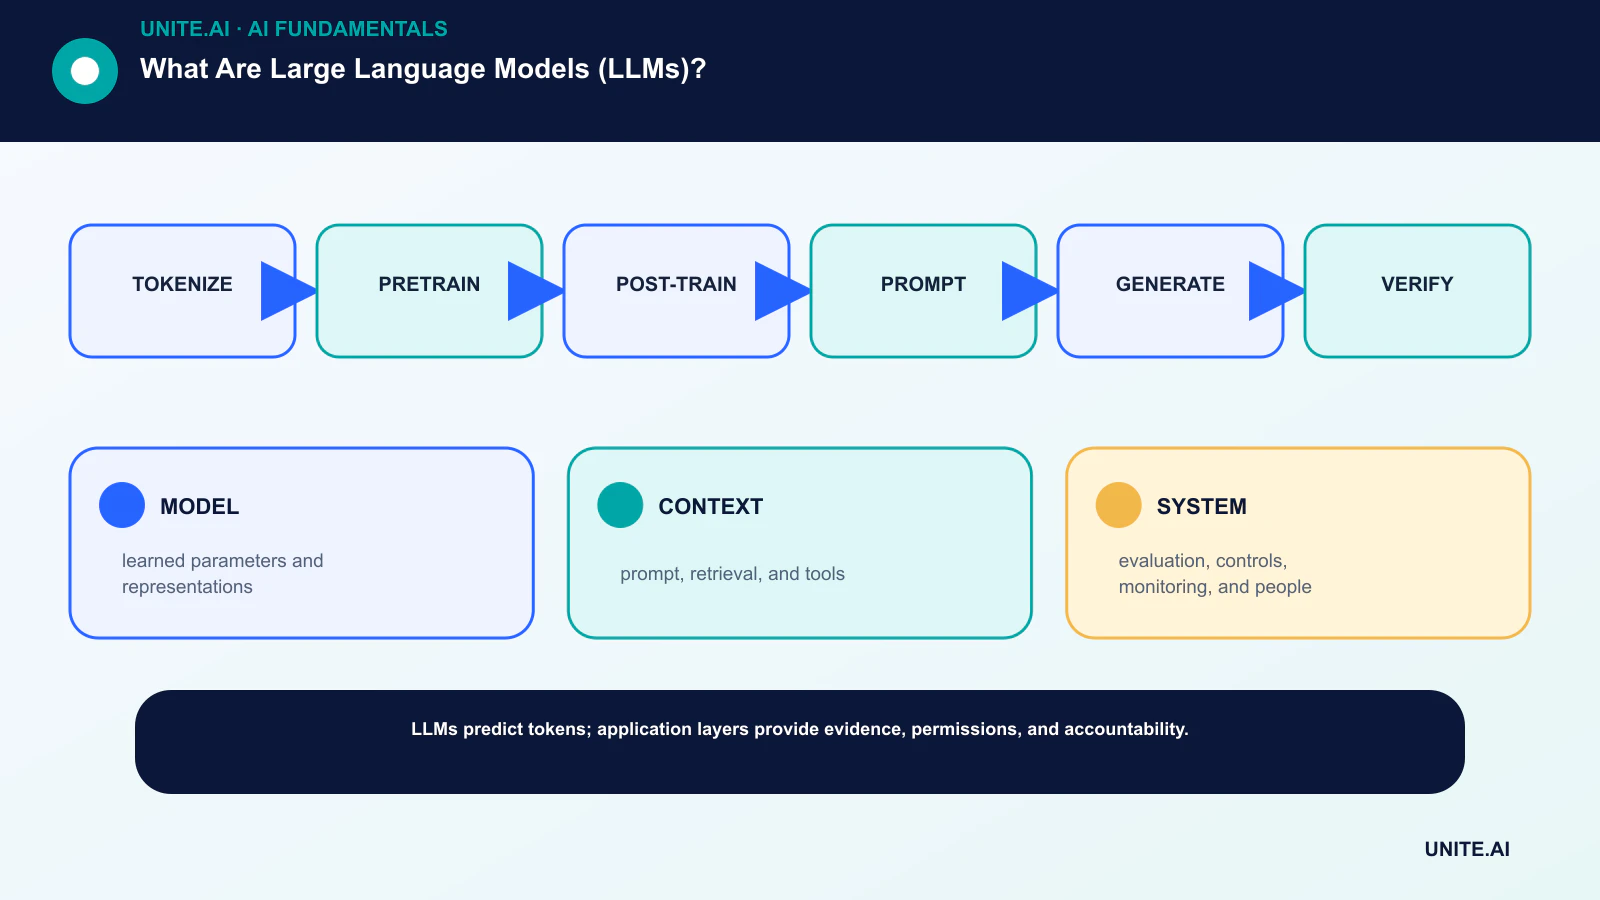
Convierta el concepto en un flujo de trabajo limitado y verificable: tokenizar → preentrenar → post‑entrenar → prompt → generar → verificar. Asigne un responsable accountable, documente los datos y dependencias, establezca una línea base simple, defina criterios de aceptación y de detención, pruebe fallos representativos y defina monitoreo, retroceso y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallos de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, sobrescribir una salida o detener la operación. Revise la decisión cuando lleguen datos del mundo real, ya que un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- MODEL: parámetros aprendidos y representaciones.
- CONTEXT: prompt, recuperación y herramientas.
- SYSTEM: evaluación, controles, monitoreo y personas.
Preguntas frecuentes
¿Por qué los LLM se llaman grandes?
No existe un umbral universal de parámetros. “Grande” se refiere a la escala en relación con los modelos de lenguaje anteriores, incluidos los parámetros, los datos de entrenamiento, el cómputo y el alcance de uso.
¿Los LLM entienden el lenguaje?
Construyen representaciones internas útiles y muestran un comportamiento complejo, pero la palabra “entender” tiene varios significados. El rendimiento debe demostrarse tarea por tarea en lugar de inferirse a partir de la fluidez.
Referencias principales