
Fundamentos de la IA
¿Qué es el aprendizaje profundo por refuerzo?

 Añade Unite.AI a tus fuentes preferidas en Google
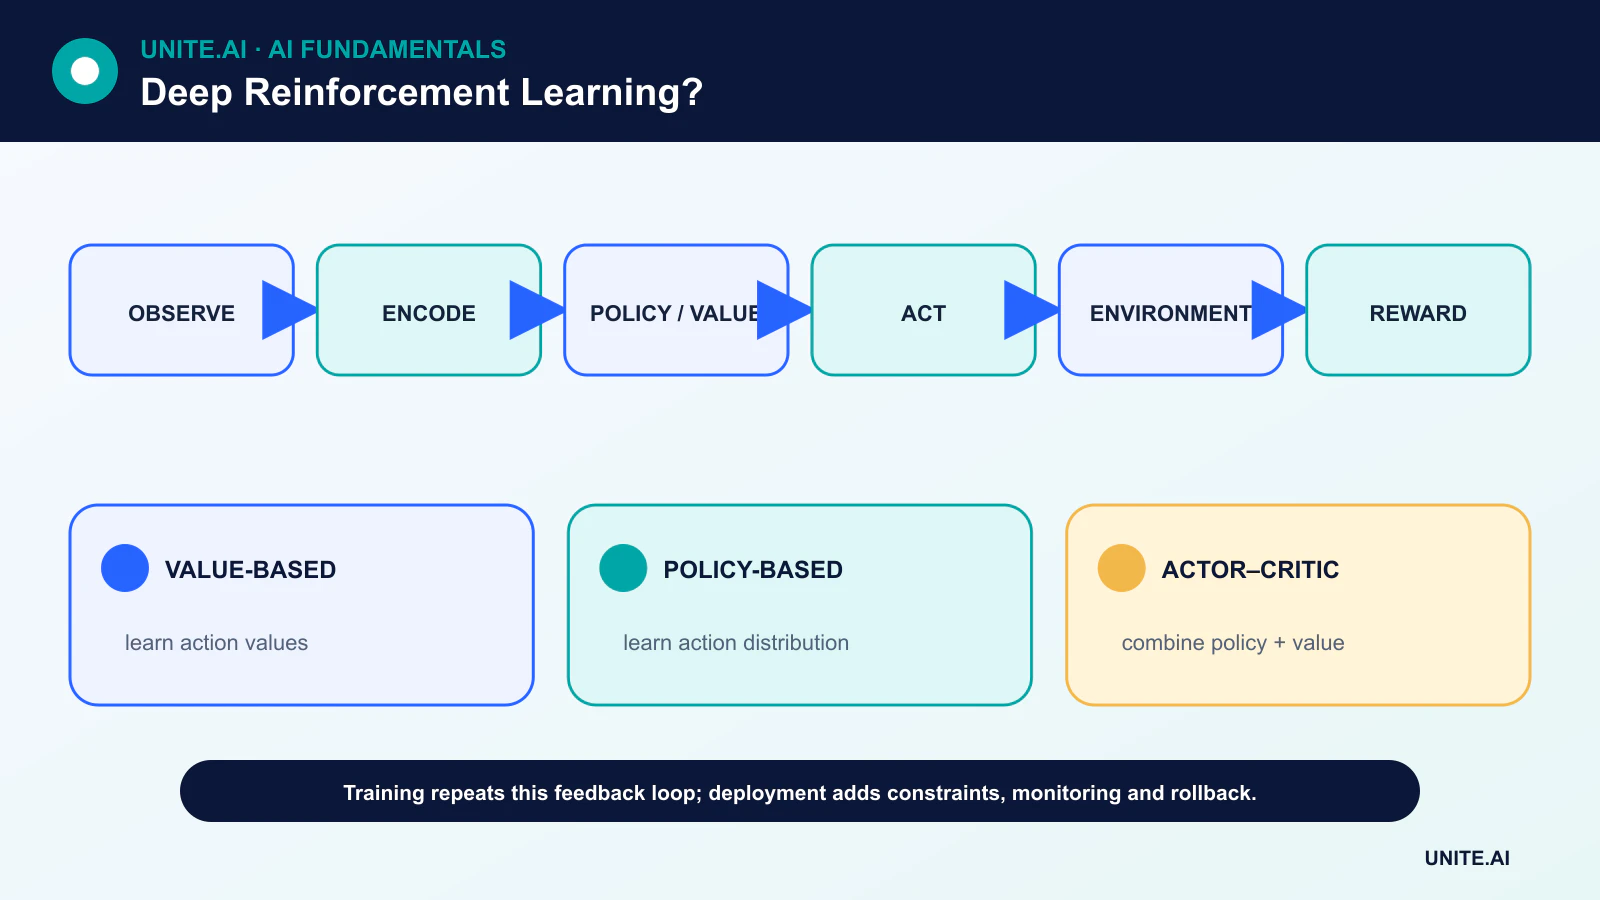
Deep reinforcement learning (deep RL) combina el aprendizaje por refuerzo con redes neuronales profundas. Un agente observa un estado, elige una acción, recibe una recompensa y una nueva observación, y luego ajusta una política o función de valor para mejorar decisiones futuras.
La red profunda no elimina las partes difíciles del aprendizaje por refuerzo. Proporciona una forma flexible de representar imágenes, flujos de sensores, espacios de acción grandes o funciones de valor complejas. La exploración, el crédito retardado, el entrenamiento inestable y la evaluación segura en el mundo real siguen siendo problemas de ingeniería centrales.
Puntos clave
- El Deep RL aprende decisiones secuenciales a partir de la interacción, en lugar de una tabla fija de ejemplos etiquetados.
- Los métodos basados en valores estiman cuán buenas son las acciones; los métodos de política aprenden directamente la distribución de acciones; los métodos actor‑crítico combinan ambos.
- Los buffers de repetición, las redes objetivo y un diseño cuidadoso de recompensas pueden mejorar el entrenamiento, pero ninguno garantiza un comportamiento fiable.
- Una alta puntuación en el simulador no es prueba de robustez, seguridad o de una transferencia exitosa al mundo físico.
El problema de decisión: estados, acciones y recompensas
Muchas tareas de deep‑RL se modelan como un proceso de decisión de Markov. En el instante t, el agente recibe el estado u observación s_t, selecciona la acción a_t y luego recibe la recompensa r_{t+1} y el siguiente estado. El objetivo es el retorno descontado esperado, no necesariamente solo la recompensa inmediata.
El factor de descuento controla cuán importantes son las recompensas lejanas. Una función de recompensa define lo que el proceso de optimización buscará, por lo que un proxy incompleto puede generar un comportamiento técnicamente exitoso pero operativamente indeseable. Esta es una razón por la cual el diseño de recompensas y la prueba de restricciones merecen la misma atención que la arquitectura del modelo.
Métodos basados en valores, basados en políticas y actor‑crítico
Un algoritmo basado en valores estima el valor de un estado o de una acción. Las Deep Q‑networks utilizan una red neuronal para aproximar los valores Q y típicamente eligen la acción con la mayor estimación, manteniendo cierta exploración. Un algoritmo de gradiente de política, en cambio, optimiza una política parametrizada que produce una distribución de acciones.
Los sistemas actor‑crítico mantienen tanto un actor, que propone acciones, como un crítico, que estima su valor. Este diseño soporta el control continuo pero introduce fuentes interactivas de error de estimación. Por lo tanto, el Deep RL depende de los mismos fundamentos que aprendizaje profundo, descenso de gradiente y retropropagación.
Por qué los buffers de repetición y las redes objetivo ayudan
Las muestras de experiencia sucesivas están correlacionadas, mientras que una actualización de la red cambia los objetivos usados por actualizaciones posteriores. La repetición de experiencia rompe parte de esa correlación temporal al muestrear transiciones más antiguas. Una red objetivo cambia más lentamente que la red en línea, lo que hace que los objetivos de arranque sean menos volátiles.
Estos mecanismos mejoran la estabilidad del entrenamiento, pero la afinación sigue siendo importante. La tasa de aprendizaje, el programa de exploración, la escala de recompensas, la composición del replay y la capacidad de la red pueden cambiar el resultado. Se deben reportar múltiples semillas aleatorias porque una única ejecución puede ser engañosa.
RL offline, RL basado en modelos y sim‑to‑real
El RL offline aprende a partir de un conjunto de datos registrado fijo sin recopilar nuevas interacciones. Puede ser útil cuando la exploración es costosa o insegura, pero la política debe evitar acciones que estén poco representadas en el registro. El RL basado en modelos aprende o utiliza un modelo de transición para planificar, intercambiando supuestos adicionales por mayor eficiencia de muestras.
Los robots a menudo se entrenan en simulación, aleatorizan parámetros físicos y luego afinan o validan en hardware. La brecha de realidad aún puede revelar errores en percepción, temporización, dinámica de contactos y casos límite no modelados. Un sistema de aprendizaje por refuerzo debe evaluarse bajo perturbaciones, cambios de distribución y restricciones de seguridad explícitas.
Evaluación y puesta en producción
Una evaluación útil separa los entornos de entrenamiento y prueba, informa distribuciones de retorno en lugar de solo la mejor puntuación, y verifica violaciones de restricciones, frecuencia de intervenciones y comportamiento en el peor caso. Para sistemas reales, los equipos también necesitan monitoreo, procedimientos de reversión, espacios de acción limitados y una anulación humana.
El Deep RL resulta más atractivo cuando las decisiones son secuenciales, hay retroalimentación disponible y las reglas de control escritas a mano son insuficientes. Es una opción poco adecuada cuando hay abundantes etiquetas supervisadas, un optimizador convencional resuelve el problema, o la exploración pondría en riesgo a personas o activos.
Arquitecturas de Deep RL y señales de entrenamiento
El aprendizaje profundo por refuerzo utiliza redes neuronales para representar una función de valor, una política, un modelo del entorno o alguna combinación. Una deep Q‑network predice valores de acción y aprende a partir de objetivos de diferencia temporal; la repetición de experiencia reduce la correlación entre actualizaciones, mientras que una red objetivo estabiliza el objetivo en movimiento. Los métodos de gradiente de política optimizan directamente el retorno esperado, y los métodos actor‑crítico usan un crítico aprendido para reducir la varianza del gradiente. Las acciones continuas a menudo requieren variantes deterministas o estocásticas de actor‑crítico, mientras que las acciones discretas de alta dimensión necesitan una exploración cuidadosa y un diseño de salida.
El entrenamiento es no estacionario porque la política cambia los datos que recoge. Los datos de replay se vuelven off‑policy, los objetivos de arranque dependen de estimaciones actuales, y la aproximación funcional puede amplificar errores —una combinación a veces llamada la tríada mortal. Los estimadores dobles reducen la sobreestimación de valores; las funciones de ventaja mejoran la asignación de crédito; los bonos de entropía fomentan la exploración; los objetivos recortados restringen actualizaciones de política destructivas. Normalice observaciones y recompensas solo con un estado a prueba de fugas, y registre el entorno, envoltorio, repetición de acción, terminación y preprocesamiento de recompensas porque cada uno cambia el problema.
Evaluación, simuladores y seguridad en la puesta en producción
Informe distribuciones de retorno a través de semillas independientes y distintas instancias del entorno, no solo la mejor ejecución. Evalúe la eficiencia de muestras, violaciones de restricciones, resultados catastróficos, sensibilidad a la escala de recompensas y robustez al ruido de observación, retrasos, errores de actuadores y dinámicas cambiadas. Compare con control scriptado, control clásico, imitación supervisada y RL más simple. Reserve variaciones del entorno y pruebe métricas de resultados sin recompensa, porque un agente puede explotar la recompensa programada mientras falla en la tarea prevista. La inspección de videos y trayectorias a menudo revela comportamientos ocultos por el retorno agregado.
La simulación permite la exploración pero introduce una brecha de realidad. Aleatorice la física y percepción relevantes, calibre contra mediciones reales y utilice una transferencia conservadora. Los datos registrados o el RL offline evitan la exploración en línea pero no pueden evaluar de forma fiable acciones no respaldadas por la política de comportamiento. Los sistemas de producción deben restringir el conjunto de acciones, la tasa, los recursos y el rango operativo; requerir aprobación para acciones de alto impacto; e incluir un controlador seguro verificado o una parada. Monitoree las entradas de la política, la distribución de acciones, la recompensa, los resultados reales y las intervenciones, con reversión a una versión de política probada.
Un ejemplo concreto de control
Para el enrutamiento de robots en un almacén, defina el estado a partir de la ubicación, carga, batería, tráfico cercano y cola de tareas; las acciones a partir de movimientos permitidos y decisiones de carga; y la recompensa a partir del trabajo completado, energía, congestión y restricciones de seguridad. Entrene primero en un simulador calibrado con demanda aleatoria y fallas de sensores, luego refleje decisiones reales. Nunca permita que la política aprendida evite la prevención de colisiones. Evalúe el rendimiento junto con casi colisiones, bloqueos, emergencias de batería y el retraso peor caso. El proyecto solo tiene éxito si el sistema en capas mejora las operaciones sin transferir riesgos de exploración inaceptables a personas o equipos.
Ejemplo práctico: DRL para refrigeración de centros de datos
Un centro de datos restringe a un agente RL a los puntos de ajuste de refrigeración aprobados y lo entrena en un simulador calibrado a partir de datos históricos de clima, carga de trabajo, temperaturas y respuesta del equipo. La recompensa incluye energía, pero restricciones rígidas protegen por separado la temperatura, la humedad y el ciclo del equipo. El control predictivo basado en modelo y las reglas existentes son referencias. La evaluación abarca estaciones, ruido de sensores, retraso de actuadores, pérdida de equipos, cargas inusuales y múltiples semillas, informando energía, violaciones, varianza y recuperación.
La política aprendida se ejecuta en modo sombra antes de una prueba en zona limitada. Un controlador de seguridad externo recorta acciones y los operadores pueden anular. Se monitorean la tasa de acciones, la cobertura del estado, la incertidumbre del modelo y los resultados reales de la instalación; una discrepancia del simulador o intervenciones repetidas activan la reversión. El equipo actualizado o la lógica de control crean una nueva versión del entorno y su validación. Los ahorros energéticos se aceptan solo cuando la fiabilidad, el margen térmico, el mantenimiento y la respuesta a fallas se mantienen al menos tan fuertes como la referencia.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, reversión y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿El aprendizaje profundo por refuerzo es lo mismo que el aprendizaje profundo?
No. El aprendizaje profundo proporciona los aproximadores de funciones; el aprendizaje por refuerzo aporta la interacción, la recompensa y el objetivo de decisiones secuenciales.
¿Una alta recompensa indica que el agente aprendió el comportamiento previsto?
No necesariamente. Significa que la política encontró un comportamiento que obtiene una buena puntuación bajo la recompensa y el entorno implementados. Aún se requieren pruebas independientes de seguridad y de alineación con los objetivos.
Referencias principales












