
Fundamentos de la IA
¿Qué es el aprendizaje automático?

 Añade Unite.AI a tus fuentes preferidas en Google
Machine learning (ML) es una rama de la inteligencia artificial en la que un sistema aprende patrones a partir de datos para poder hacer predicciones, clasificaciones, recomendaciones o decisiones sin que un desarrollador tenga que escribir una regla separada para cada caso posible. El resultado no es una máquina que “piensa” como una persona. Es un modelo estadístico que asigna entradas a salidas útiles y puede evaluarse con datos que no vio durante el entrenamiento.
El aprendizaje automático forma parte del campo más amplio de la IA, mientras que deep learning es una familia de métodos de aprendizaje automático basados en redes neuronales de múltiples capas. Esta distinción es importante: no todo sistema de IA utiliza ML, y no todo problema de ML requiere una red neuronal.
Conclusiones clave
- El ML aprende una relación a partir de ejemplos en lugar de depender únicamente de reglas escritas a mano.
- Un modelo útil debe generalizar a datos nuevos, no solo memorizar su conjunto de entrenamiento.
- El aprendizaje supervisado, no supervisado, semi‑supervisado, auto‑supervisado y por refuerzo resuelven diferentes tipos de problemas.
- La calidad de los datos, el diseño de la evaluación y el monitoreo son tan importantes como el algoritmo.
Cómo funciona el aprendizaje automático
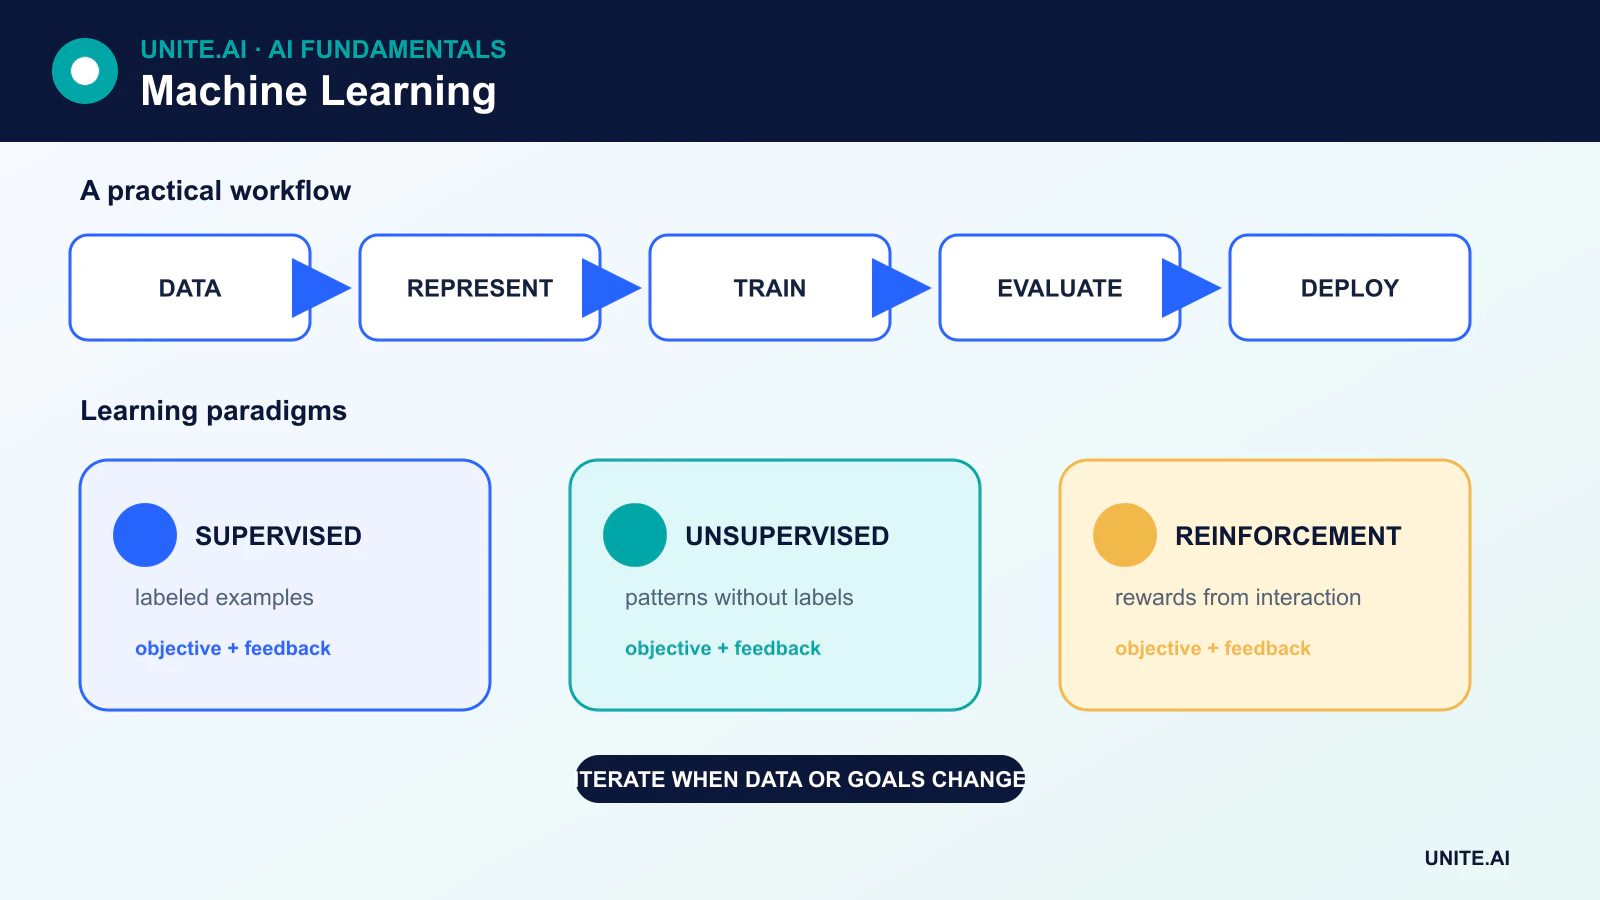
La mayoría de los proyectos de ML pueden entenderse como una secuencia de seis etapas:
- Definir la tarea. Decidir qué debe predecir o descubrir el sistema y qué significa el éxito en la aplicación real.
- Recopilar y preparar los datos. Limpiar los registros, manejar valores faltantes, crear características útiles y documentar el origen de los datos.
- Dividir los datos. Un conjunto de entrenamiento se usa para ajustar el modelo, un conjunto de validación ayuda a seleccionar configuraciones, y un conjunto de prueba brinda una estimación final sobre datos no utilizados.
- Entrenar el modelo. Un algoritmo ajusta los parámetros del modelo para reducir una función de pérdida o satisfacer otro objetivo de aprendizaje.
- Evaluar la generalización. Las métricas deben reflejar la tarea, el equilibrio de clases, los costos de error y la población en la que operará el modelo.
- Desplegar y monitorear. Los datos del mundo real pueden cambiar, por lo que los equipos vigilan la deriva, la degradación del rendimiento, el sesgo y los fallos operativos.
Las variables suministradas a un modelo se denominan comúnmente características. En el aprendizaje supervisado, la respuesta deseada se llama etiqueta o objetivo. Los parámetros aprendidos por un modelo codifican una relación entre las características y la salida; no son una base de datos de reglas explícitas.
Los principales paradigmas de aprendizaje
Aprendizaje supervisado
En el aprendizaje supervisado, los ejemplos incluyen tanto entradas como objetivos conocidos. Un modelo de clasificación predice categorías, como si una transacción es fraudulenta. Un modelo de regresión predice un valor continuo, como la demanda de energía esperada.
Los algoritmos supervisados comunes incluyen árboles de decisión, máquinas de vectores de soporte, vecinos más cercanos (K‑nearest neighbors), regresión lineal y logística, árboles de gradiente potenciado y redes neuronales. Un umbral de clasificación como 0.5 es una decisión elegida después de que el modelo produce una puntuación o probabilidad; no es una propiedad inmutable de la regresión logística.
Aprendizaje no supervisado
El aprendizaje no supervisado trabaja con datos que no incluyen etiquetas objetivo. El objetivo puede ser encontrar conglomerados, detectar observaciones inusuales, estimar una distribución o crear una representación de menor dimensión. Un conglomerado es un grupo sugerido por una regla de similitud; no es automáticamente una clase significativa del mundo real.
Los ejemplos incluyen agrupamiento K‑means, análisis de componentes principales, estimación de densidad y algunas formas de autoencoders. Un autoencoder aprende a reconstruir su entrada mediante una representación comprimida. No crea automáticamente etiquetas de verdad fundamental.
Aprendizaje semi‑supervisado y auto‑supervisado
Aprendizaje semi‑supervisado combina un conjunto de datos etiquetado pequeño con un conjunto de datos no etiquetado más grande. Aprendizaje auto‑supervisado crea una señal de entrenamiento a partir de los propios datos —por ejemplo, prediciendo palabras enmascaradas o emparejando dos vistas transformadas de la misma imagen. La auto‑supervisión es fundamental en muchas pipelines de transformers y modelos fundacionales modernos porque puede usar grandes colecciones de texto, imágenes, audio o video sin que una persona etiquete cada ejemplo.
Aprendizaje por refuerzo
En el aprendizaje por refuerzo, un agente realiza acciones en un entorno y recibe recompensas o costos. El objetivo es aprender una política que maximice la recompensa acumulada esperada. Esto difiere del aprendizaje supervisado porque la acción correcta no se proporciona para cada estado, y una acción puede influir en los datos que el agente encontrará a continuación.
Entrenamiento, validación y generalización
Un modelo que funciona bien con sus ejemplos de entrenamiento aún puede fallar con datos nuevos. Esta falla se conoce como sobreajuste. Los equipos la reducen mediante una capacidad de modelo adecuada, regularización, validación cruzada, aumento de datos, prevención de fugas y un conjunto de prueba verdaderamente independiente.
No existe una métrica única para cada tarea de ML. La clasificación puede requerir precisión, exhaustividad, F1, calibración o una medida ponderada por costos en lugar de la exactitud bruta. La regresión puede usar error absoluto medio, raíz del error cuadrático medio o una pérdida específica del dominio. El agrupamiento necesita diferentes formas de evaluación interna o validada externamente. La métrica debe reflejar lo que un error significa para el usuario o la organización.
Los algoritmos de aprendizaje automático son herramientas, no garantías
Un algoritmo lleva supuestos. Los modelos lineales asumen una forma particular de relación. K‑nearest neighbors asume que la distancia seleccionada representa una similitud significativa. Naive Bayes asume que las características son condicionalmente independientes dado la clase. Los árboles de decisión particionan el espacio de características usando reglas de división aprendidas; sus hojas contienen predicciones basadas en grupos de observaciones de entrenamiento en lugar de necesariamente una observación cada una.
Por lo tanto, la elección del modelo depende del tamaño de los datos, los tipos de características, los requisitos de latencia, las necesidades de interpretabilidad y el costo de los errores. Un modelo más simple puede superar a uno más grande cuando los datos son limitados o las restricciones operativas favorecen la velocidad y la transparencia.
Dónde se utiliza el aprendizaje automático
El ML respalda la clasificación de búsqueda, recomendaciones, pronósticos, detección de anomalías, traducción, reconocimiento de voz, visión por computadora, mantenimiento predictivo, detección de fraude y análisis científico. Las mismas técnicas también pueden amplificar sesgos históricos, exponer información sensible o comportarse de manera impredecible bajo cambios de distribución. Un despliegue responsable requiere documentación, supervisión humana cuando sea apropiado, pruebas de seguridad y monitoreo continuo.
De la definición del problema a un experimento de aprendizaje automático válido
Un proyecto de aprendizaje automático debe comenzar con una decisión y un resultado medible, no con un algoritmo. Defina la unidad de predicción, el objetivo, el tiempo de observación, el tiempo de decisión, las características disponibles y el costo de cada error. Para un modelo de abandono, por ejemplo, usar eventos registrados después de la cancelación filtraría la respuesta. Establezca una regla simple o una línea base estadística, luego divida los datos por tiempo, cliente, ubicación u otro límite que refleje el despliegue. Divisiones aleatorias de filas pueden colocar observaciones casi idénticas en los conjuntos de entrenamiento y prueba y producir una puntuación engañosa.
La ingeniería de características convierte los registros crudos en representaciones que el modelo puede usar, pero cada característica necesita procedencia y una garantía de disponibilidad. Ajuste la normalización, vocabulario, imputación y reducción de dimensionalidad solo con los datos de entrenamiento, luego aplique la transformación aprendida a los datos de validación y prueba. La validación cruzada estima la variación entre muestras; un conjunto de prueba final sin tocar respalda la decisión de lanzamiento. Seleccione métricas según las consecuencias: precisión y exhaustividad para errores de clasificación desiguales, calibración cuando las probabilidades impulsan acciones y medidas ponderadas por costo o utilidad cuando los errores tienen diferentes efectos operativos.
Despliegue, monitoreo y operación responsable
La inferencia en producción repite la transformación completa del tiempo de entrenamiento y devuelve una predicción bajo restricciones de latencia, rendimiento y disponibilidad. Empaquete el preprocesamiento con el modelo, valide los esquemas de entrada, versiona los artefactos y compare los resultados entre implementaciones offline y de servicio. Elija un umbral usando la capacidad operativa y el compromiso de error en lugar de usar por defecto 0.5. Despliegue mediante evaluación sombra, una cohorte limitada o un experimento con métricas de salvaguarda. Mantenga una alternativa determinista y una ruta de reversión para fallos de dependencias o comportamientos inaceptables.
Monitoree la calidad de la entrada, la deriva de características, la distribución de predicciones, la calibración, los resultados por subgrupos, la latencia, el costo y las etiquetas confirmadas cuando finalmente lleguen. La deriva es una señal para investigar, no una prueba automática de que el reentrenamiento ayudará. El reentrenamiento requiere datos revisados, pruebas repetibles, aprobación y comparación con el modelo actual dominante. Documente los usos previstos e inválidos, derechos de datos, privacidad, seguridad, intervención humana y apelación donde las personas se vean afectadas. El aprendizaje automático es un sistema de decisiones mantenido; el archivo del modelo es solo un componente reemplazable.
Ejemplo práctico: predicción de fallos de equipos
Un fabricante define una predicción por máquina‑día: si se producirá una falla verificada dentro de siete días usando solo la telemetría disponible al inicio de ese día. Divide los datos por máquina y tiempo, los compara con reglas basadas en edad y umbrales, ajusta el preprocesamiento con los datos de entrenamiento y evalúa el recall de eventos, falsas alertas, tiempo de anticipación de advertencias, calibración y capacidad de mantenimiento. El reemplazo de sensores y los apagados planificados se modelan como contexto operativo en lugar de tratarse como observaciones ordinarias.
El modelo se ejecuta inicialmente en modo sombra. Las alertas muestran la telemetría contributiva y la incertidumbre, pero los mantenedores deciden si inspeccionar. Los hallazgos y causas confirmadas se convierten en etiquetas gobernadas; la ausencia de una orden de trabajo no se asume como ausencia de falla. Un despliegue escalonado usa límites de alerta y una alternativa manual, mientras que el monitoreo rastrea la salud de los sensores, la deriva de entrada, la precisión revisada, el tiempo de inactividad y el mantenimiento innecesario. El reentrenamiento ocurre solo después de que la revisión de datos y umbrales demuestre una mejora probable sobre el sistema desplegado actual.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, mantenga una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Referencias principales












