Fundamentos de la IA
¿Qué es la reducción de dimensionalidad?

 Añade Unite.AI a tus fuentes preferidas en Google
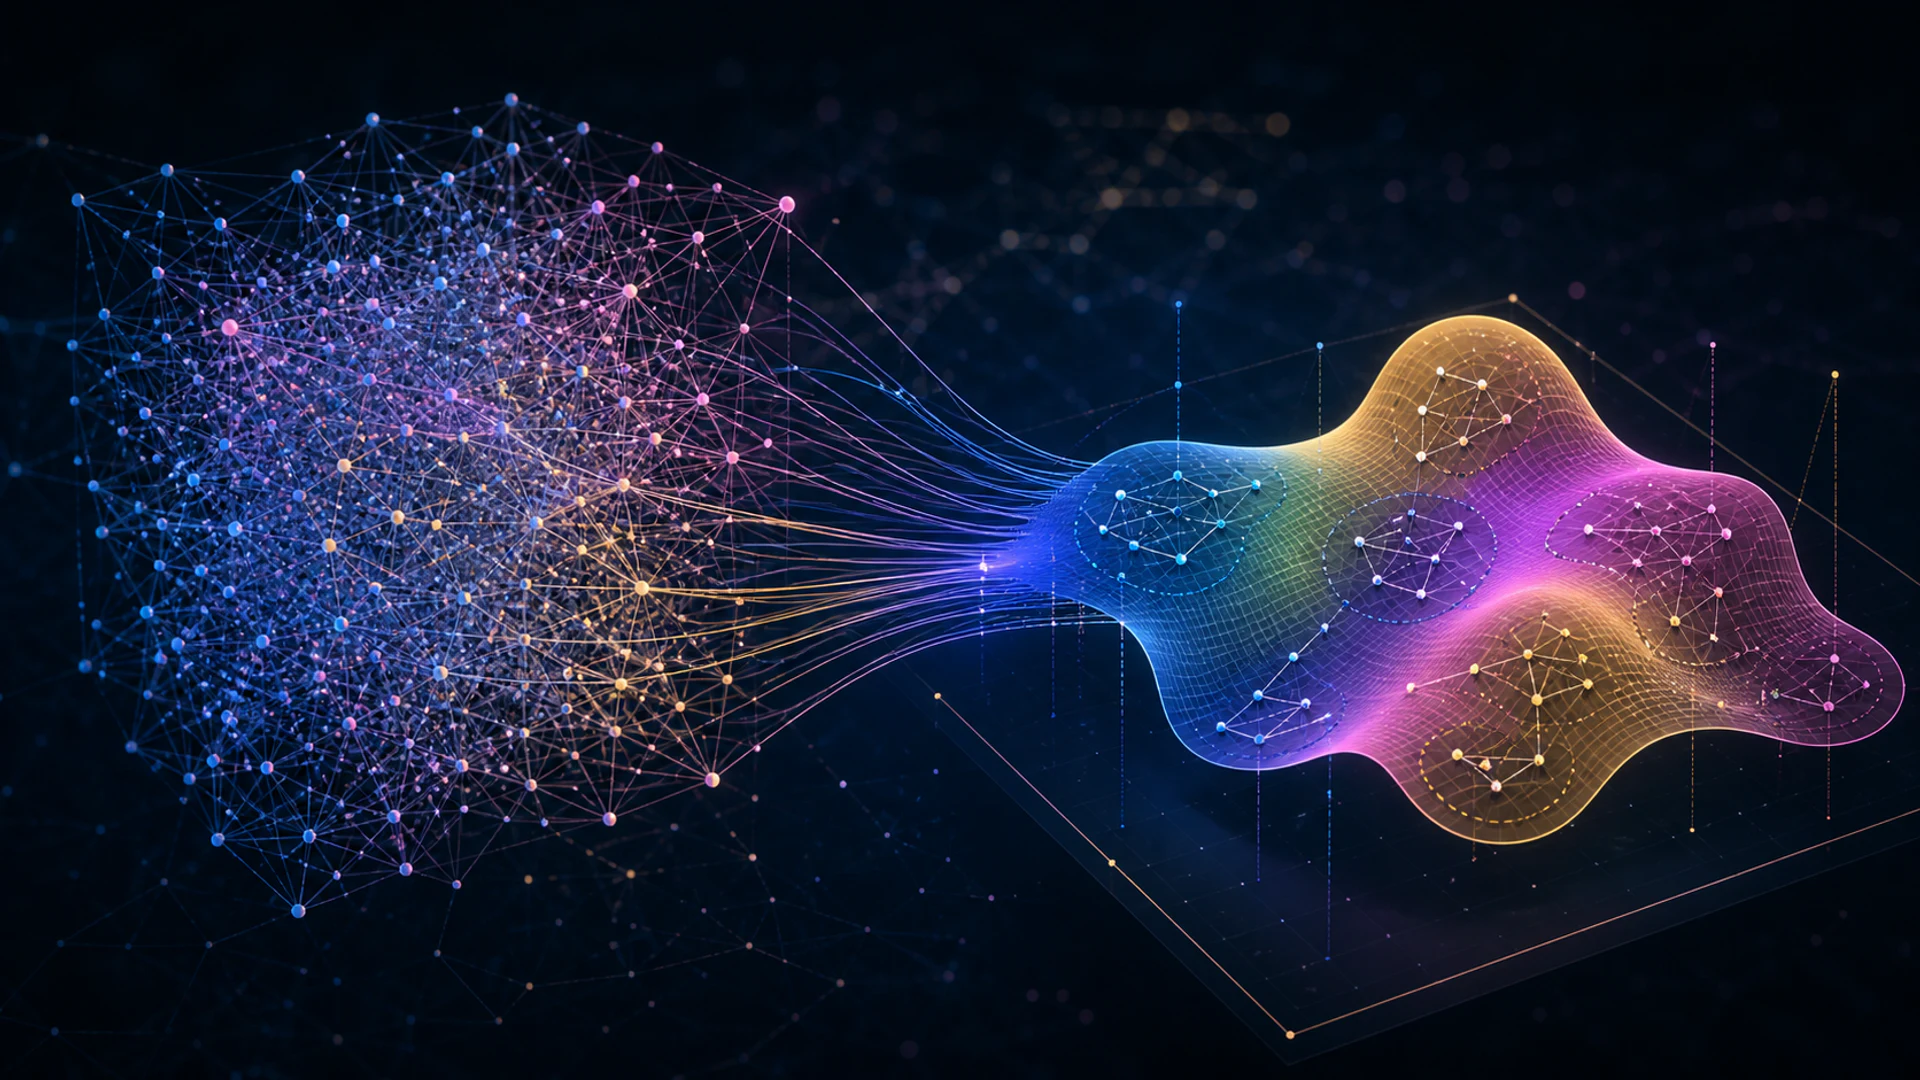
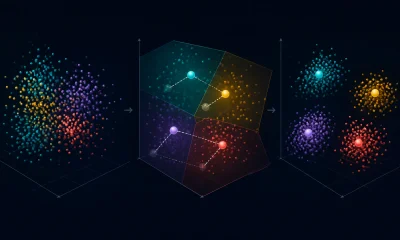
Reducción de dimensionalidad representa los datos con menos variables mientras preserva la información útil para una tarea. Puede reducir el almacenamiento y el ruido, mejorar la visualización, mitigar características redundantes y facilitar el entrenamiento de los modelos posteriores.
No hay ningún método que preserve todas las relaciones. Una reducción útil comienza indicando qué debe conservarse: varianza, separación de clases, vecindades locales, geometría global, calidad de reconstrucción o interpretabilidad.
Puntos clave
- La selección de características conserva las variables originales; la extracción de características crea nuevas coordenadas de menor dimensión.
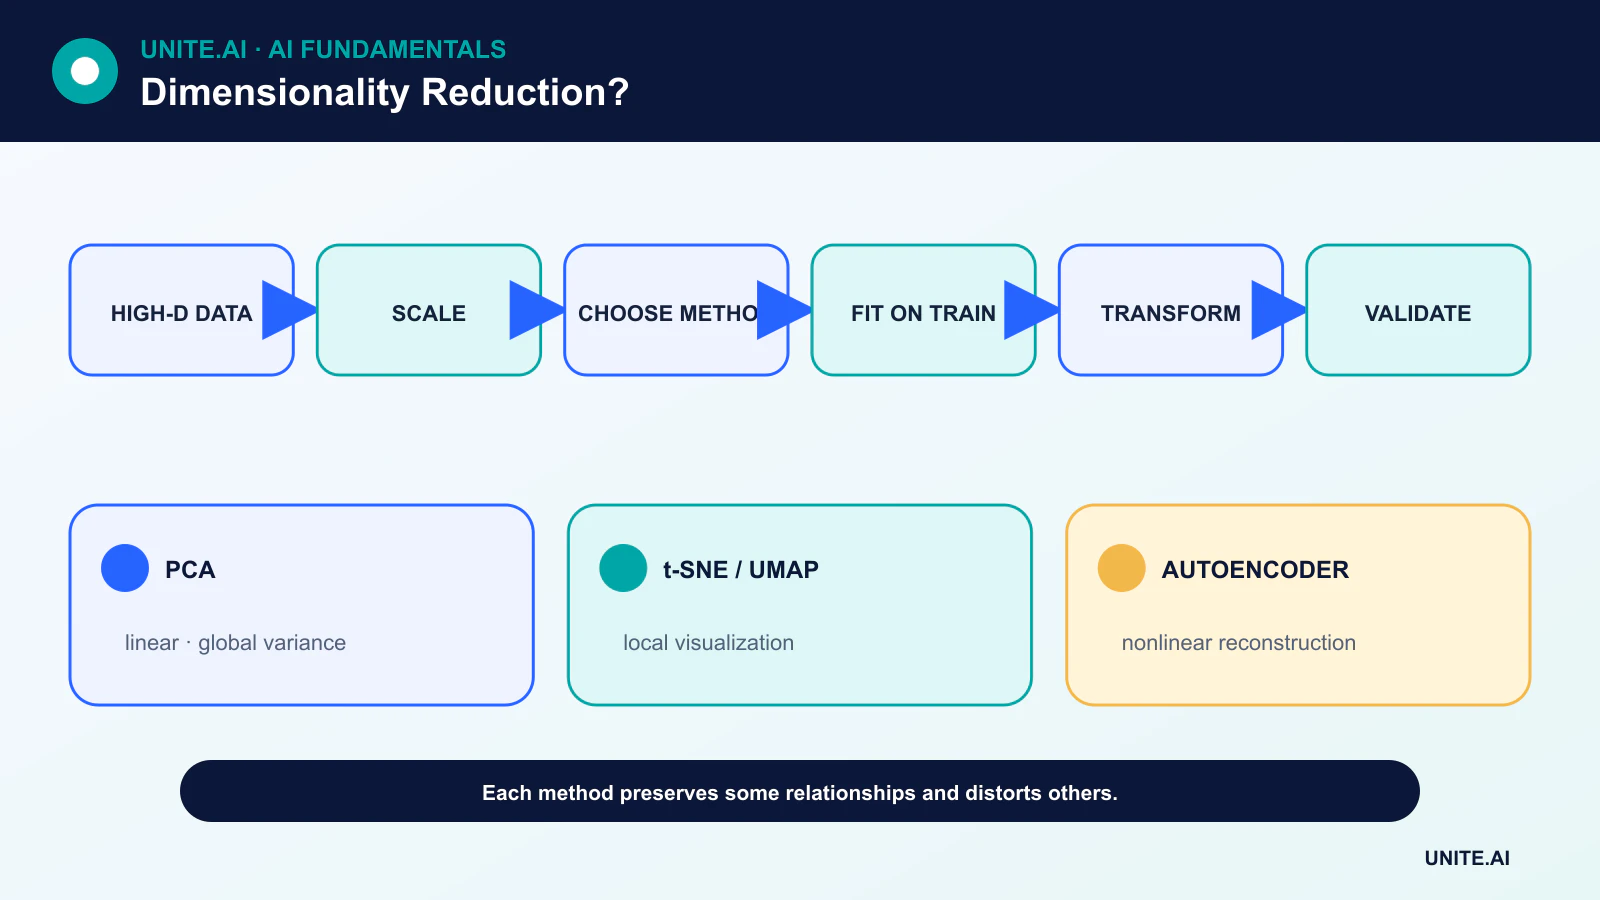
- PCA es lineal y orientado a la varianza; t‑SNE y UMAP enfatizan la estructura de vecindad para la visualización.
- Los embeddings de visualización pueden distorsionar distancias, tamaños de clúster y separación global.
- Ajuste la reducción solo con los datos de entrenamiento y luego aplique la transformación aprendida a los datos de validación y prueba.
Selección de características versus proyección
La selección de características elimina variables mediante reglas de dominio, ausencia de datos, redundancia, pruebas predictivas o regularización. Conserva los significados originales, lo que puede ayudar a la gobernanza y a la explicación.
Los métodos de proyección combinan variables en nuevas coordenadas. Pueden capturar estructuras distribuidas pero pueden dificultar la interpretación de cada coordenada. Un autoencoder aprende una proyección no lineal mediante reconstrucción.
PCA y SVD
El análisis de componentes principales identifica direcciones ortogonales de varianza decreciente después de centrar los datos. La descomposición en valores singulares ofrece una ruta numérica común. La escala es importante: una unidad de medida de alta varianza puede dominar los componentes.
PCA es determinista salvo por el signo y valores propios repetidos, admite transformaciones fuera de muestra y proporciona resúmenes de varianza explicada. La alta varianza no siempre es relevante para la tarea, y los componentes lineales no pueden desplegar todas las variedades curvadas.
t‑SNE y UMAP
t‑SNE construye distribuciones de probabilidad sobre los vecinos y optimiza un mapa de baja dimensión que enfatiza la similitud local. UMAP construye un grafo ponderado de vecindad y optimiza una representación de menor dimensión con objetivos de estructura local relacionados.
Ambos son herramientas exploratorias potentes pero son sensibles al preprocesamiento, la métrica de distancia y los hiperparámetros. El espacio vacío, el área del clúster y la distancia entre clústeres en un gráfico 2D no deben interpretarse automáticamente como representaciones del mundo real.
Métodos supervisados y representaciones conscientes de la tarea
El análisis discriminante lineal utiliza etiquetas de clase para buscar separación, lo que lo diferencia del PCA no supervisado. El aprendizaje de representaciones neuronales puede optimizar objetivos de predicción o contrastivos en lugar de la reconstrucción.
Si las etiquetas guían la reducción, todo el ajuste y la sintonización deben permanecer dentro del proceso de entrenamiento. De lo contrario, la información del conjunto de prueba puede filtrarse en la selección del modelo y generar un resultado optimista.
Elección y validación de un método
Comience con el preprocesamiento y una línea base sencilla. Para compresión, mida la reconstrucción o el rendimiento posterior a través de distintas dimensiones. Para visualización, pruebe la estabilidad con diferentes semillas y hiperparámetros y compare la preservación de vecindades con el conocimiento del dominio.
Para producción, pregunte si el método puede transformar nuevos registros, cómo maneja los valores ausentes, si cambia bajo reentrenamiento y si los usuarios necesitan explicaciones de las características originales. El sobreajuste puede ocurrir en el paso de reducción al igual que en el modelo final.
Métodos de reducción lineales y no lineales
La reducción de dimensionalidad proyecta datos de alta dimensión a menos coordenadas mientras preserva la estructura seleccionada. El análisis de componentes principales encuentra direcciones ortogonales de máxima varianza después de centrar; es necesario escalar cuando las unidades deben contribuir de forma comparable. La descomposición en valores singulares calcula la estructura de bajo rango relacionada y admite matrices dispersas. El análisis discriminante lineal utiliza etiquetas para encontrar direcciones que separen clases. Estos métodos proporcionan transformaciones explícitas, pero la varianza o la separación de clases pueden no conservar la información requerida para una tarea posterior.
Los métodos de variedad, como t‑SNE y UMAP, construyen vecindades y optimizan una disposición de baja dimensión. Son potentes para la exploración pero distorsionan la distancia global, la densidad, el tamaño de los clústeres y, a veces, la separación. Los resultados dependen del preprocesamiento, la métrica, los vecinos o la perplejidad, la inicialización y la semilla. Un clúster atractivo en dos dimensiones puede aparecer incluso sin grupos discretos. Use múltiples configuraciones, coloree solo por metadatos no utilizados en el ajuste y valide la estructura aparente en el espacio original o con etiquetas independientes.
Selección de características, embeddings y evaluación
La selección de características conserva las variables originales mediante filtros, envoltorios o importancia basada en modelos; el aprendizaje de representaciones crea nuevas características latentes usando autoencoders o modelos supervisados. Las proyecciones aleatorias preservan distancias aproximadamente bajo ciertas condiciones y ofrecen líneas base eficientes. Elija el método según compresión, visualización, reducción de ruido, velocidad, almacenamiento o rendimiento del modelo. Ajuste el reductor solo con los datos de entrenamiento y luego transforme los conjuntos de validación y prueba. La reducción supervisada debe anidarse dentro de la validación cruzada para evitar fugas de etiquetas.
Evalúe la varianza explicada o la reconstrucción para compresión lineal, la confiabilidad y preservación de vecindades para visualización, y la precisión, calibración, latencia y robustez posteriores para la predicción. Mida la estabilidad entre muestras y semillas. Verifique si clases raras o grupos sensibles se colapsan y si es posible la mapeo inverso. Las coordenadas reducidas pueden seguir conteniendo información privada; un gráfico bidimensional no es anonimización. Documente la transformación, el escalador, el orden de características y las limitaciones.
Uso en producción
El servicio requiere la transformación ajustada exacta y el esquema de entrada. Supervise características ausentes, cambios de rango, distribución de puntuaciones de componentes, error de reconstrucción y resultados posteriores. Si aparecen nuevas categorías o sensores, reentrene y versiona todo el pipeline en lugar de añadir columnas silenciosamente. La reducción puede mejorar el cómputo y desruir el ruido de un modelo, pero también puede descartar señales débiles importantes para eventos raros. Trátela como un paso de medición aprendido cuya información retenida y perdida debe probarse contra la decisión.
Ejemplo práctico: reducción de características de comportamiento del cliente
Un analista estandariza 200 medidas de comportamiento y ajusta PCA solo con los clientes de entrenamiento. La validación cruzada elige el número de componentes según el rendimiento de churn posterior y la estabilidad, no según un diagrama de dispersión bidimensional. Se inspeccionan las cargas en busca de fuentes dominantes y ausencias. Se comparan PCA, selección de características, proyección aleatoria y un modelo regularizado sin reducción en calibración, latencia y resultados para segmentos de clientes raros. Muestras repetidas también prueban si los componentes principales y las conclusiones posteriores permanecen estables.
El pipeline desplegado fija el orden de características, el escalador y los componentes y rechaza versiones de esquema faltantes. El monitoreo rastrea la distribución de componentes, el error de reconstrucción y los resultados posteriores. Una visualización con clústeres aparentes se usa para generar preguntas, no para asignar personas de cliente. Dado que los componentes latentes aún codifican el comportamiento, el acceso y la retención siguen controlados. Si cambian las definiciones de origen, la transformación completa y el modelo se reconstruyen y validan en lugar de proyectar datos incompatibles en componentes antiguos.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, conserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿La reducción de dimensionalidad siempre mejora un modelo?
No. Puede descartar información predictiva o complicar la interpretación. Compárela con una línea base sin reducción en datos retenidos.
¿Los clústeres separados de t‑SNE demuestran que existen clases reales?
No. El mapa es una visualización optimizada de relaciones de vecindad y puede crear una separación aparente. Valide los clústeres con evidencia independiente.
Referencias principales