Fundamentos de la IA
¿Qué es una Red Generativa Antagónica (GAN)?

 Añade Unite.AI a tus fuentes preferidas en Google
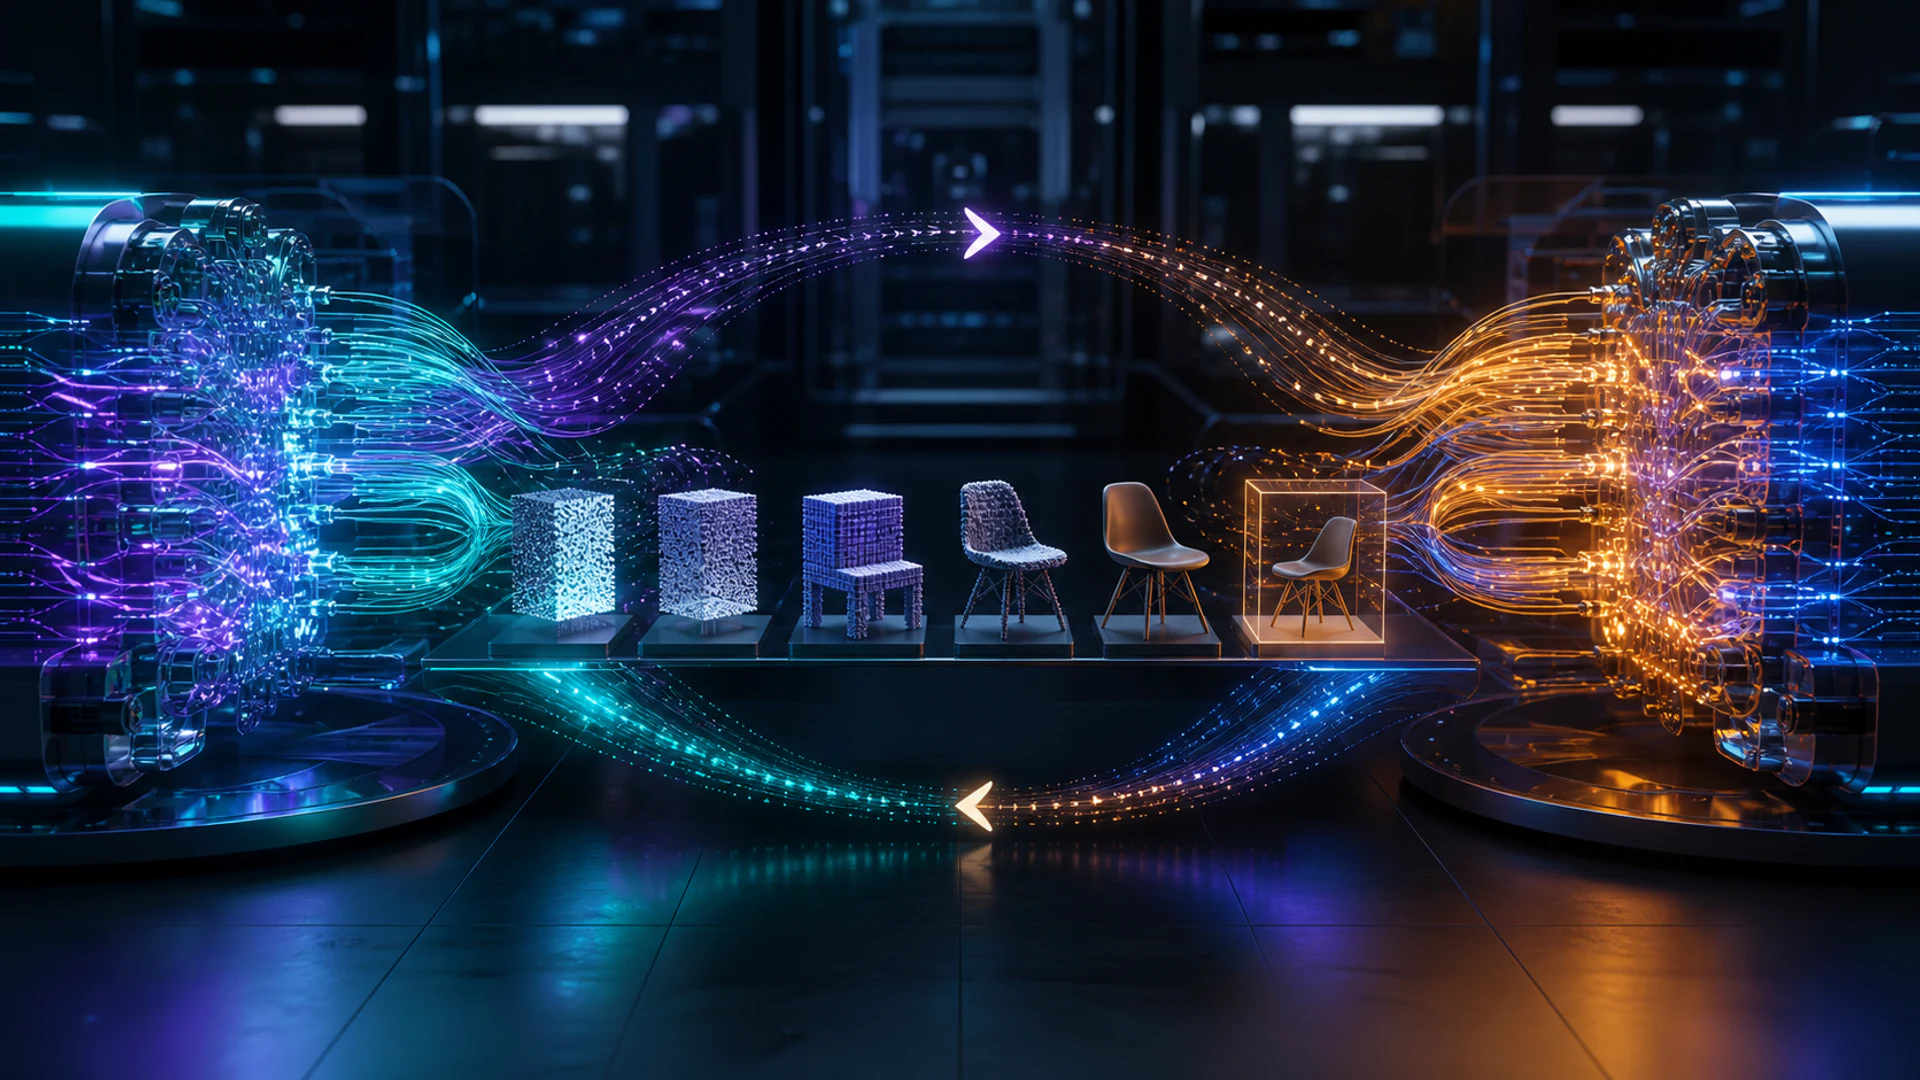
Una red generativa antagónica (GAN) entrena dos redes neuronales en competencia. Un generador convierte una entrada aleatoria o condicionada en muestras sintéticas. Un discriminador intenta distinguir las muestras generadas de los ejemplos reales de entrenamiento. La retroalimentación de cada red modifica el problema de aprendizaje de la otra.
Las GAN pueden crear imágenes nítidas y datos sintéticos controlables, pero el entrenamiento adversario es difícil de estabilizar. El realismo visual no es prueba de diversidad, validez factual o permiso para usar los datos de entrenamiento.
Conclusiones clave
- El generador produce muestras; el discriminador aprende una señal de decisión real vs generado.
- El entrenamiento busca un equilibrio, pero cambiar de oponente puede causar inestabilidad, oscilación o colapso de modo.
- Las GAN condicionales controlan la generación mediante etiquetas, texto u otro contexto.
- La evaluación debe probar fidelidad, cobertura, memorización y riesgo en aplicaciones posteriores, no solo la calidad de la imagen.
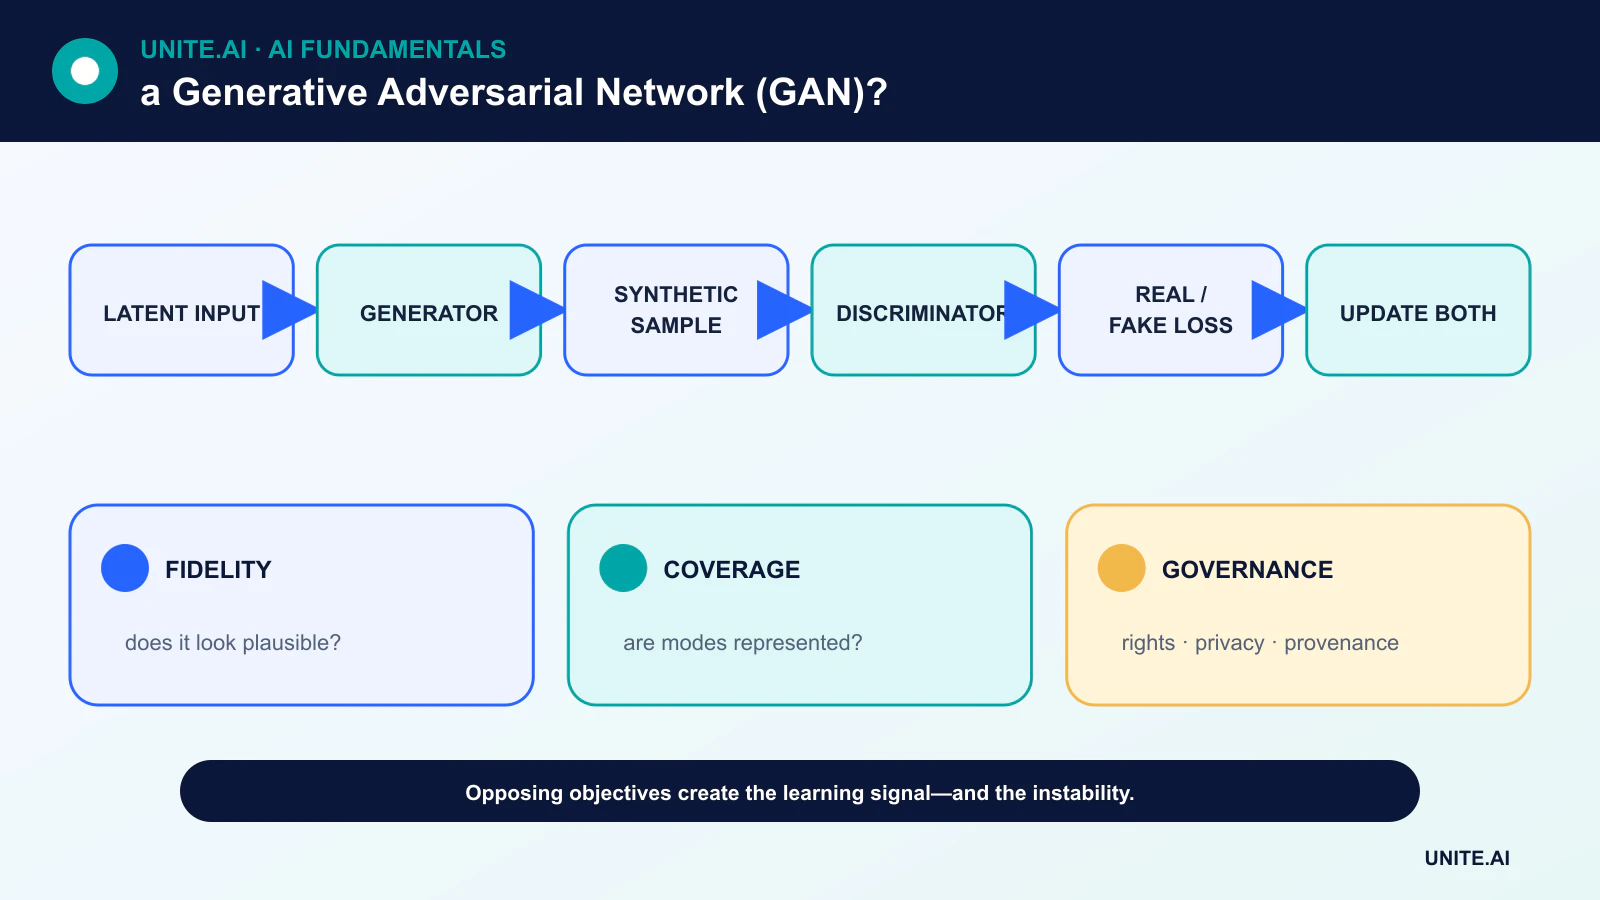
El juego adversario
La formulación original es un juego minimax de dos jugadores. El discriminador mejora en separar datos reales de datos generados, mientras que el generador mejora en crear muestras que el discriminador clasifique como reales. Ambos se entrenan mediante retropropagación.
Si el discriminador se vuelve demasiado preciso, su retroalimentación al generador puede ser poco útil. Si es demasiado débil, el generador puede explotar atajos fáciles. Por lo tanto, el entrenamiento alterna actualizaciones y equilibra cuidadosamente la capacidad, las pérdidas y los ajustes de optimización.
Colapso de modo y estabilidad del entrenamiento
El colapso de modo ocurre cuando muchas entradas latentes producen salidas similares, de modo que las muestras parecen plausibles pero cubren solo una parte de la distribución de datos. Otros fallos incluyen oscilación, gradientes explosivos y sensibilidad a la inicialización aleatoria.
Los objetivos Wasserstein, las penalizaciones de gradiente, la normalización espectral, los cambios de arquitectura y las proporciones de actualización ajustadas pueden mejorar la estabilidad. No eliminan la necesidad de inspeccionar la diversidad y repetir experimentos con múltiples semillas.
Generación condicional y control latente
Una GAN condicional proporciona al generador y al discriminador una etiqueta u otro contexto, permitiendo clases o atributos dirigidos. Las arquitecturas basadas en estilo separan aspectos del control latente en diferentes resoluciones y han producido imágenes altamente realistas.
Las direcciones latentes pueden correlacionarse con conceptos humanos, pero editar un atributo puede cambiar otros porque los datos de entrenamiento contienen características correlacionadas. Las afirmaciones de controlabilidad deben probarse en identidades y contextos diversos.
Evaluación, privacidad y procedencia
Métricas como la Distancia Fréchet Inception comparan distribuciones de características, pero heredan supuestos del modelo de características y pueden pasar por alto la memorización o fallos en subgrupos. El análisis de vecinos más cercanos, pruebas de cobertura al estilo precisión/recuperación y la revisión humana proporcionan evidencia complementaria.
Una GAN puede memorizar ejemplos raros, reproducir sesgos o generar medios engañosos. Los equipos deben documentar los conjuntos de datos, derechos, filtrado, marcas de agua o mecanismos de procedencia y controles de uso indebido. Los datos sintéticos no son automáticamente anónimos.
GAN, VAE y modelos de difusión
Los autoencoders variacionales optimizan un objetivo latente basado en verosimilitud y a menudo sacrifican la nitidez de las muestras por un espacio latente estructurado. Los modelos de difusión aprenden a revertir un proceso de ruido y se han convertido en una base común para la generación de imágenes.
Las GAN siguen siendo útiles cuando importa el muestreo rápido de una sola pasada, mapeos específicos de imagen a imagen o un despliegue compacto. El método adecuado depende de la calidad, diversidad, latencia, estabilidad del entrenamiento y gobernanza, no de cuál arquitectura sea la más reciente.
Objetivos adversarios y dinámica de entrenamiento
Una red generativa antagónica entrena un generador para producir muestras y un discriminador para distinguir lo generado de los datos reales. En el juego minimax original, el discriminador estima una señal relacionada con la razón de densidades y el generador intenta engañarlo. El entrenamiento alterna actualizaciones, de modo que cada red aprende contra un oponente en movimiento en lugar de una pérdida fija. Si el discriminador se vuelve demasiado fuerte, los gradientes del generador pueden ser poco útiles; si es demasiado débil, la calidad de lo generado se estanca. El valor de la pérdida por sí solo no corresponde directamente a la calidad de la muestra.
El colapso de modo ocurre cuando el generador produce variedades limitadas que engañan al discriminador. La oscilación, la sensibilidad a los hiperparámetros y la normalización inestable también son comunes. Los objetivos Wasserstein, las penalizaciones de gradiente, la normalización espectral, la coincidencia de características, las estadísticas de minibatch y los horarios de actualización cuidadosamente equilibrados abordan diferentes mecanismos de falla. Las GAN condicionales usan etiquetas, texto o imágenes para guiar la salida; las arquitecturas basadas en estilo separan influencias latentes. La calidad y cobertura del conjunto de datos siguen siendo fundamentales porque el generador reproduce y recombina la distribución que observa.
Evaluación y uso responsable
Evalúe la fidelidad y la diversidad por separado. La Distancia Fréchet Inception compara distribuciones de características pero depende del tamaño de muestra, modelo de características, preprocesamiento y dominio; la Puntuación Inception omite la comparación con datos reales. La precisión y recuperación para modelos generativos, el análisis de vecinos más cercanos, verificaciones de memorización y la evaluación humana de tareas añaden evidencia. Para síntesis científica o médica, use métricas de dominio y validación posterior. Mantenga un conjunto real reservado y compárelo con bases de difusión o autoregresivas con cómputo y resolución equivalentes.
Las GAN pueden aumentar datos, traducir dominios, super‑resolver imágenes, sintetizar medios y apoyar simulaciones, pero los datos sintéticos pueden amplificar sesgos o filtrar ejemplos de entrenamiento. Verifique licencias, consentimiento, identidad y procedencia. Proteja contra la suplantación no consensuada y el uso engañoso, etiquete o firme los resultados cuando corresponda y conserve los metadatos de generación. Una imagen fotorrealista no es evidencia documental; la incertidumbre y el origen sintético deben permanecer visibles cuando los resultados influyen en decisiones.
Despliegue y reproducibilidad
Registre el generador, discriminador, optimizador, conjunto de datos, semilla aleatoria, truncamiento y configuraciones de muestreo. La cuantización o exportación pueden alterar la normalización y la salida, por lo que se debe validar el artefacto de servicio. Supervise la distribución de indicaciones o condiciones, filtros de seguridad, diversidad de salida, latencia e informes. Use límites de velocidad y salvaguardas de identidad en sistemas públicos. El entrenamiento de una GAN es un experimento de optimización acoplada: las imágenes de muestra seleccionadas no pueden establecer robustez, cobertura o ausencia de memorización, y un modelo debe evaluarse sobre la distribución completa de las tareas de generación previstas.
Ejemplo práctico: imágenes sintéticas de defectos con una GAN
Un fabricante entrena una GAN condicional para crear imágenes raras de defectos superficiales. Verifica que las imágenes de entrenamiento tengan derechos y separa los lotes de producción antes del entrenamiento y la evaluación. Las muestras generadas se revisan en busca de memorización de vecinos más cercanos, geometría del defecto, artefactos de fondo, diversidad y plausibilidad experta. Un clasificador entrenado con aumento sintético se evalúa solo con defectos reales independientes, comparado con el mismo clasificador con aumento convencional.
Los datos sintéticos se aceptan solo si el recall en el mundo real mejora sin aumentar los rechazos falsos o errores en subgrupos. Los ajustes de generación y la procedencia permanecen adjuntos a cada imagen, y los archivos sintéticos nunca ingresan al conjunto de prueba o al archivo de evidencia como inspecciones reales. Los operadores no pueden usar el generador para fabricar registros de auditoría. El equipo compara alternativas de difusión y el costo de recopilar más ejemplos reales, reconociendo que una apariencia realista no prueba que la GAN haya capturado el proceso físico de falla.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, responsable y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, uso indebido y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retrocesos y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿Entiende una GAN las imágenes que crea?
Una GAN aprende la estructura estadística útil para la generación. Eso no establece por sí mismo una comprensión semántica o causal similar a la humana.
¿Son seguras las muestras generadas por una GAN para usarlas como datos de entrenamiento?
Solo después de verificar la cobertura, la validez de las etiquetas, la memorización, el sesgo y si la distribución sintética ayuda en un conjunto de prueba real reservado.
Referencias principales