
Fundamentos de la IA
¿Qué es el aprendizaje de pocos ejemplos?

 Añade Unite.AI a tus fuentes preferidas en Google
Few-shot learning estudia cómo un modelo puede adaptarse a una nueva tarea o clase a partir de solo un pequeño número de ejemplos etiquetados. En los benchmarks clásicos, un episodio proporciona un conjunto de soporte —por ejemplo, cinco clases con uno o cinco ejemplos por clase— y pide al modelo que clasifique consultas no vistas.
El término también se emplea para el aprendizaje en contexto, donde un modelo de lenguaje preentrenado recibe algunas demostraciones en su prompt sin actualizar sus parámetros. Estos escenarios comparten el objetivo de usar pocos ejemplos, pero emplean diferentes mecanismos de adaptación y requieren diseños de evaluación distintos.
Puntos clave
- N-way K-shot describe N clases y K ejemplos de soporte etiquetados por clase.
- Los métodos de aprendizaje métrico comparan consultas con representaciones aprendidas de los ejemplos de soporte.
- El meta‑aprendizaje optimiza a través de muchas tareas para que una nueva tarea pueda aprenderse rápidamente.
- Pocos ejemplos amplifican los errores de etiquetado, la filtración, la ambigüedad de clases y la incertidumbre, por lo que las líneas base y la información de confianza son importantes.
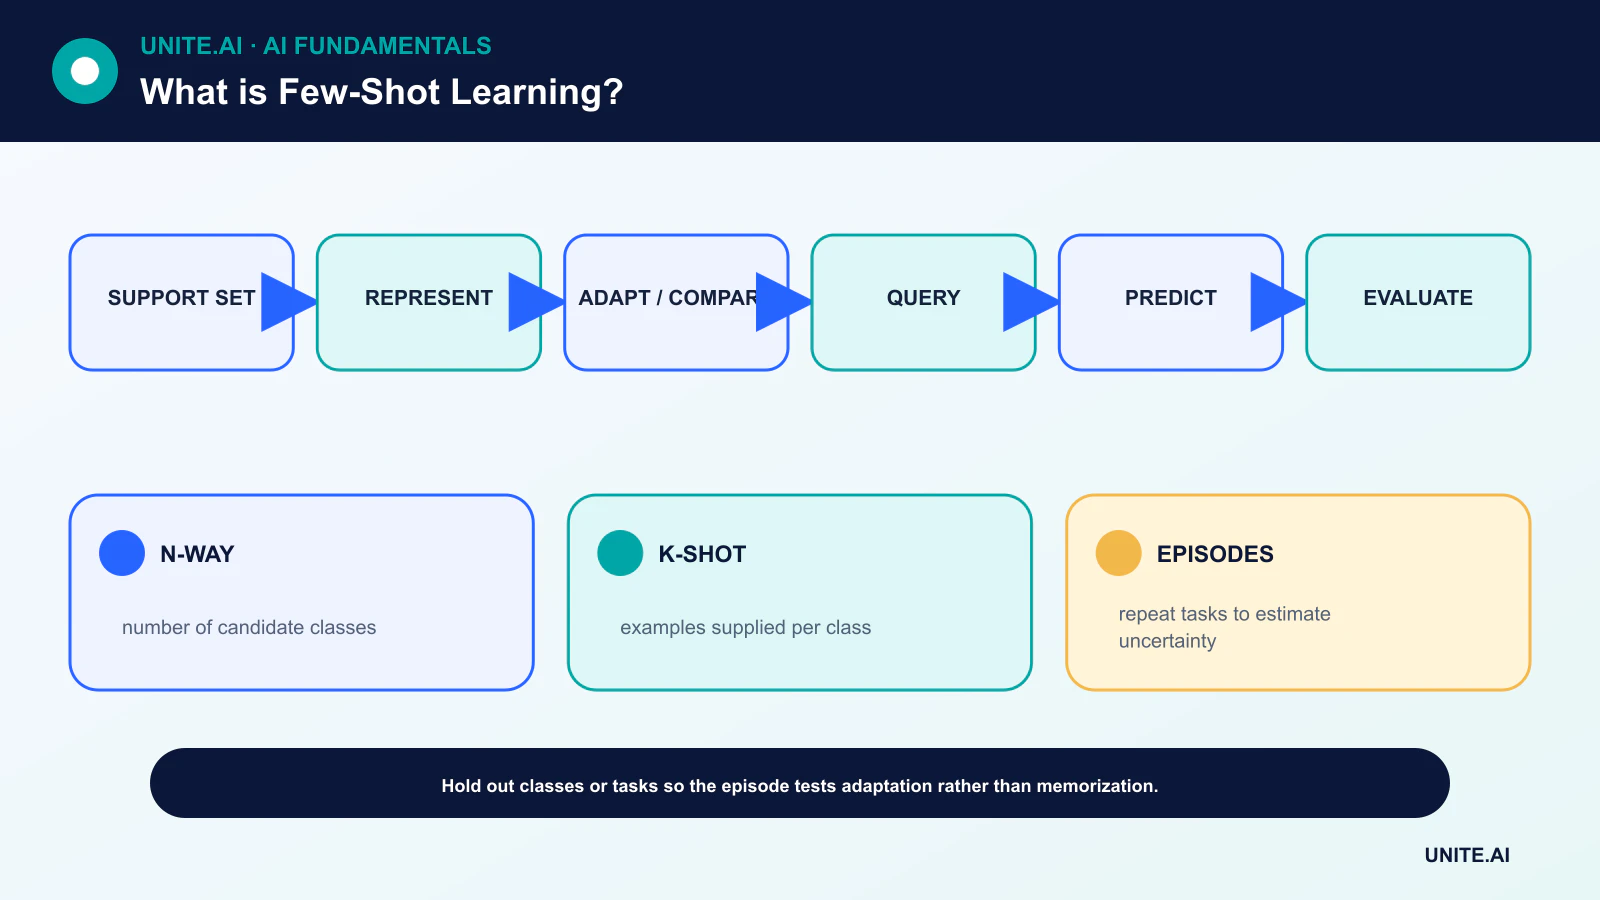
Episodios, conjuntos de soporte y conjuntos de consulta
Un episodio few-shot separa un pequeño conjunto de soporte etiquetado del conjunto de consulta utilizado para la evaluación. Durante el meta‑entrenamiento, el modelo observa muchos de estos episodios. Una evaluación rigurosa retiene clases, tareas o dominios completos, de modo que el episodio de prueba mida la adaptación y no la memorización.
Informe las distribuciones de exactitud a lo largo de muchos episodios en lugar de una única muestra conveniente. Compare con líneas base simples de vecino más cercano y lineales; un método sofisticado que no supere una representación bien entrenada más un clasificador básico puede no justificar su complejidad.
Aprendizaje métrico y prototipos
Las redes de coincidencia (matching networks) y métodos relacionados incrustan los ejemplos de soporte y de consulta en un espacio donde los vectores cercanos deben compartir la misma etiqueta. Las redes prototípicas promedian las incrustaciones de soporte para cada clase y clasifican una consulta según la distancia a esos prototipos de clase.
Esto vincula el aprendizaje few-shot con la calidad de la representación. Un modelo preentrenado de aprendizaje profundo puede ya organizar bien las características relevantes, mientras que una representación inadecuada puede hacer que cada distancia sea engañosa.
Meta‑aprendizaje basado en optimización
Model-Agnostic Meta-Learning (MAML) busca parámetros que puedan adaptarse con un pequeño número de pasos de gradiente. Otros métodos aprenden un optimizador, una inicialización o una regla de actualización de parámetros. El bucle externo evalúa el rendimiento después de la adaptación en distintas tareas.
El meta‑aprendizaje asume que una estructura útil se comparte entre las tareas de entrenamiento y las de destino. Cuando la distribución objetivo difiere drásticamente, la adaptación rápida puede fallar. La validación debe variar el número de disparos, clases, dominios y la dificultad de la tarea, en lugar de considerar un único benchmark como universal.
Aprendizaje por transferencia y estrategias a nivel de datos
El aprendizaje por transferencia suele ser el punto de partida práctico más sólido: congelar un codificador preentrenado, entrenar una pequeña cabeza y luego ajustar finamente de forma selectiva si existen suficientes datos. La augmentación de datos puede introducir invariancias, pero ejemplos sintéticos poco realistas pueden amplificar sesgos o crear atajos.
El aprendizaje activo puede priorizar qué ejemplos etiquetar, mientras que el aprendizaje semisupervisado puede usar datos no etiquetados adicionales. Estas son estrategias complementarias, no sinónimos del aprendizaje few-shot.
El prompting few-shot es diferente
Un transformer puede inferir un patrón a partir de demostraciones colocadas en su contexto. No se requiere una actualización persistente de parámetros. El orden, la redacción y el equilibrio de etiquetas pueden cambiar materialmente la salida, y los ejemplos pueden consumir una gran parte de la ventana de contexto.
Utilice un conjunto de evaluación representativo, versiona cada prompt y demostración, y pruebe alternativas zero-shot, few-shot y con ajuste fino. Un conjunto de soporte diminuto no respalda afirmaciones sólidas a nivel poblacional, especialmente en casos raros o críticos para la seguridad.
Paradigmas de aprendizaje few-shot y construcción de tareas
El aprendizaje few-shot busca ejecutar una tarea a partir de muy pocos ejemplos etiquetados. En los métodos basados en métricas, un codificador mapea los ejemplos a un espacio donde los prototipos o vecinos más cercanos representan las clases. El meta‑aprendizaje basado en optimización entrena una inicialización o regla de actualización para una adaptación rápida. El aprendizaje por transferencia ajusta finamente un modelo preentrenado sobre un conjunto objetivo pequeño. El aprendizaje en contexto suministra ejemplos en un prompt sin actualizar los pesos. Estos mecanismos difieren, por lo que las afirmaciones deben especificar si los parámetros cambian, qué entrenamiento previo se realizó y cómo se seleccionan los ejemplos.
La evaluación debe separar las clases, tareas, sujetos o dominios de entrenamiento y prueba de acuerdo con la generalización reclamada. Un episodio N‑way K‑shot contiene N clases y K ejemplos de soporte por clase, más ejemplos de consulta para la puntuación. Los episodios repetidos estiman la varianza de la selección de soporte. Para el prompting, el orden de los ejemplos, la redacción de las etiquetas, el formato y la similitud de la demostración pueden cambiar materialmente los resultados. Compare con líneas base zero-shot, vecino más cercano, linear‑probe y ajuste fino ordinario usando la misma representación y presupuesto de datos.
Calidad de datos, incertidumbre y transferencia negativa
Con pocos ejemplos, los casos mal etiquetados o atípicos tienen una influencia desproporcionada. Defina reglas de anotación, inspeccione cada elemento de soporte y preserve una opción de desconocido o abstención. La augmentación de datos y los ejemplos sintéticos solo pueden ayudar cuando preservan la tarea y añaden variaciones realistas. Un modelo preentrenado puede transferir atajos o sesgos de su dominio de origen. Pruebe casos fuera de dominio, grupos raros y la sensibilidad a la eliminación de un ejemplo de soporte. Informe intervalos de confianza a lo largo de tareas y semillas aleatorias, no un único prompt favorable.
El aprendizaje activo puede solicitar etiquetas en casos informativos, mientras que los métodos semisupervisados usan datos no etiquetados bajo supuestos adicionales. La recuperación puede seleccionar demostraciones relevantes de forma dinámica, pero debe evitar la filtración de etiquetas de prueba. La adaptación puede sobreajustarse rápidamente, por lo que se deben limitar las actualizaciones, usar regularización y validar con ejemplos separados. Para tareas de alto riesgo, unos pocos etiquetas rara vez justifican decisiones autónomas; utilice el modelo para priorizar o asistir la revisión hasta que exista evidencia suficiente del resultado.
Operación en producción
Versione el modelo base, la incrustación o la plantilla de prompt, las demostraciones, el esquema de etiquetas y los parámetros de adaptación. Proteja los ejemplos porque los prompts o gradientes pueden exponer registros sensibles. Supervise el rendimiento a medida que cambian las clases y el lenguaje, y renueve los ejemplos de soporte mediante una revisión gobernada en lugar de etiquetado automático. El aprendizaje few-shot reduce la necesidad de datos etiquetados del objetivo al explotar la estructura previa; no elimina la necesidad de una evaluación representativa, una definición cuidadosa de la tarea, experiencia de dominio o un mecanismo de respaldo seguro cuando la nueva tarea está fuera de ese conocimiento previo.
Ejemplo práctico: clasificación few-shot para un nuevo producto
Un equipo de soporte necesita etiquetas de enrutamiento para un producto con solo cinco ejemplos revisados por incidencia. Compara los prototipos más cercanos en una incrustación preentrenada, una cabeza lineal, ajuste fino eficiente en parámetros y prompting en contexto. Las familias de productos, los clientes y los mensajes posteriores se excluyen del meta‑entrenamiento y de la selección del modelo. El muestreo repetido del conjunto de soporte informa la recuperación por clase, la calibración, la varianza y la sensibilidad a una demostración mal etiquetada.
Los mensajes de baja confianza y sin soporte se dirigen al soporte general, y los revisores corrigen las etiquetas mediante una cola gobernada. Los ejemplos se desidentifican, versionan y nunca se seleccionan del conjunto de prueba final. El monitoreo rastrea nuevo vocabulario, tasas de clase, correcciones y desacuerdos. Cuando se acumulan suficientes etiquetas, el sistema few-shot se compara con el entrenamiento supervisado ordinario. La configuración rápida es útil, pero no justifica la automatización si el rendimiento sigue siendo inestable o si el nuevo producto difiere sustancialmente de las familias de tareas previas.
Evidence de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallas de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retrocesos y retiros. Use un despliegue por etapas, preserve un mecanismo de respaldo seguro y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita documentación orientada a los datos de preentrenamiento, tareas relacionadas, representaciones y suposiciones. Las etiquetas objetivo son pocas; la historia total de aprendizaje suele ser grande. Referencias principales: Vinyals et al.: Matching Networks for One Shot Learning; Snell et al.: Prototypical Networks for Few-shot Learning; Finn et al.: Model-Agnostic Meta-Learning.
Preguntas frecuentes
¿El aprendizaje one-shot es lo mismo que el aprendizaje few-shot?
El aprendizaje one-shot es el caso especial con un ejemplo de soporte etiquetado por clase o tarea. El aprendizaje zero-shot no utiliza ejemplos etiquetados del objetivo.
¿El aprendizaje few-shot elimina la necesidad de datos?
No. Desplaza la dependencia hacia los datos de preentrenamiento, tareas relacionadas, representaciones y suposiciones. Las etiquetas objetivo son pocas; la historia total de aprendizaje suele ser grande.
Referencias principales












