Fundamentos de la IA
Modelos de aprendizaje automático listos para usar vs. personalizados

 Añade Unite.AI a tus fuentes preferidas en Google
Elegir una solución de aprendizaje automático rara vez es una decisión simple de comprar o construir. El verdadero continuo va desde una API alojada o un modelo empaquetado, pasando por el prompting, la recuperación y el ajuste fino, hasta una arquitectura totalmente personalizada entrenada con datos específicos de la organización.
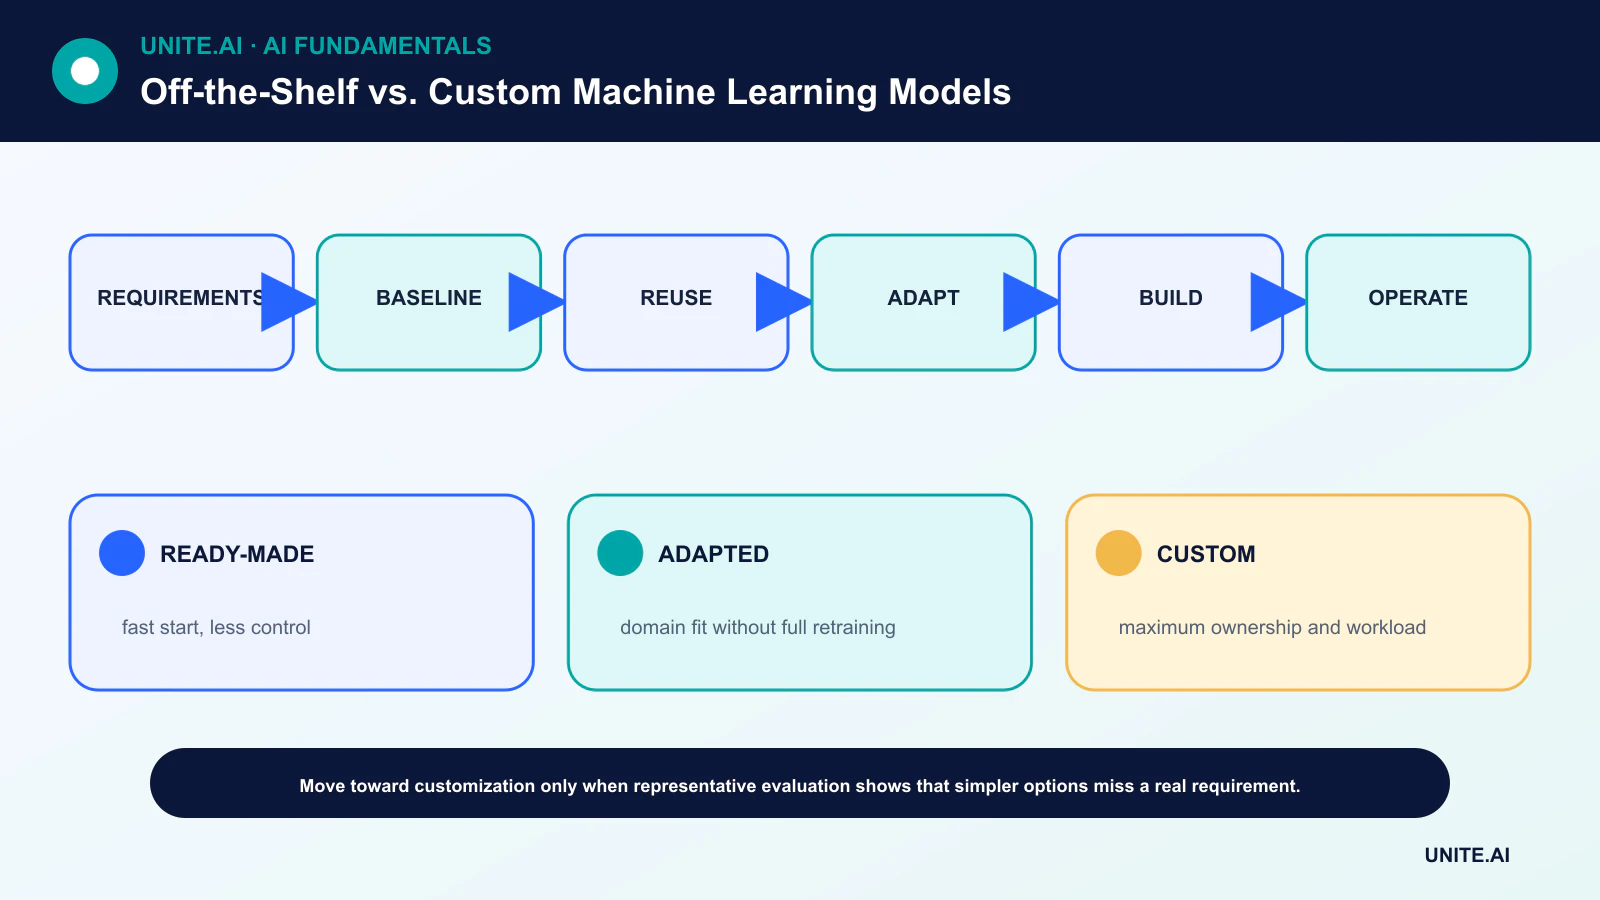
La mejor opción es el enfoque menos complejo que cumpla con un requisito de producto verificado. Un modelo personalizado puede aportar control y diferenciación, pero también genera una obligación continua de gestionar canalizaciones de datos, evaluaciones, monitorización, seguridad, actualizaciones y retrocesos.
Puntos clave
- Comience con una tarea medible, una línea base sin ML y umbrales de aceptación.
- Evalúe los modelos candidatos con datos privados representativos en lugar de basarse únicamente en puntuaciones de benchmarks públicos.
- Incluya los costos de integración, latencia, revisión, reentrenamiento e incidentes en el costo total de propiedad.
- Prefiera etapas reversibles: línea base, recuperación o prompt, ajuste fino, y solo entrenar desde cero cuando la evidencia lo respalde.
Defina la decisión antes de elegir un modelo
Especifique el usuario, la decisión, la entrada, la salida, los costos de error, el presupuesto de latencia, el patrón de tráfico y la ruta de escalamiento. Determine si una regla determinista o un sistema de búsqueda resuelve suficiente del problema. Las Reglas de ML de Google recomiendan líneas base simples y una infraestructura confiable antes de modelado complejo.
Cree un conjunto de evaluación offline que refleje la producción, incluyendo casos raros y adversarios. Cuando las decisiones afectan a personas, defina verificaciones por subgrupos y reglas de revisión humana. Estas barreras hacen que las comparaciones sean concretas en lugar de convertir la elección de arquitectura en una preferencia.
El continuo de reutilización y adaptación
Una API alojada ofrece integración rápida y escalado gestionado, pero con control limitado sobre los internos del modelo, versiones y manejo de datos. Un modelo preentrenado abierto incrementa el control del despliegue. La recuperación o el prompt engineering pueden añadir contexto del dominio sin modificar los pesos.
El ajuste fino o los adaptadores de eficiencia paramétrica pueden especializar el comportamiento. Entrenar desde cero solo está justificado cuando los datos, el objetivo, la escala o el requisito de propiedad no pueden cumplirse mediante reutilización. El aprendizaje por transferencia a menudo captura la mayor parte del valor con considerablemente menos datos y cómputo.
Calidad, control y bloqueo
Mida la calidad de la tarea, la calibración, la latencia, el rendimiento, la disponibilidad y la consistencia de fallos. Un modelo de proveedor puede mejorar automáticamente, pero también puede cambiar su comportamiento; un modelo autoalojado puede quedar fijado, pero requiere que el equipo gestione actualizaciones y vulnerabilidades.
Los términos contractuales deben abordar la retención de datos, el uso del entrenamiento, el procesamiento regional, la propiedad intelectual, los niveles de servicio, las rutas de exportación y la depreciación. La portabilidad mejora cuando la aplicación separa los adaptadores específicos del modelo de la lógica de negocio y almacena artefactos de evaluación reproducibles.
Privacidad, seguridad y operaciones
Mapee cada flujo de datos y límite de amenaza. Las entradas sensibles pueden requerir redes privadas, inferencia on‑premise o edge AI. Autoalojar no hace automáticamente que un sistema sea seguro; transfiere la responsabilidad de seguridad y cumplimiento al operador.
La propiedad de la producción incluye observabilidad, verificaciones de deriva, monitorización de abusos, respuesta a incidentes y retroceso. El equipo operativo debe poder responder qué modelo, prompt, versión de datos y política generaron un resultado.
Utilice evidencia por etapas, no ideología
Ejecute un benchmark limitado en tiempo con el mismo conjunto de datos y criterios de aceptación entre opciones. Estime el tiempo de ingeniería, la anotación, el uso de aceleradores, las tarifas del proveedor, la mano de obra de revisión, los costos de fallos y la cadencia esperada de cambios.
Elija el candidato más simple que supere las barreras, y luego reevalúe a medida que cambien los requisitos o los precios. La personalización es valiosa cuando produce un beneficio medido o un control necesario, no simplemente porque un modelo a medida suene estratégicamente importante.
Requisitos y comparación de costo total
Un modelo listo para usar, una API o un sistema empaquetado brinda capacidad preconstruida con soporte del proveedor y un despliegue inicial más rápido. Un modelo personalizado se entrena o adapta sustancialmente para una tarea, datos y entorno operativo específicos. La elección comienza con los requisitos: resultado objetivo, calidad por subgrupo y caso límite, latencia, rendimiento, disponibilidad, explicabilidad, residencia de datos, control de actualizaciones, integración, seguridad y consecuencia de fallos. Un benchmark genérico o una demostración no pueden responder si un producto cumple esos requisitos.
El costo total incluye evaluación, preparación de datos, etiquetado, integración, licencias o uso, infraestructura, monitorización, revisión, respuesta a incidentes, actualizaciones y salida. Lo listo para usar reduce la ingeniería inicial, pero puede generar costos variables, bloqueo, cambios de comportamiento y observabilidad limitada. El desarrollo personalizado añade responsabilidad de datos y MLOps y aún puede depender de pesos preentrenados y proveedores. El costo del modelo debe medirse por tarea exitosa a la calidad requerida, no por token o ejecución de entrenamiento únicamente.
Evaluación, adquisición y adaptación
Construya un conjunto de pruebas privado representativo antes de la selección del proveedor y ejecute cada candidato bajo prompts idénticos, preprocesamiento, umbrales y límites operativos. Incluya casos ambiguos, adversarios, no soportados, multilingües y de alta consecuencia. Mida precisión, calibración, latencia, costo, rechazo, seguridad y el impacto en el flujo de trabajo humano. Pruebe interrupciones de la API, límites de velocidad, comportamiento regional y cambios de versión. Las afirmaciones del proveedor requieren documentación sobre entrenamiento, derechos, privacidad, retención, subprocesadores, seguridad, soporte y notificación de incidentes.
Las opciones de adaptación forman un espectro: configuración, recuperación, prompting, ajuste fino, actualizaciones de eficiencia paramétrica, cabezas personalizadas o entrenamiento desde cero. Use el método menos complejo que cumpla con la evidencia. La recuperación es apropiada para conocimientos que cambian con frecuencia; el ajuste puede moldear el formato o comportamiento del dominio; el código determinista debe manejar reglas exactas. Valide los sistemas combinados porque un modelo base sólido aún puede fallar por una recuperación deficiente, permisos o integración.
Ciclo de vida y planificación de salida
Los productos alojados pueden cambiar o desaparecer, mientras que los modelos personalizados se convierten en deuda técnica sin propietarios. Supervise dependencias de versiones, comportamiento y resultados, defina disparadores de reentrenamiento o reevaluación, y mantenga retrocesos. Preserve los datos e interfaces necesarios para migrar, negocie la eliminación y exportación, y evite exponer el esquema propietario de un proveedor en toda la aplicación. La mejor opción puede ser híbrida: capacidad comercial para tareas comunes y componentes personalizados donde el rendimiento del dominio, el control o el riesgo generan valor duradero.
Ejemplo práctico: elegir un modelo de extracción de documentos
Una empresa crea un conjunto de pruebas privado de facturas de distintos proveedores, idiomas, escaneos, escritura a mano y casos límite, y luego compara una API gestionada, un modelo preentrenado abierto, un modelo adaptado y una línea base de reglas. Puntúa la precisión de campos, error monetario, documentos no soportados, latencia, rendimiento, privacidad, residencia, integración y costo por factura procesada correctamente. Las demostraciones de proveedores y los benchmarks públicos no sustituyen esta evaluación pareada.
El híbrido seleccionado utiliza un servicio comercial de OCR con validación local y revisión humana para baja confianza o montos altos. Los contratos definen retención, subprocesadores, actualizaciones y eliminación; la arquitectura preserva los archivos fuente y una ruta de salida. Un período sombra detecta brechas de esquema y proveedores. La monitorización separa OCR, extracción, validación y correcciones de revisores. Si el comportamiento del proveedor cambia, el equipo puede congelar, cambiar o trasladar más trabajo a su componente personalizado sin reescribir el flujo financiero.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada fallo importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes del ajuste. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retrocesos y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, y luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Cuándo debería un equipo entrenar un modelo desde cero?
Cuando las opciones preentrenadas o alojadas no pueden cumplir los requisitos validados y el equipo dispone de datos propietarios suficientes, capacidad de cómputo, experiencia y capacidad operativa a largo plazo.
¿Un modelo listo para usar está libre de mantenimiento?
No. La integración, evaluación, cambios de versión, monitorización, controles de privacidad y el comportamiento de respaldo siguen siendo responsabilidad del adoptante.
Referencias principales