Fundamentos de la IA
¿Qué es la IA generativa?

 Añade Unite.AI a tus fuentes preferidas en Google
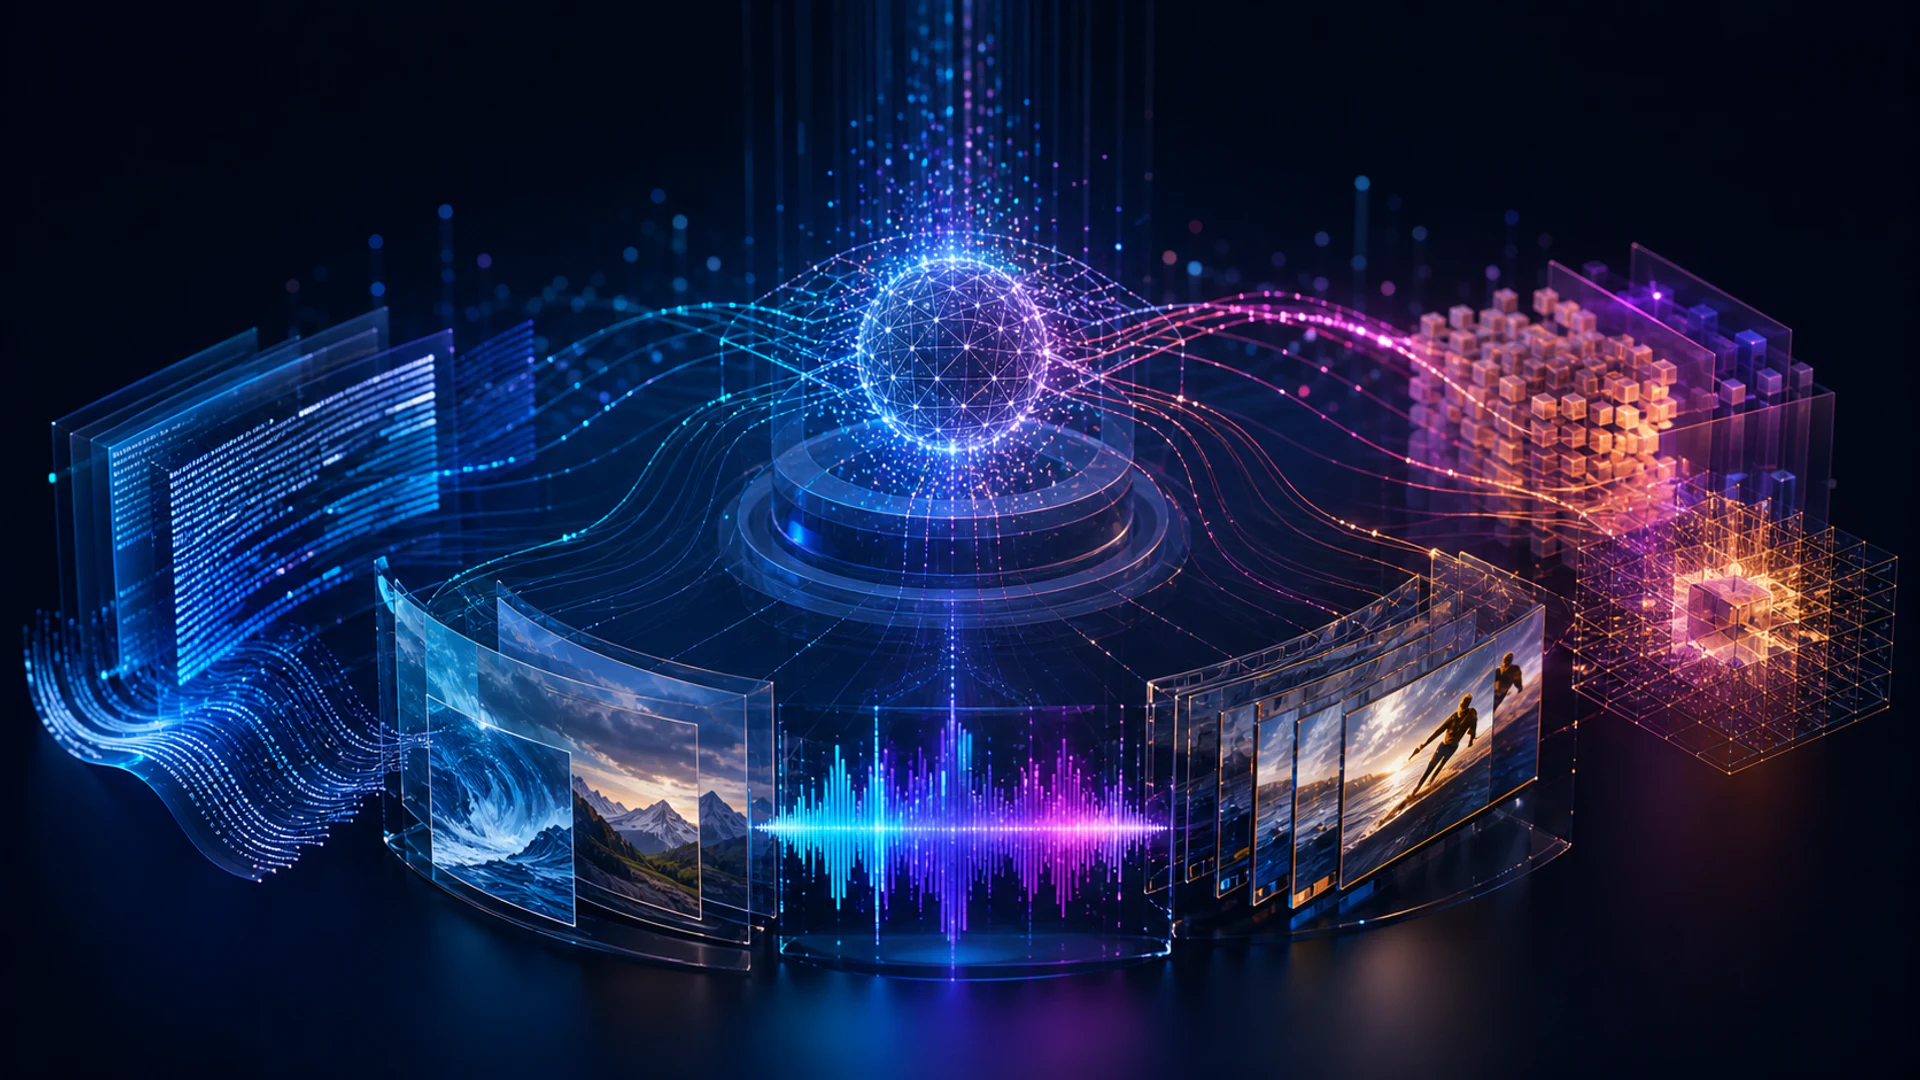
Generative AI se refiere a los modelos que aprenden patrones en los datos y producen texto, imágenes, audio, video, código u otras representaciones nuevas cuando se condicionan con instrucciones o ejemplos. La salida se sintetiza a partir de un modelo de probabilidad; no se recupera íntegra de una base de datos, aunque las herramientas de recuperación pueden proporcionar evidencia externa.
Diferentes familias de modelos generan de distintas maneras. Los transformadores autoregresivos predicen una secuencia token por token, los modelos de difusión desruiden iterativamente una muestra, y las redes generativas adversarias aprenden mediante un concurso entre un generador y un discriminador.
Conclusiones clave
- La generación es muestreo condicional a partir de una distribución aprendida, no garantiza la recuperación factual.
- Los transformadores, los modelos de difusión, los GAN y los autoencoders variacionales presentan diferentes compensaciones.
- La recuperación y las herramientas pueden fundamentar un sistema, pero sus salidas y permisos aún requieren validación.
- La gestión de riesgos abarca datos, modelo, interfaz, despliegue, monitoreo y la procedencia del contenido.
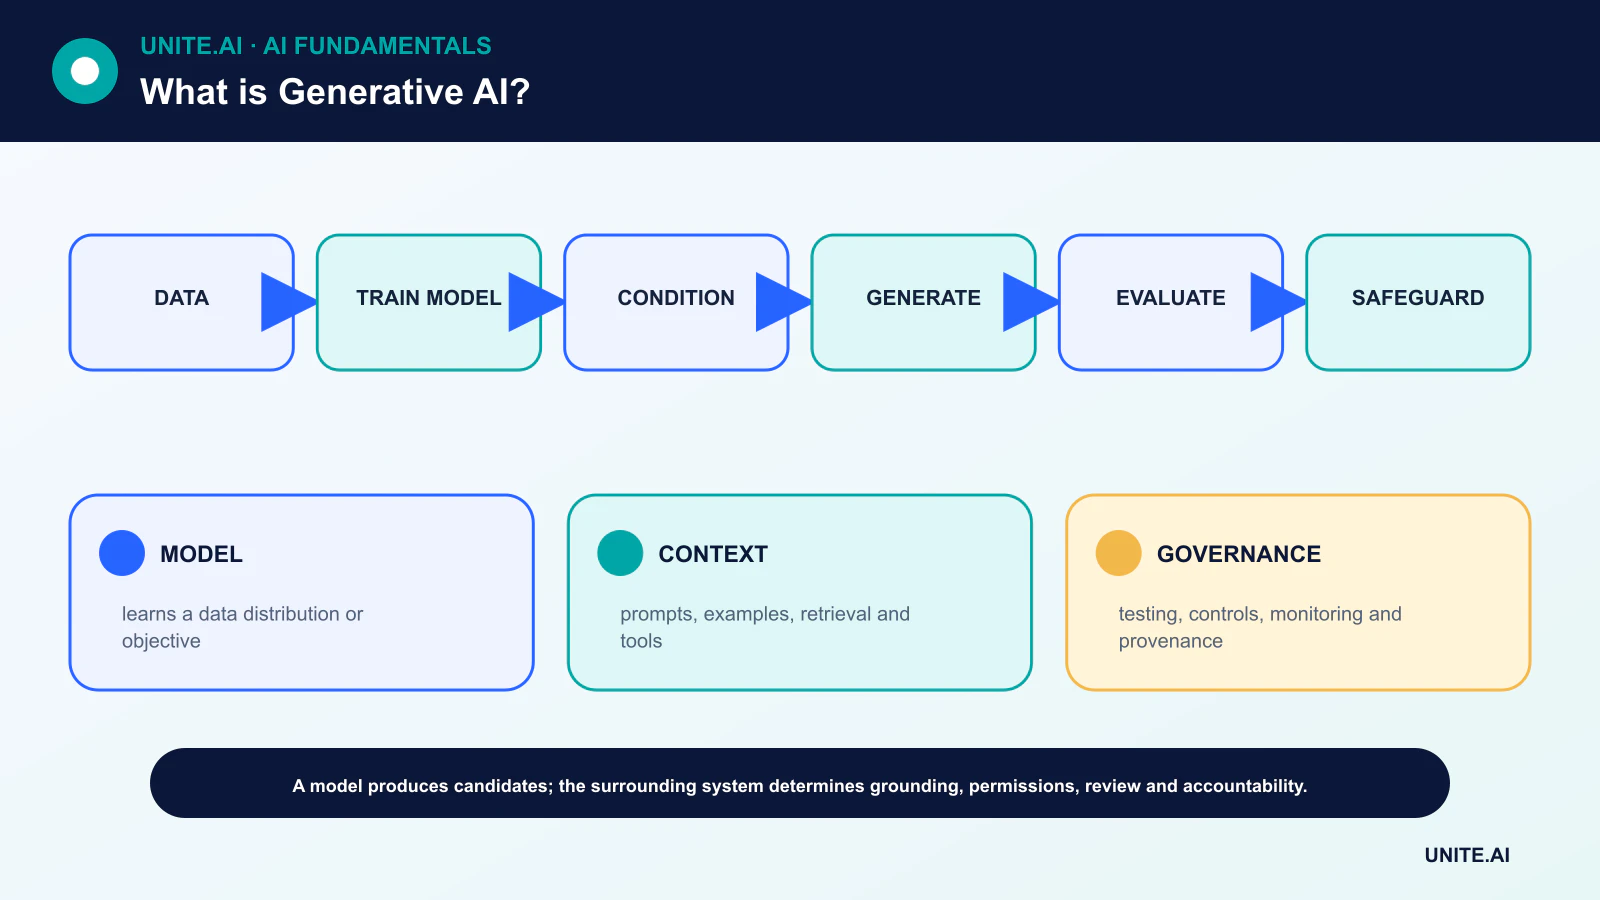
Cómo aprenden los modelos generativos
Los objetivos de entrenamiento recompensan al modelo por predecir o reconstruir patrones en los ejemplos. Un modelo de lenguaje estima el siguiente token; un modelo de difusión aprende a revertir un proceso de ruido; un autoencoder variacional aprende una distribución latente estructurada y un decodificador.
Este entrenamiento genera generalización estadística, pero también puede reproducir sesgos, memorizar secuencias poco comunes o fallar fuera de la distribución de datos. La documentación del conjunto de datos, la desduplicación, los controles de privacidad y la evaluación con datos reservados son, por tanto, importantes antes del despliegue.
Principales familias de arquitectura
Los transformadores autoregresivos dominan el texto y admiten secuencias multimodales. Los modelos de difusión se usan ampliamente para generar imágenes y audio de alta fidelidad. Los GAN pueden crear muestras nítidas y sistemas de imagen controlables, pero pueden ser difíciles de entrenar.
Los autoencoders variacionales ofrecen modelado de variables latentes y representaciones eficientes, a veces dentro de pipelines generativos más grandes. Los productos reales a menudo combinan varios modelos con recuperación, filtros, herramientas y código determinista.
Condicionamiento, muestreo y control
Un prompt, una etiqueta de clase, una imagen, un clip de audio o un registro estructurado pueden condicionar la generación. Los parámetros de muestreo alteran la diversidad y el determinismo. Una temperatura más baja puede concentrar las probabilidades de los tokens, pero no convierte una respuesta incorrecta en verdadera.
El control mejora cuando el sistema usa esquemas explícitos, decodificación restringida, material de referencia y validación. La ingeniería de prompts cambia el contexto; el ajuste fino cambia los parámetros; la recuperación aporta información externa. Cada uno aborda un modo de falla diferente.
La evaluación es específica de la aplicación
Los sistemas de texto pueden requerir pruebas de factualidad, cumplimiento de tareas, soporte de citas, toxicidad y calibración. Los sistemas de imagen o audio pueden necesitar pruebas de fidelidad, alineación semántica, diversidad, seguridad de identidad y revisión perceptual. Combine métricas automatizadas con una evaluación humana representativa.
Construya un conjunto de evaluación versionado que incluya casos ordinarios, raros, adversariales y relevantes para la política. Controle la latencia, el costo y el comportamiento de rechazo, así como la calidad de la salida. Una demo seleccionada por su creador no es evidencia de fiabilidad a nivel poblacional.
Riesgos, salvaguardas y procedencia
Los riesgos importantes incluyen alucinaciones, inyección de prompts, contenido dañino, suplantación, uso inseguro de herramientas, filtraciones de privacidad, disputas de derechos de autor, sesgo de automatización y cadenas de suministro opacas. El Perfil de IA Generativa de NIST organiza acciones en torno a la gobernanza, la procedencia del contenido, las pruebas previas al despliegue y la divulgación de incidentes.
Utilice herramientas de mínimo privilegio, controles de entrada/salida, revisión humana para decisiones con consecuencias, registro, reversión y reportes de usuarios. Las marcas de agua o credenciales de contenido pueden añadir señales, pero ningún detector o etiqueta única establece la verdad. El flujo de trabajo más amplio de medios sintéticos debe preservar el contexto y la responsabilidad.
Familias de modelos y mecanismos de generación
Los modelos de IA generativa estiman o aprenden un proceso que puede producir texto, imágenes, audio, video, código o datos estructurados nuevos. Los modelos autoregresivos predicen el siguiente token o elemento; los modelos de difusión aprenden a revertir un proceso de ruido; los autoencoders variacionales aprenden variables latentes probabilísticas; los GAN entrenan un generador contra un discriminador. Los sistemas multimodales conectan representaciones a través de medios. La salida se muestrea a partir de la estructura estadística aprendida condicionada por prompts, contexto, herramientas u otras entradas, no se recupera como un hecho garantizado.
Los modelos base se preentrenan con datos amplios y se adaptan mediante prompting, recuperación, ajuste fino, optimización de preferencias, redes de control o cabezas específicas de tarea. Los tokenizadores, codificadores, decodificadores, espacios latentes y configuraciones de muestreo moldean los resultados. La temperatura y el filtrado de candidatos equilibran determinismo y diversidad. Los prompts más extensos proporcionan contexto pero pueden entrar en conflicto, distraer o contener instrucciones maliciosas. La recuperación puede fundamentar conocimientos cambiantes, mientras que el código determinista debe manejar cálculos y reglas exactas.
Evaluación, procedencia y derechos
Evalúe por tarea: corrección factual y citación para respuestas, ejecución y seguridad para código, fidelidad y diversidad para medios, y resultado humano para asistencia creativa. Incluya pruebas de rechazo, calibración, latencia, costo, idiomas, accesibilidad y pruebas adversariales. Una salida fluida o fotorrealista puede ser incorrecta. Preserve el modelo, el prompt, la semilla, la evidencia fuente, las llamadas a herramientas y el postprocesamiento para reproducibilidad. Separe la calidad de la recuperación de la generación para que una respuesta pulida no pueda ocultar evidencia faltante.
El entrenamiento y las salidas plantean preguntas de derechos de autor, licencias, consentimiento, privacidad, publicidad y confidencialidad. Establezca la procedencia y el uso permitido de los datos de entrada; evite que los usuarios expongan secretos; pruebe la memorización; y proporcione procesos de reporte y eliminación. Los medios sintéticos deben llevar una procedencia duradera o divulgación cuando sea posible, especialmente cuando puedan confundirse con evidencia. No utilice semejanzas, voces o estilos de manera que violen derechos o engañen.
Controles de despliegue
Trate la salida del modelo como una entrada no confiable. Valide esquemas, sanee código y archivos, aísle la ejecución, autorice cada herramienta externamente, limite el costo y la tasa, y requiera confirmación para acciones con consecuencias. Monitoree fallas, abusos, desviaciones y correcciones de usuarios, con reversión y una alternativa no generativa. Documente el uso previsto y prohibido. La IA generativa amplía la interfaz para crear y transformar información, pero la fiabilidad y la responsabilidad provienen de los datos circundantes, la evaluación, la seguridad, la procedencia y el proceso de decisión humana.
Ejemplo práctico: un asistente generativo de descripciones de productos
Un minorista permite a los editores generar borradores de descripciones solo a partir de atributos de producto aprobados y directrices de marca. El prompt incluye hechos estructurados, mientras que la recuperación proporciona la política actual. La salida debe seguir un esquema y se valida contra los valores de origen; dimensiones no admitidas, afirmaciones de seguridad o certificaciones provocan rechazo. La evaluación cubre precisión factual, estilo, duplicación, calidad multilingüe, accesibilidad, latencia y corrección del editor, comparado con plantillas y escritura manual.
Los editores aprueban cada publicación y pueden ver los campos de origen. El modelo no tiene capacidad para cambiar el precio, el inventario o publicar directamente. Los prompts y los datos del producto están protegidos contra inyección, y se excluyen notas confidenciales de proveedores. El monitoreo rastrea afirmaciones no admitidas, ediciones, quejas, costos y versiones del proveedor. El texto generado se almacena con procedencia. El sistema ahorra tiempo de redacción solo si las correcciones y la revisión no eliminan el beneficio y la veracidad del producto sigue gobernada por datos autorizados.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, reversión y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿La IA generativa es lo mismo que un modelo de lenguaje grande?
No. Los LLM son una clase de modelo generativo. La IA generativa también incluye sistemas de imagen, audio, video y datos estructurados construidos con varias arquitecturas.
¿Un modelo copia sus datos de entrenamiento?
Normalmente sintetiza a partir de patrones aprendidos, pero pueden producirse memorización y duplicación cercana. Los riesgos de privacidad y procedencia deben evaluarse en lugar de asumirse como inexistentes.
Referencias principales