Fundamentos de la IA
¿Qué es el aprendizaje por transferencia?

 Añade Unite.AI a tus fuentes preferidas en Google
Transfer learning reutiliza el conocimiento aprendido para un problema para mejorar el aprendizaje en un problema relacionado. En lugar de inicializar cada parámetro aleatoriamente, el profesional parte de un modelo o representación preentrenado y lo adapta a una tarea objetivo.
Este enfoque es especialmente útil cuando el conjunto de datos objetivo es pequeño, el etiquetado es costoso, o el preentrenamiento requiere más cómputo del que el equipo objetivo puede justificar. Entrenar un modelo desde cero es la alternativa al aprendizaje por transferencia, no un tipo de aprendizaje por transferencia.
Conclusiones clave
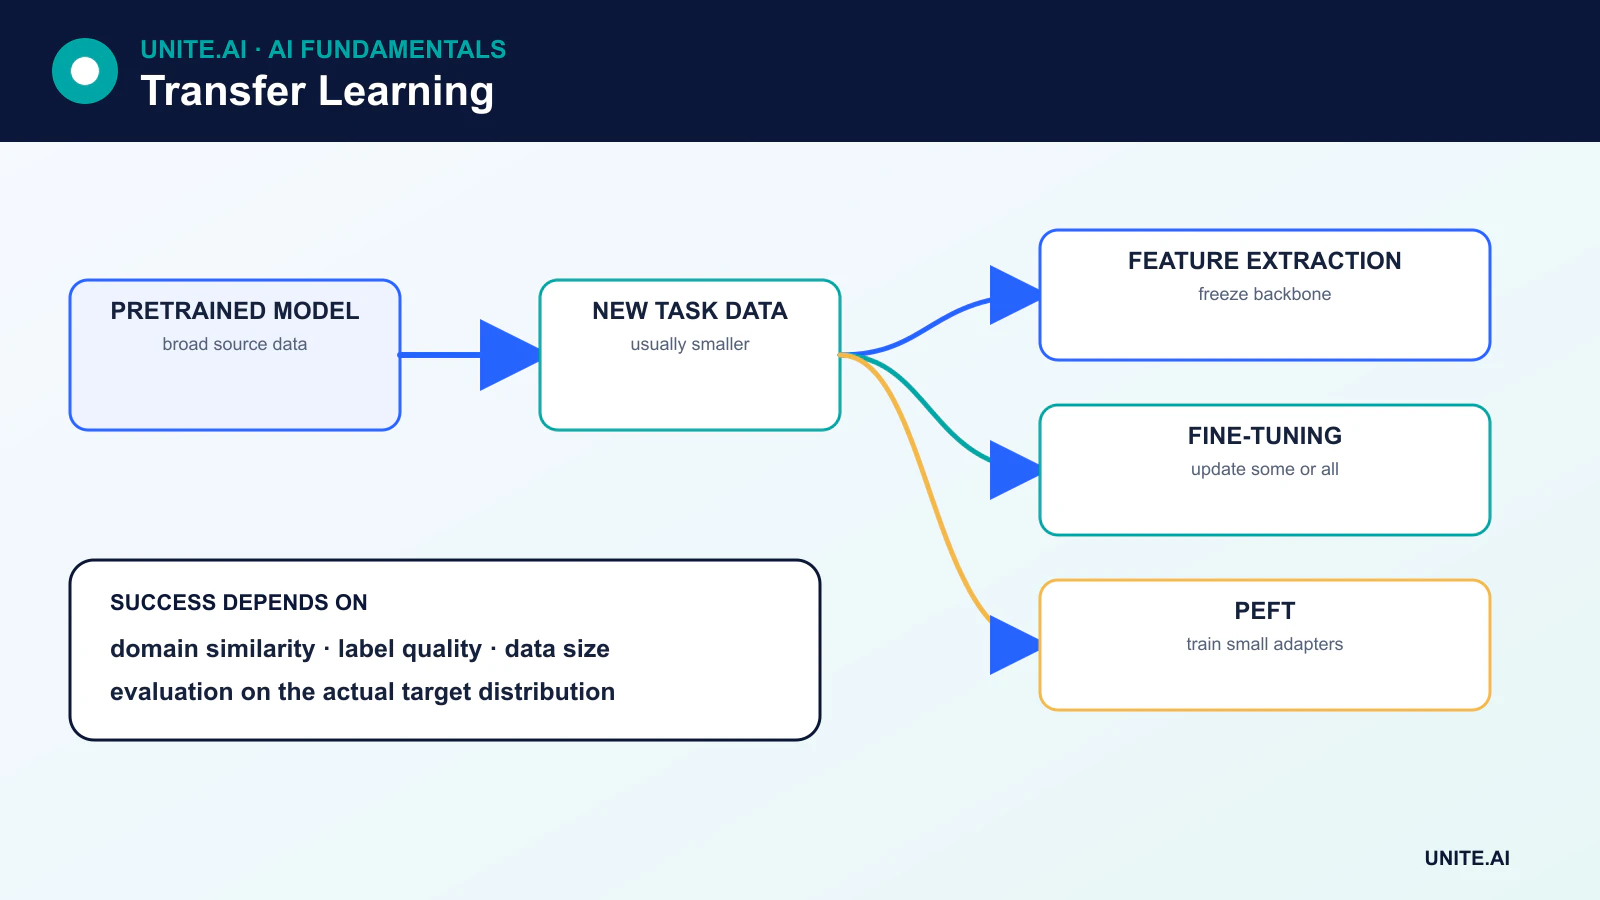
- La extracción de características mantiene congelada una base preentrenada y entrena una nueva cabeza específica de la tarea.
- El ajuste fino actualiza algunos o todos los parámetros preentrenados usando datos del dominio objetivo.
- Los métodos eficientes en parámetros, como adaptadores y LoRA, actualizan una pequeña fracción del modelo.
- La transferencia puede fallar cuando los dominios de origen y objetivo difieren, los licencias entran en conflicto, o el modelo de origen contiene sesgos inadecuados.
Por qué funciona el aprendizaje por transferencia
Los modelos a menudo aprenden representaciones que son útiles más allá de los datos exactos con los que fueron entrenados. Las capas iniciales de un modelo de imágenes pueden capturar patrones locales reutilizables; un modelo de lenguaje puede aprender sintaxis, semántica y amplias asociaciones mediante predicción auto‑supervisada. Una tarea objetivo puede basarse en esas representaciones en lugar de volver a aprender todo a partir de ejemplos limitados.
El beneficio depende de la similitud entre las tareas de origen y objetivo, la escala y calidad del preentrenamiento, y la forma en que se adapta el modelo. La reutilización no está garantizada: las características transferidas pueden ser irrelevantes o incluso perjudiciales.
Extracción de características
En la extracción de características, la base preentrenada se congela de modo que sus parámetros no cambian. Su salida se convierte en la entrada de un nuevo clasificador, regresor u otra cabeza específica de la tarea. Sólo se entrena la nueva cabeza.
Esto es rápido y eficiente en datos, y reduce el riesgo de destruir representaciones preentrenadas útiles. También puede presentar subajuste cuando el dominio objetivo difiere sustancialmente del preentrenamiento. Capas como la normalización por lotes requieren cuidados especiales porque sus estadísticas almacenadas y su comportamiento de entrenamiento pueden afectar la adaptación incluso cuando la mayoría de los pesos están congelados.
Ajuste fino
Fine-tuning actualiza los parámetros preentrenados con datos objetivo. Un flujo de trabajo común es:
- Cargar el modelo preentrenado y reemplazar o añadir la cabeza de salida.
- Congelar la base y entrenar la nueva cabeza.
- Descongelar capas seleccionadas —o el modelo completo— y continuar con una tasa de aprendizaje menor.
- Validar para sobreajuste, olvido y rendimiento en el dominio objetivo.
No existe una regla universal que indique que sólo se deben ajustar las capas finales. La mejor elección depende de la arquitectura, el tamaño de los datos objetivo, la similitud de dominios, las capas de normalización, la memoria y el cómputo. El ajuste fino completo puede ofrecer más capacidad pero requiere más recursos y puede provocar olvido catastrófico.
Ajuste fino eficiente en parámetros
Los transformers grandes hacen que el ajuste fino completo sea costoso. El ajuste fino eficiente en parámetros (PEFT) modifica o añade un pequeño conjunto de parámetros mientras deja la mayor parte del modelo base congelado.
- Adapters insertan pequeños módulos entrenables en la red.
- LoRA representa las actualizaciones de pesos con matrices de bajo rango, reduciendo los parámetros entrenables y la memoria del optimizador.
- Prompt and prefix tuning aprenden entradas continuas específicas de la tarea o prefijos internos.
PEFT puede almacenar muchas adaptaciones de tareas alrededor de un modelo base, aunque el servicio de inferencia, la compatibilidad de adaptadores y la gestión de pesos combinados aún requieren una ingeniería cuidadosa.
Aprendizaje por transferencia entre tipos de datos
Los clasificadores de imágenes suelen partir de modelos preentrenados en grandes conjuntos de datos de imágenes. Los sistemas de lenguaje parten de un modelo fundamental y lo adaptan mediante ajuste fino supervisado, optimización de preferencias, recuperación o uso de herramientas. Los modelos de voz, audio, proteínas y multimodales siguen patrones relacionados.
La transferencia también puede ocurrir sin modificar el modelo original. Un modelo congelado puede generar embeddings para un clasificador posterior, un sistema de búsqueda de similitud vectorial, o una canalización de recuperación.
Desplazamiento de dominio y transferencia negativa
Domain shift ocurre cuando las entradas objetivo difieren de los datos de origen. Un modelo de imágenes médicas, por ejemplo, puede encontrarse con equipos, poblaciones o protocolos de adquisición ausentes del preentrenamiento. Negative transfer significa que la reutilización empeora el rendimiento objetivo respecto a una línea base adecuada entrenada desde cero.
Los equipos deben comparar estrategias de adaptación, evaluar subgrupos significativos y mantener un conjunto de pruebas del dominio objetivo. Si la tarea de origen está mal alineada, un modelo más pequeño y específico del dominio puede superar a un modelo general más grande.
Licencias, procedencia y seguridad
Un modelo descargable no es automáticamente seguro para desplegar. Revise la licencia, los usos permitidos, las divulgaciones de datos de entrenamiento, las limitaciones de la tarjeta del modelo y la cadena de dependencias. Los modelos pueden reproducir sesgos, memorizar datos sensibles o contener código serializado malicioso. Utilice formatos confiables, escanee artefactos y cargue pesos no confiables en un entorno aislado.
Cuándo usar el aprendizaje por transferencia
El aprendizaje por transferencia es una opción predeterminada sólida cuando existe un modelo preentrenado relevante y los datos objetivo son limitados. Entrenar desde cero puede ser preferible cuando el dominio es altamente especializado, la licencia es incompatible, el tamaño del modelo supera los límites de despliegue, o una tarea simple no se beneficia de una gran representación preentrenada. La decisión debe validarse empíricamente en lugar de asumirse por la escala del modelo.
Qué se transfiere y cómo adaptarlo
El aprendizaje por transferencia reutiliza representaciones aprendidas en una tarea o conjunto de datos de origen para una tarea objetivo. En visión, las características tempranas suelen capturar bordes y texturas; en lenguaje, los modelos preentrenados codifican patrones estadísticos a través de tokens y contextos. La transferencia funciona cuando las representaciones de origen contienen información relevante para el objetivo, pero diferencias de dominio, etiquetas, modalidad y adquisición pueden producir transferencia negativa. Comience con una línea base preentrenada, inspeccione su licencia de entrenamiento y documentación, y compárela con entrenar un pequeño modelo específico del objetivo desde cero.
La extracción de características congela la columna vertebral y entrena una nueva cabeza; el ajuste fino parcial descongela capas seleccionadas; el ajuste fino completo actualiza todo el modelo. Los métodos eficientes en parámetros añaden adaptadores o actualizaciones de bajo rango, reduciendo los parámetros entrenables pero no necesariamente la memoria de inferencia. Use una tasa de aprendizaje menor para los pesos preentrenados, preserve el comportamiento de normalización y evite el olvido catastrófico con programaciones, regularización, reentrenamiento o actualizaciones restringidas cuando sea necesario. Seleccione puntos de control basados en datos de validación objetivo y pruebe varias semillas porque los conjuntos de datos objetivo pequeños generan alta variabilidad.
Datos, evaluación y compensaciones de despliegue
Los datos objetivo deben representar las condiciones de despliegue y subgrupos importantes, no solo ser una muestra etiquetada conveniente. Divida por sujeto, origen, tiempo o ubicación para evitar que ejemplos relacionados crucen particiones. Pruebe tanto en condiciones dentro del dominio como desplazadas. Compare variantes congeladas, parcialmente ajustadas y totalmente ajustadas en calidad, calibración, costo de entrenamiento, latencia y robustez. Una mejora en la puntuación media puede ocultar una pérdida en clases raras heredadas del sesgo de origen. Revise ejemplos de fallos para atajos específicos del origen, lagunas de vocabulario o diferencias de sensores.
Rastree el modelo base, los pesos, el tokenizador o preprocesamiento, el adaptador, los datos y la licencia como un único grafo de dependencias. Los modelos base alojados pueden cambiar su comportamiento; los pesos abiertos pueden introducir responsabilidades de cadena de suministro y parcheo. Valide el artefacto fusionado o exportado y escanee los archivos del modelo de fuentes no confiables. En producción, monitoree la deriva y el rendimiento objetivo, y mantenga la capacidad de revertir tanto la adaptación como la versión base. La transferencia reduce los datos objetivo requeridos; no elimina el etiquetado, la evaluación, la privacidad o la experiencia del dominio.
Ejemplo práctico: adaptar un modelo de visión a una nueva clínica
Una clínica adapta un codificador de imágenes preentrenado para clasificar la calidad de la imagen antes de la revisión diagnóstica. Verifica la licencia del modelo de origen y la modalidad prevista, recopila dispositivos locales y condiciones de adquisición, y divide por paciente. Se comparan variantes de características congeladas, adaptador, ajuste parcial y ajuste completo con una pequeña línea base local. Las métricas incluyen recall de clase, calibración, comportamiento de subgrupos, cómputo y sensibilidad a dispositivos, sitio y artefactos raros.
El modelo adaptado no puede realizar un diagnóstico y dirige imágenes de baja confianza o no compatibles a los técnicos. La validación de exportación confirma el preprocesamiento local y la equivalencia numérica. Las versiones del modelo, adaptador, dispositivo y conjunto de datos están vinculadas en el registro. El monitoreo detecta nuevos escáneres, cambios de protocolo y deriva de salida, mientras que muestras revisadas periódicamente estiman el rendimiento real. Una actualización del modelo de origen se trata como una nueva dependencia que requiere validación; el aprendizaje por transferencia no justifica reutilizar evidencia antigua automáticamente.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes del ajuste. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Utilice un despliegue escalonado, preserve una alternativa segura y verifique el monitoreo con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Referencias principales