Fundamentos de la IA
¿Qué es el aprendizaje profundo?

 Añade Unite.AI a tus fuentes preferidas en Google
Aprendizaje profundo es una familia de métodos de aprendizaje automático que utiliza redes neuronales con múltiples capas de procesamiento para aprender representaciones útiles de los datos. Estos modelos impulsan muchos sistemas modernos para lenguaje, imágenes, audio, recomendaciones, predicción científica y IA generativa.
La palabra profundo se refiere al número de transformaciones entre la entrada y la salida, no a que una máquina posea una comprensión más profunda. Un modelo profundo aprende relaciones numéricas útiles para su objetivo de entrenamiento, y su rendimiento aún debe evaluarse con datos nuevos.
Puntos clave
- El aprendizaje profundo es una subcategoría del aprendizaje automático.
- Las capas transforman tensores mediante parámetros aprendidos, activaciones no lineales, normalización y otras operaciones.
- La retropropagación calcula los gradientes; un optimizador usa esos gradientes para actualizar los parámetros entrenables, incluidos pesos y sesgos.
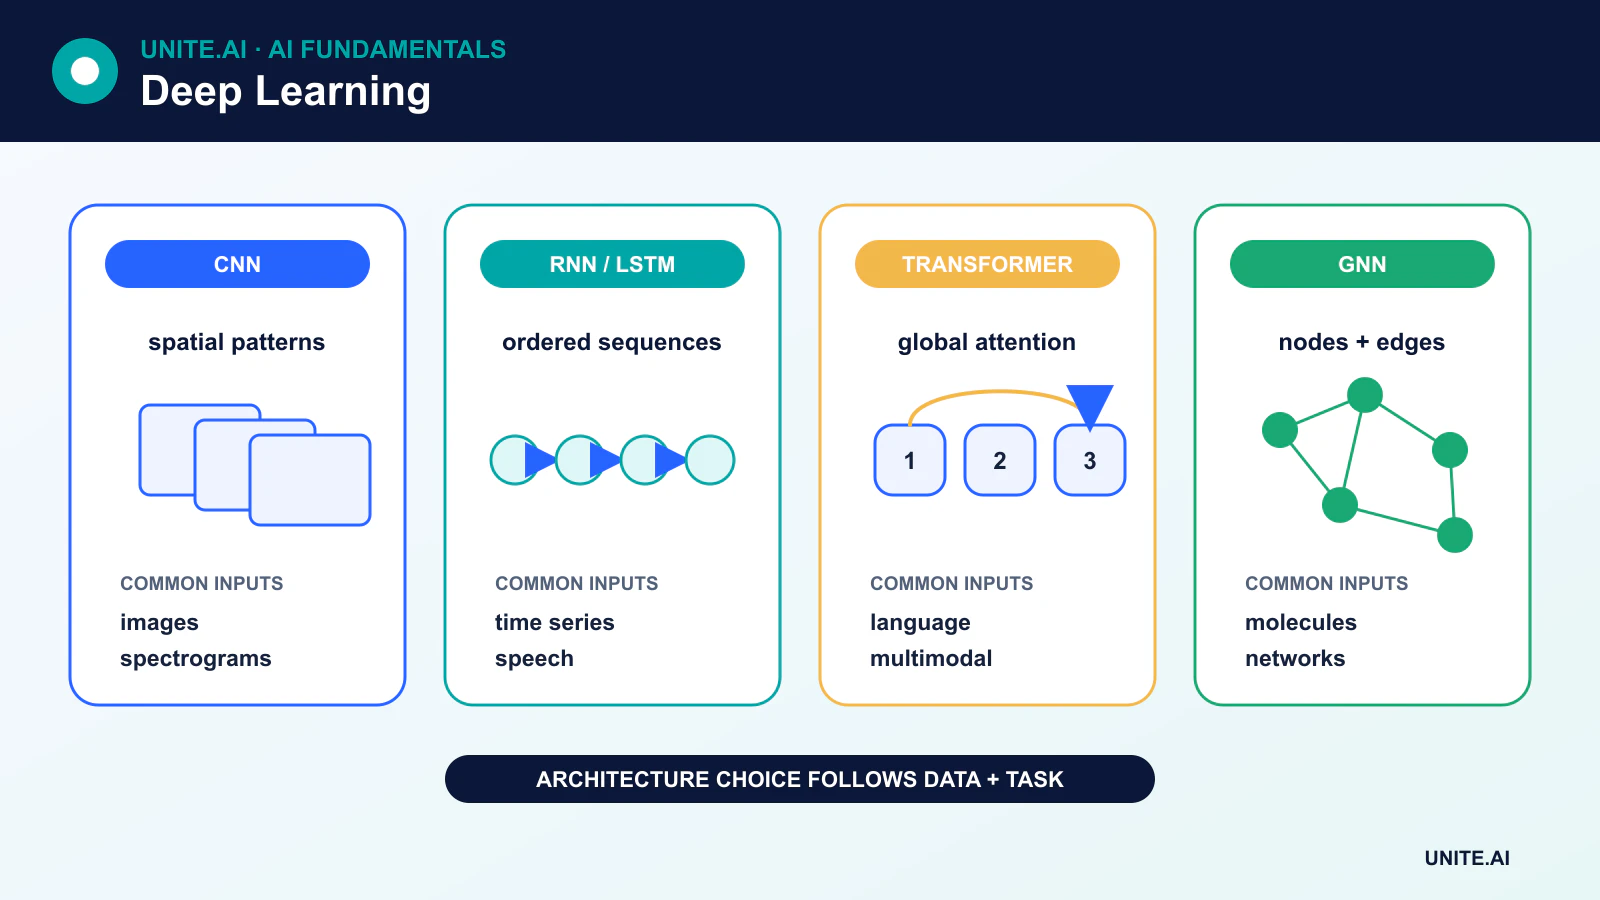
- Las CNN, redes recurrentes, transformadores, autoencoders y modelos de difusión tienen diferentes estructuras y fortalezas.
Cómo aprende una red neuronal profunda
Una red neuronal recibe datos como tensores, o arreglos multidimensionales de números. Un tensor de imagen puede codificar canales de píxeles, mientras que un modelo de lenguaje usa vectores que representan tokens. Cada capa realiza una transformación diferenciable y pasa el resultado a la siguiente capa.
En una capa densa básica, el modelo calcula una suma ponderada de sus entradas, añade un sesgo entrenable y luego aplica una función de activación:
output = activation(Wx + b)
La función de activación introduce no linealidad. Sin ella, apilar capas lineales ordinarias seguiría representando solo una transformación lineal. ReLU y sus variantes son comunes en capas ocultas, mientras que las activaciones de salida dependen de la tarea.
El entrenamiento típicamente sigue cuatro pasos:
- Una pasada hacia adelante produce predicciones.
- Una función de pérdida mide cómo difieren las predicciones del objetivo.
- Retropropagación aplica la regla de la cadena para calcular el gradiente de la pérdida con respecto a cada parámetro entrenable.
- Un optimizador como descenso de gradiente estocástico o AdamW actualiza los parámetros.
Repetir estos pasos en muchos lotes puede mejorar el modelo, pero una pérdida de entrenamiento menor no garantiza un comportamiento fiable en el mundo real. La validación, la regularización, datos representativos y la monitorización siguen siendo esenciales.
Principales arquitecturas de aprendizaje profundo
Perceptrones multicapa
Un perceptrón multicapa (MLP) utiliza capas totalmente conectadas en las que cada unidad de salida depende de todas las entradas de la capa anterior. Los MLP son útiles para características tabulares y como componentes dentro de sistemas más grandes, pero no incorporan suposiciones sobre la localidad de la imagen o el orden de la secuencia.
Redes neuronales convolucionales
Redes neuronales convolucionales (CNN) aplican filtros aprendidos a regiones locales. El compartir pesos las hace eficientes para rejillas como imágenes y espectrogramas. Las CNN siguen siendo importantes para visión y despliegues en el borde, aunque los transformadores de visión y los modelos híbridos también se usan ampliamente.
Redes recurrentes, LSTM y GRU
Redes neuronales recurrentes (RNN) actualizan un estado oculto a medida que se procesa una secuencia. Los LSTM y las unidades recurrentes con compuerta ayudan a preservar información y a reducir el problema del gradiente desaparecido que hace que las RNN básicas tengan dificultades con dependencias largas. No eliminan todas las limitaciones de contexto prolongado, pero siguen siendo útiles para señales en streaming, datos de series temporales y modelos secuenciales compactos.
Transformadores
Transformadores usan atención para modelar relaciones entre elementos de una secuencia o conjunto. Su capacidad para procesar muchas posiciones en paralelo les permitió reemplazar la recurrencia en la mayoría de los sistemas de lenguaje a gran escala, y las variantes de transformadores ahora procesan imágenes, audio, video, proteínas y datos multimodales.
Autoencoders y modelos generativos
Un autoencoder comprime una entrada en una representación y reconstruye la entrada a partir de ella. Esto crea un objetivo de reconstrucción auto‑supervisado; no convierte automáticamente datos no etiquetados en ejemplos etiquetados.
Redes generativas antagónicas entrenan un generador y un discriminador en competencia. Modelos de difusión aprenden a invertir un proceso gradual de ruido. Transformadores autorregresivos generan un token o unidad a la vez. Estos enfoques tienen dinámicas de entrenamiento, controlabilidad y requisitos de cómputo diferentes.
Por qué la profundidad ayuda — y por qué la arquitectura importa
Varias capas permiten que un modelo componga transformaciones más simples en otras más complejas. En visión, algunas características aprendidas pueden progresar de texturas locales a patrones específicos de la tarea. En lenguaje, las capas de atención construyen representaciones de tokens dependientes del contexto. Estas descripciones son intuiciones útiles, no reglas fijas sobre lo que cada capa debe aprender.
Las redes modernas también dependen de conexiones residuales, normalización, inicialización cuidadosa, regularización y hardware optimizado. Simplemente añadir capas o parámetros puede hacer que un modelo sea más difícil de entrenar, más lento o más propenso al sobreajuste. La escala del modelo ayuda solo cuando los datos, el objetivo, la optimización y el entorno de despliegue lo respaldan.
Entrenamiento versus inferencia
El entrenamiento ajusta los parámetros y suele ser la fase intensiva en cómputo. La inferencia ejecuta el modelo entrenado para producir una salida. La inferencia aún puede ser costosa para modelos grandes, por lo que los equipos usan cuantización, destilación, lotes, caché, esparsidad y hardware especializado como unidades de procesamiento neuronal.
Limitaciones y uso responsable
Los modelos profundos pueden heredar sesgos, memorizar información sensible, fallar bajo cambios de distribución y producir resultados convincentes pero incorrectos. También pueden ser difíciles de interpretar y costosos de entrenar. La evaluación debe cubrir más que un promedio de referencia: los equipos necesitan rendimiento a nivel de clase o subgrupo, robustez, calibración, seguridad, latencia, consumo energético y las consecuencias de una falla.
Representaciones, optimización y decisiones de arquitectura
Las redes profundas aprenden representaciones sucesivas a través de capas parametrizadas. Las transformaciones lineales mezclan entradas; las activaciones no lineales permiten que la red aproxime funciones complejas; la normalización y las conexiones residuales facilitan la optimización; la atención, la convolución, la recurrencia o las operaciones de espacio de estados codifican diferentes suposiciones estructurales. La profundidad aumenta el número de transformaciones, no garantiza inteligencia. La arquitectura debe reflejar la modalidad, el volumen de datos, la latencia, la memoria y las invariancias de la tarea. Un modelo convolucional más pequeño puede superar a un transformador cuando los datos son limitados y la estructura espacial local domina.
El entrenamiento calcula una pérdida, la diferencia con retropropagación y actualiza los parámetros con un optimizador como descenso de gradiente estocástico o Adam. El tamaño de lote, la tasa de aprendizaje, el programa, la inicialización, la regularización y la precisión numérica interactúan. Las curvas de pérdida de entrenamiento y validación ayudan a distinguir subajuste, sobreajuste, inestabilidad y fuga, pero no establecen utilidad en el mundo real. Use datos de evaluación independientes, ejecuciones repetidas donde la varianza importa, ablaciones y comparaciones con líneas base más simples. Los recuentos de parámetros grandes también aumentan la necesidad de gobernanza de datos, planificación de cómputo y configuración reproducible.
Despliegue de modelos profundos de forma segura y eficiente
El despliegue puede usar un endpoint alojado, acelerador dedicado, navegador, teléfono o dispositivo embebido. La exportación y compilación pueden fusionar operadores, cuantizar pesos y activaciones, o cambiar el comportamiento numérico, por lo que se debe validar el artefacto desplegado en lugar de solo el punto de control de entrenamiento. Mida el arranque en frío, latencia estable, rendimiento, memoria, energía y calidad con tamaños realistas de lote y secuencia. Los métodos de compresión —poda, destilación, cuantización y adaptación de bajo rango— intercambian tamaño o velocidad contra precisión y complejidad de ingeniería y deben evaluarse en clases sensibles y casos límite.
Los modelos profundos pueden fallar con confianza bajo cambios de distribución, entradas adversarias, correlaciones espurias y grupos pobremente representados. Monitoree distribuciones de entrada y salida, resultados de la tarea, calibración, uso de recursos y versiones de dependencias. Use control de acceso, artefactos firmados, datos de entrenamiento protegidos, pruebas de resistencia y límites de velocidad apropiados al modelo de amenaza. Las explicaciones como mapas de saliencia o vistas de atención son evidencia diagnóstica, no prueba de causalidad. Combínelas con pruebas de comportamiento, contrafactuales, revisión humana, respuesta a incidentes y límites explícitos en decisiones automatizadas.
Ejemplo práctico: entrenamiento de un detector de defectos en imágenes
Una fábrica recopila imágenes de productos a través de cámaras, turnos, materiales y clases de defectos conocidas, luego las divide por lotes de producción para que los ítems casi duplicados no crucen particiones. Se compara una línea base convolucional pequeña con una red profunda preentrenada. La augmentación reproduce variaciones validadas de iluminación y punto de vista sin eliminar defectos. La evaluación informa recuperación por defecto, tasa de falsos rechazos, calibración, latencia de inferencia y robustez a desenfoque, reflejo, sustitución de cámara y colores de material raros.
El modelo exportado y el código exacto de redimensionado, color y normalización se prueban en el hardware de la línea para medir rendimiento sostenido y comportamiento térmico. Los casos de baja confianza se envían a inspectores; una regla independiente detiene la línea ante fallas críticas de sensores. Las imágenes se conservan solo según lo permitido y los artefactos del modelo están firmados. El monitoreo conecta predicciones con resultados de inspección posteriores y lotes de producción. Una nueva cámara o material desencadena una reevaluación controlada en lugar de aprendizaje en línea silencioso con etiquetas no revisadas.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, reversión y retiro. Use un despliegue escalonado, preserve una caída segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos cambien. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Referencias principales