
Fundamentos de la IA
¿Qué son las RNN y las LSTM en el aprendizaje profundo?

 Añade Unite.AI a tus fuentes preferidas en Google
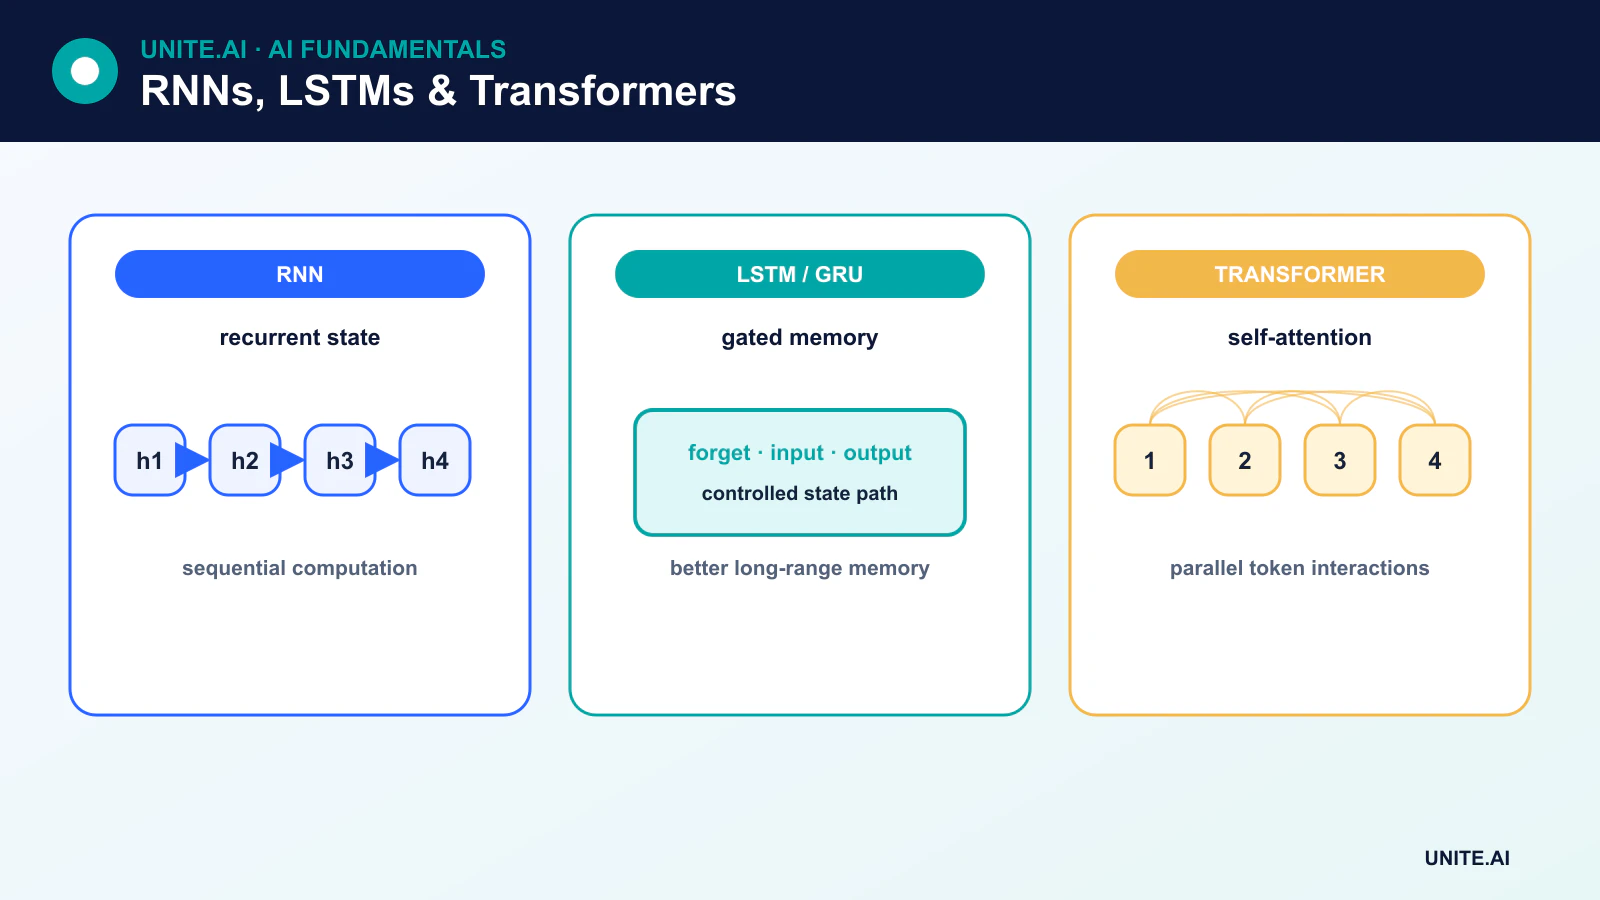
Redes neuronales recurrentes (RNN) procesan secuencias actualizando un estado oculto a lo largo del tiempo. Redes de memoria a corto y largo plazo (LSTM) son RNN con puertas diseñadas para preservar y controlar la información de manera más eficaz que una unidad recurrente básica.
Las RNN y LSTM dominaron en su momento muchas tareas de lenguaje, pero los chatbots modernos y de gran escala se basan principalmente en transformers. Los modelos recurrentes siguen siendo útiles para transmisión en tiempo real, series temporales, voz, control y sistemas con recursos limitados donde el estado incremental y la baja latencia son importantes.
Conclusiones clave
- Una RNN reutiliza los mismos parámetros en cada paso de la secuencia y transporta un estado oculto hacia adelante.
- El entrenamiento a lo largo del tiempo puede generar gradientes que desaparecen o explotan.
- Una LSTM añade un estado de celda y puertas de entrada, olvido y salida.
- Los transformers manejan relaciones de largo alcance y entrenamiento en paralelo de forma diferente; ninguna arquitectura es la mejor para todas las implementaciones.
Cómo funciona una RNN básica
En el paso t, una unidad recurrente simple combina la entrada actual xₜ con el estado oculto previo hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
El estado oculto es un resumen aprendido que se usa para el siguiente paso y, según la tarea, como salida. Un diagrama “desenrollado” muestra una copia por paso de tiempo, pero todas comparten los mismos parámetros. La salida no se copia simplemente como una nueva entrada cruda; la recurrencia transmite el estado oculto a través de una transformación definida.
Retropropagación a través del tiempo
Las RNN se entrenan con retropropagación a través del tiempo (BPTT). La secuencia desenrollada forma un grafo computacional profundo, y la retropropagación calcula cómo la pérdida depende de los parámetros recurrentes compartidos.
La multiplicación repetida puede hacer que los gradientes se reduzcan a cero o crezcan sin límite. Los gradientes que desaparecen impiden aprender dependencias largas; los gradientes que explotan generan actualizaciones inestables. El recorte de gradientes (gradient clipping) aborda los gradientes explosivos, mientras que las puertas, la inicialización, la normalización y ventanas de entrenamiento más cortas pueden ayudar.
Dentro de una celda LSTM
Una LSTM mantiene un estado de celda cₜ además del estado oculto hₜ. Sus puertas son controles aprendidos y dependientes de los datos:
- La puerta de olvido controla cuánto del estado de celda previo se conserva.
- La puerta de entrada controla cuánta información candidata se escribe.
- La puerta de salida controla cuánto de la información de la celda contribuye al estado oculto.
Las salidas sigmoides entre cero y uno actúan como puertas suaves, mientras que un candidato transformado por tanh aporta contenido nuevo. La ruta aditiva del estado de celda ayuda a que los gradientes persistan, pero las LSTM no garantizan memoria ilimitada ni eliminan todos los problemas de optimización.
GRU y recurrencia bidireccional
Una unidad recurrente con puertas (GRU) combina los mecanismos de puertas en una celda recurrente más simple sin un estado de celda separado al estilo LSTM. Las GRU pueden entrenarse más rápido y rendir de forma similar en algunas tareas.
Una RNN bidireccional procesa una secuencia completa en ambas direcciones y combina los estados. Puede usar el contexto futuro para etiquetado o codificación, pero resulta inapropiada para transmisión causal cuando las entradas futuras aún no están disponibles.
Modelos de secuencia a secuencia
Las RNN codificador‑decodificador mapean una secuencia a otra. La atención se introdujo para que un decodificador consulte diferentes estados del codificador en lugar de depender de un único vector fijo. Esta línea de trabajo condujo a la arquitectura transformer, que sustituyó la recurrencia por bloques basados en atención.
RNN vs transformers
Los transformers procesan las posiciones de entrenamiento en paralelo y crean rutas de atención cortas entre tokens lejanos. Las RNN procesan el estado secuencialmente, limitando el paralelismo pero ofreciendo un estado recurrente de tamaño constante durante la transmisión. La inferencia con transformers puede requerir una caché de claves‑valores en crecimiento, mientras que una RNN comprime el historial en su estado oculto y puede perder detalle.
Elija según la longitud de la secuencia, la escala de datos, el hardware, la latencia, la memoria y si la tarea es offline o en tiempo real. Las arquitecturas híbridas y de espacio de estados ofrecen compensaciones adicionales.
Casos de uso actuales
Las RNN y LSTM siguen siendo relevantes para pronósticos, detección de anomalías, procesamiento de sensores, componentes de voz, escritura a mano, control embebido y modelado de secuencias de baja latencia. No son la explicación predeterminada de los actuales modelos de lenguaje extensos ni de los chatbots de IA.
Recurrencia, puertas y memoria de secuencia
Una red neuronal recurrente procesa una secuencia combinando la entrada actual con un estado oculto transportado desde pasos anteriores. Los pesos compartidos permiten longitudes de secuencia variables, y el desenrollado expone el cálculo a lo largo del tiempo para el entrenamiento. Las RNN básicas pueden representar dependencia temporal, pero los gradientes multiplicados repetidamente a través de secuencias largas tienden a desaparecer o explotar. La retropropagación truncada limita la memoria y el cómputo, mientras que el recorte de gradientes controla actualizaciones extremas. El estado oculto es un resumen aprendido, no un almacenamiento fiel de cada token anterior.
Las redes de memoria a corto y largo plazo (LSTM) añaden un estado de celda y puertas de entrada, olvido y salida que regulan la escritura, retención y exposición de la información. Las unidades recurrentes con puertas (GRU) utilizan una estructura más simple de reinicio y actualización. Las variantes bidireccionales usan contexto futuro y, por lo tanto, no pueden transmitir de forma causal sin retraso. Los modelos recurrentes apilados, residuales y aumentados con atención añaden capacidad. El relleno (padding) y las máscaras deben impedir que elementos de secuencia artificiales afecten al estado o la pérdida, y el estado debe restablecerse en los límites reales de la secuencia para evitar fugas entre ejemplos.
Entrenamiento, comparación y servicio con estado
Las RNN y LSTM siguen siendo útiles para transmisión en tiempo real, modelos compactos en el dispositivo, series temporales y cargas de trabajo donde el estado secuencial es eficiente. Los transformers paralelizan el entrenamiento y modelan interacciones de largo alcance de forma diferente, pero pueden requerir mayor memoria y caché. Compare las arquitecturas en precisión, latencia, rendimiento, memoria, consumo energético y desempeño a medida que varía la longitud de la secuencia. Evalúe pronósticos con divisiones temporales rodantes, lenguaje con métricas conscientes de la secuencia y detección de anomalías con medidas a nivel de evento. Examine fallos después de largas brechas, cambios de régimen, muestras faltantes y límites de secuencia abruptos.
El despliegue con estado debe asociar el estado oculto con la sesión correcta, expirarlo, cifrarlo si es sensible y restablecerlo después de errores o cambios de modelo. Eventos fuera de orden o duplicados pueden corromper el estado; incluya marcas de tiempo, números de secuencia e idempotencia. Monitoree la antigüedad del estado, la longitud de la secuencia, la ausencia de datos, la deriva de salida y la latencia. La cuantización necesita validación sensible a las puertas porque pequeños cambios numéricos pueden acumularse con el tiempo. La memoria de la RNN permite contexto, pero también puede preservar información privada o desactualizada, por lo que la retención y los controles de usuario deben formar parte del diseño.
Ejemplo práctico: una LSTM para secuencias de sensores en tiempo real
Una utilidad emplea una LSTM para pronosticar la carga a corto plazo a partir de mediciones recientes, calendario y clima. Las secuencias se construyen con orden temporal estricto; el estado oculto se restablece en los límites del alimentador, y el relleno se enmascara. Las líneas base estacionales ingenuas y potenciadas por gradiente se comparan con la LSTM en ventanas rodantes. Las pruebas cubren intervalos faltantes, clima retrasado, festivos, apagones y longitudes de secuencia superiores al entrenamiento típico.
El servicio de transmisión asocia el estado con un alimentador, rechaza duplicados fuera de orden y expira el estado tras largas brechas o actualizaciones del modelo. Un pronóstico estadístico seguro reemplaza la salida cuando los sensores o el estado son inválidos. La inferencia cuantizada se verifica en secuencias largas para detectar deriva acumulada. El monitoreo rastrea la antigüedad del estado, la ausencia de datos, la latencia, el sesgo y el error de intervalo. El modelo se reentrena solo después de cambios en la red eléctrica y los resultados revisados muestran que las relaciones temporales aprendidas ya no generalizan.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallas de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, conserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Es una LSTM siempre mejor que una RNN básica?
No. Las puertas ayudan en muchos problemas de dependencias largas, pero añaden cómputo y parámetros. Una RNN básica puede ser adecuada para secuencias cortas y simples, y otra arquitectura puede ser mejor para contextos muy extensos.
¿Puede una LSTM procesar un historial ilimitado?
No. Su estado tiene capacidad finita, los gradientes y los datos de entrenamiento imponen límites, y los detalles relevantes pueden sobrescribirse. El rendimiento en contextos largos debe medirse en lugar de inferirse del nombre de la arquitectura.
Referencias principales












