
Fundamentos de la IA
¿Qué son las CNN (Redes Neuronales Convolucionales)?

 Añade Unite.AI a tus fuentes preferidas en Google
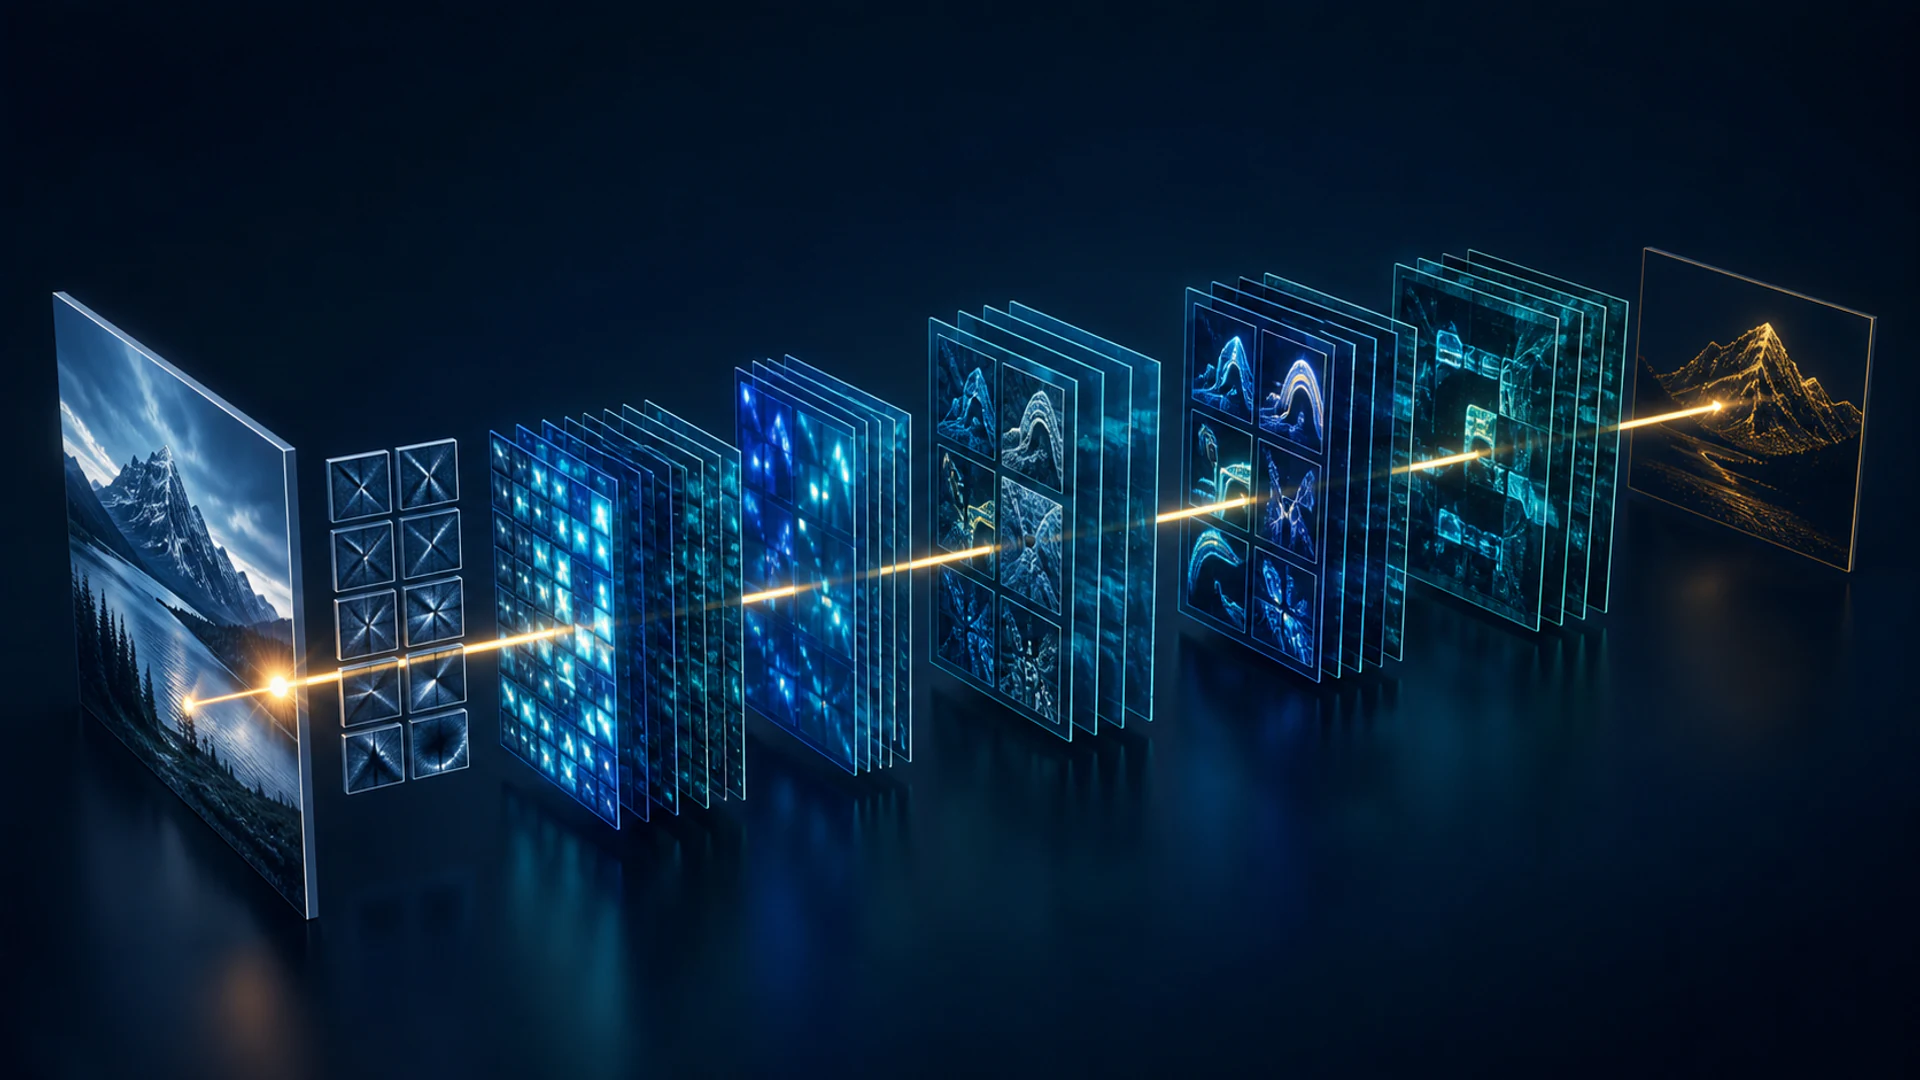
Una red neuronal convolucional (CNN) es una arquitectura de red neuronal que utiliza filtros aprendidos en regiones locales de una entrada. Las CNN se convirtieron en la base de la visión por computadora moderna porque pueden detectar patrones sin importar dónde aparezcan y reutilizar los mismos parámetros en toda la imagen.
Una CNN no convierte una imagen de forma no numérica a numérica; la imagen ya llega como un tensor de valores de píxeles. Su objetivo es transformar ese tensor en mapas de características útiles para clasificación, detección, segmentación u otra tarea.
Conclusiones clave
- Una convolución combina valores de entrada locales con un kernel aprendido para producir un mapa de características.
- El stride, el padding, la dilatación y el pooling controlan la resolución espacial y el campo receptivo.
- El compartir pesos hace que las CNN sean más eficientes en parámetros que una red totalmente conectada sobre píxeles crudos.
- Los vision transformers ofrecen una alternativa, pero las CNN siguen siendo fuertes para sistemas eficientes y con datos limitados.
Cómo funciona la convolución
Un kernel es una pequeña cuadrícula de pesos entrenables. En cada posición, la CNN multiplica los valores del kernel por los valores de entrada correspondientes, suma los resultados y normalmente añade un sesgo. Repetir esto a lo largo de la entrada produce un mapa de características.
Para una imagen en color, un kernel abarca todos los canales de entrada. Una capa usa múltiples kernels para crear varios canales de salida. Durante el entrenamiento, backpropagation calcula los gradientes de estos pesos del kernel; la operación de convolución no fabrica un nuevo conjunto fijo de pesos a partir de cada imagen.
Stride, padding y dilatación
- Stride controla cuánto se desplaza el kernel. Un stride mayor que uno reduce la resolución espacial.
- Padding agrega valores alrededor de una entrada para que la información de los bordes pueda procesarse y el tamaño de salida pueda controlarse.
- Dilation separa los elementos del kernel, ampliando el campo receptivo sin aumentar proporcionalmente los parámetros.
El campo receptivo es la región de la entrada original que puede influir en una unidad. Apilar convoluciones lo expande, permitiendo que características posteriores combinen información de áreas más amplias.
Activación, normalización y pooling
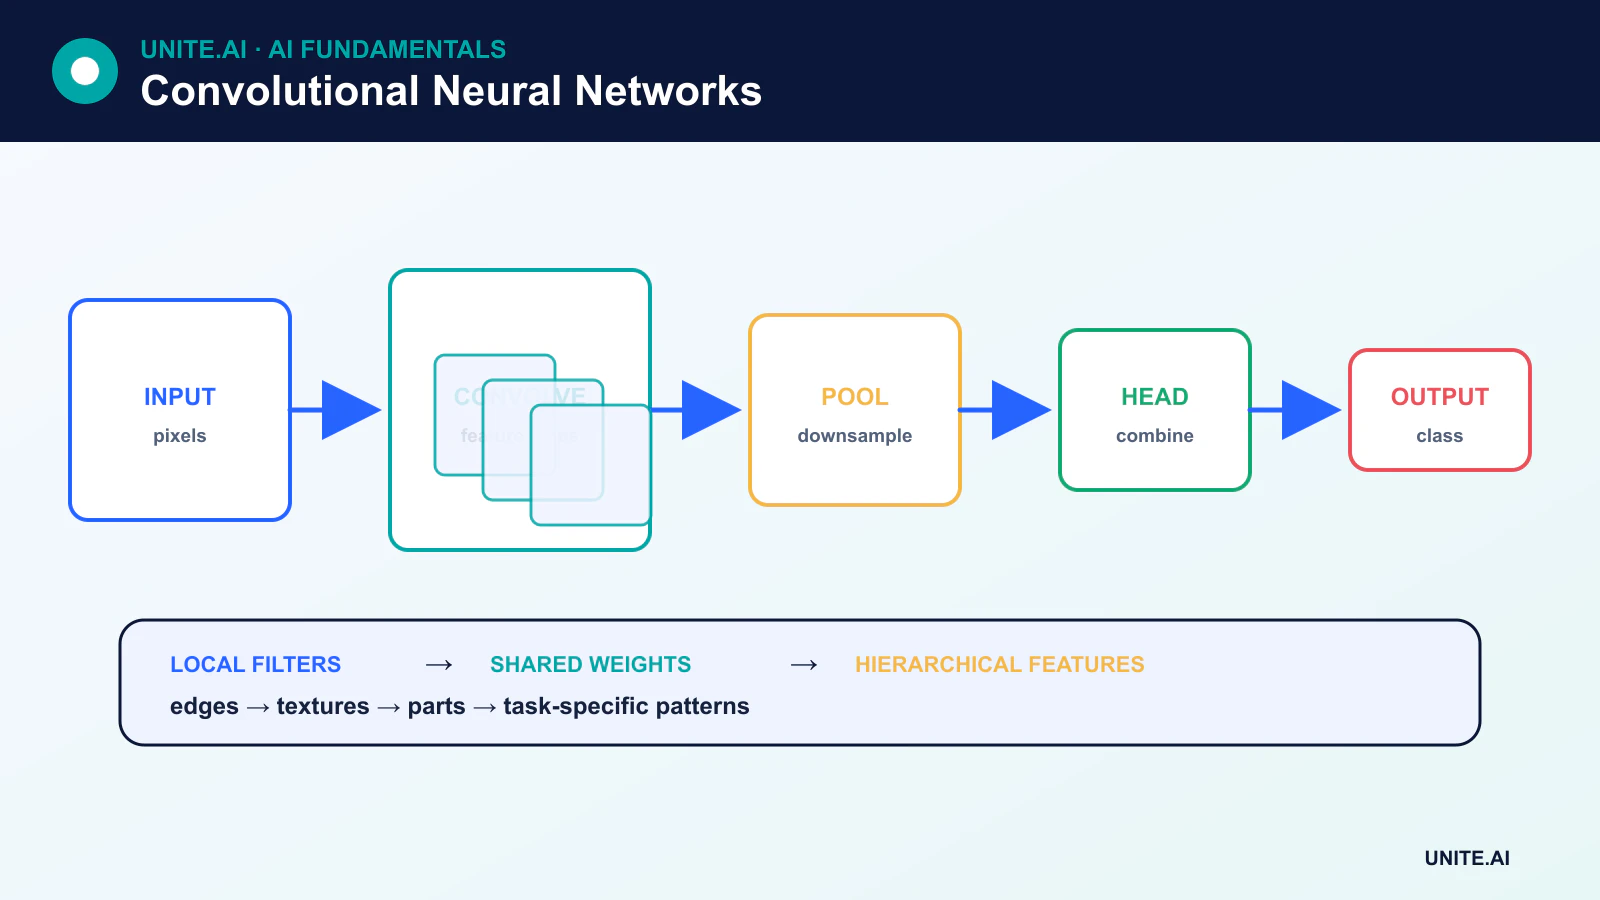
Las capas convolucionales suelen ir seguidas de activaciones no lineales y normalización. El pooling resume regiones locales mediante una operación como máximo o promedio. Las convoluciones con stride aprendidas también pueden reducir la resolución.
El pooling no es obligatorio. Muchas redes modernas usan pooling global promedio cerca de la salida en lugar de aplanar un mapa de características grande en una pila totalmente conectada. Esto reduce los parámetros y permite que la red agregue evidencia espacial.
Una arquitectura CNN moderna
Un modelo de visión típico contiene una base, una secuencia de bloques de características, etapas de reducción de resolución y una cabeza de tarea. Las conexiones residuales permiten que un bloque aprenda una modificación de su entrada y proporcionen una ruta directa para la información y los gradientes. El éxito de las redes residuales hizo práctico entrenar CNN mucho más profundas.
Las cabezas de clasificación generan puntuaciones de clases. Las cabezas de detección predicen categorías y cuadros. Las arquitecturas de segmentación añaden rutas decodificadoras que recuperan detalle espacial. La misma columna vertebral CNN puede reutilizarse mediante transfer learning.
Qué aprenden las capas de CNN
Es común visualizar filtros iniciales que responden a bordes o texturas y representaciones posteriores que se correlacionan con partes u objetos. Esta es una intuición útil, pero no es una regla fija. Las características dependen de la tarea, la arquitectura, los datos, el objetivo y el proceso de entrenamiento, y algunas unidades combinan información que no se corresponde claramente con un concepto humano.
CNN vs. vision transformers
Los vision transformers dividen las imágenes en parches y usan atención para modelar las relaciones entre ellos. Pueden escalar eficazmente con grandes conjuntos de datos de preentrenamiento. Las CNN incorporan suposiciones de localidad y de translación directamente en la arquitectura, lo que puede hacerlas más eficientes y efectivas en datos en entornos más pequeños.
Muchos sistemas prácticos combinan convolución y atención. La arquitectura adecuada depende de la precisión, latencia, memoria, datos de entrenamiento, hardware y despliegue, no de cuál familia sea la más reciente.
Limitaciones y consideraciones prácticas
Las CNN pueden ser sensibles a cambios en la distribución, perturbaciones adversarias, atajos de fondo y datos de entrenamiento sesgados. No son perfectamente invariantes a posición, rotación, escala o punto de vista. La augmentación y las decisiones de arquitectura pueden mejorar la robustez, pero no la garantizan.
Para el despliegue, mida la latencia de extremo a extremo, la memoria, el rendimiento y el comportamiento de subgrupos. La cuantización y la poda pueden reducir costos, especialmente para edge AI, pero los modelos comprimidos deben volver a validarse.
Convolución, campos receptivos y bloques CNN modernos
Una capa convolucional desliza kernels aprendidos a través de una cuadrícula y comparte pesos entre posiciones. El tamaño del kernel, el stride, la dilatación y el padding determinan la forma de salida y el campo receptivo. Las capas iniciales a menudo responden a bordes o texturas locales; las capas más profundas combinan información en regiones mayores, aunque las representaciones aprendidas no necesitan mapearse claramente a conceptos humanos. El pooling o la convolución con stride reduce la resolución espacial. Los canales transportan mapas de características, mientras que la convolución agrupada y separable en profundidad intercambia la mezcla entre canales por menor cómputo. Las conexiones residuales facilitan la optimización de redes muy profundas.
Para una altura y anchura de entrada, el padding controla el tratamiento de los bordes y el stride controla el muestreo. Un downsampling agresivo puede eliminar objetos pequeños; el padding cero puede crear artefactos en los bordes; la dilatación expande el contexto sin el mismo crecimiento de parámetros pero puede producir un patrón de rejilla. La normalización por lotes depende de las estadísticas de entrenamiento, mientras que alternativas pueden comportarse mejor con lotes pequeños. Las arquitecturas modernas combinan cuellos de botella, características multiescala, atención o residuales invertidos. Seleccione la arquitectura usando la resolución de la tarea, el ancho de banda de memoria, la latencia y el hardware objetivo, en lugar de basarse solo en la precisión de clasificación de imágenes.
Entrenamiento, interpretación y despliegue
Utilice aumentaciones que preserven las etiquetas y reflejen variaciones reales, y divida por sujeto o escena antes de la augmentación. El transfer learning es común: reemplace la cabeza de tarea, entrénela y luego descongele la columna vertebral con cautela. Evalúe el rendimiento por clase, la calibración, la robustez a desenfoque, compresión, iluminación, escala, recorte y perturbaciones adversarias. Métodos de visualización como mapas de características y saliencia pueden revelar atajos, pero son sensibles al método y la referencia. Confirme la dependencia sospechada con imágenes contrafactuales, pruebas de oclusión o cambios en el conjunto de datos.
Las CNN exportadas pueden fusionarse, cuantizarse o compilarse para GPU, NPU, navegador o microcontrolador. Valide el grafo desplegado, incluido el preprocesamiento y postprocesamiento, en los dispositivos exactos. Mida la latencia de extremo a extremo, la memoria, la energía y el comportamiento térmico; la decodificación de entrada puede dominar en un modelo pequeño. Monitoree estadísticas de cámara e imagen, la distribución de salida y los errores confirmados. Los artefactos de modelo firmado, los canales de actualización protegidos y la falla graceful del sensor forman parte del diseño de producción. Las CNN codifican un sesgo de localidad útil, pero no comprenden automáticamente objetos o escenas causales.
Ejemplo práctico: despliegue de una CNN en una cámara de inspección
Una CNN clasifica defectos de superficie a partir de imágenes de escaneo lineal de alta resolución. Los ingenieros segmentan las imágenes con solapamiento para que los defectos pequeños sobrevivan al downsampling, preservan coordenadas para revisión y validan las aumentaciones contra variaciones ópticas reales. Se comparan una CNN residual y un modelo depthwise más ligero con igual recall. Las pruebas incluyen defectos de borde, reflejos, compresión, movimiento, lotes de material y reemplazos de cámara, reservando lotes de producción independientes para la evaluación final.
La compilación fusiona y cuantiza el modelo para un acelerador de borde, pero el grafo desplegado se compara con la referencia en casos de defectos sensibles. La decodificación, segmentación, inferencia y latencia de fusión se miden de extremo a extremo. El sistema marca píxeles muertos y deriva de exposición por separado de los defectos del producto. Los operadores pueden inspeccionar los segmentos originales y sobrescribir los resultados. Los cambios de modelo y cámara se implementan gradualmente, y la línea mantiene un procedimiento de inspección manual seguro cuando la cadena de visión no está disponible.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, uso indebido y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Siempre necesita una CNN pooling?
No. Una CNN puede reducir la resolución con convolución de stride y puede preservar la resolución para predicciones densas. El pooling es una herramienta de diseño, no un requisito definitorio.
¿Los filtros de CNN están diseñados a mano?
En una CNN entrenada, los valores del kernel normalmente se aprenden a partir de los datos. Esto difiere de los filtros de visión clásicos cuyas coeficientes se eligen previamente para operaciones como la detección de bordes.
Referencias principales












