
Fundamentos de la IA
¿Qué es el metaaprendizaje?

 Añade Unite.AI a tus fuentes preferidas en Google
Meta-learning entrena un sistema a través de una distribución de tareas para que pueda adaptarse a una nueva tarea relacionada usando datos o cómputo limitados. A menudo se resume como “aprender a aprender”, pero el objetivo técnico es más preciso: optimizar el aprendiz de modo que la experiencia en tareas anteriores mejore la adaptación a una posterior.
Meta-learning se superpone con few-shot learning y transfer learning, pero los términos no son intercambiables. Few-shot describe la cantidad de datos objetivo; transfer describe la reutilización; meta-learning hace explícito que la adaptación entre tareas forma parte del entrenamiento.
Conclusiones clave
- El meta‑entrenamiento usa muchas tareas, no solo muchos ejemplos independientes.
- Un episodio N‑way K‑shot contiene N clases y K ejemplos de soporte etiquetados por clase.
- Los métodos basados en gradiente, basados en métricas, basados en memoria y los optimizadores aprendidos se adaptan de diferentes maneras.
- El rendimiento depende fuertemente de si las tareas de meta‑entrenamiento se asemejan a la tarea objetivo.
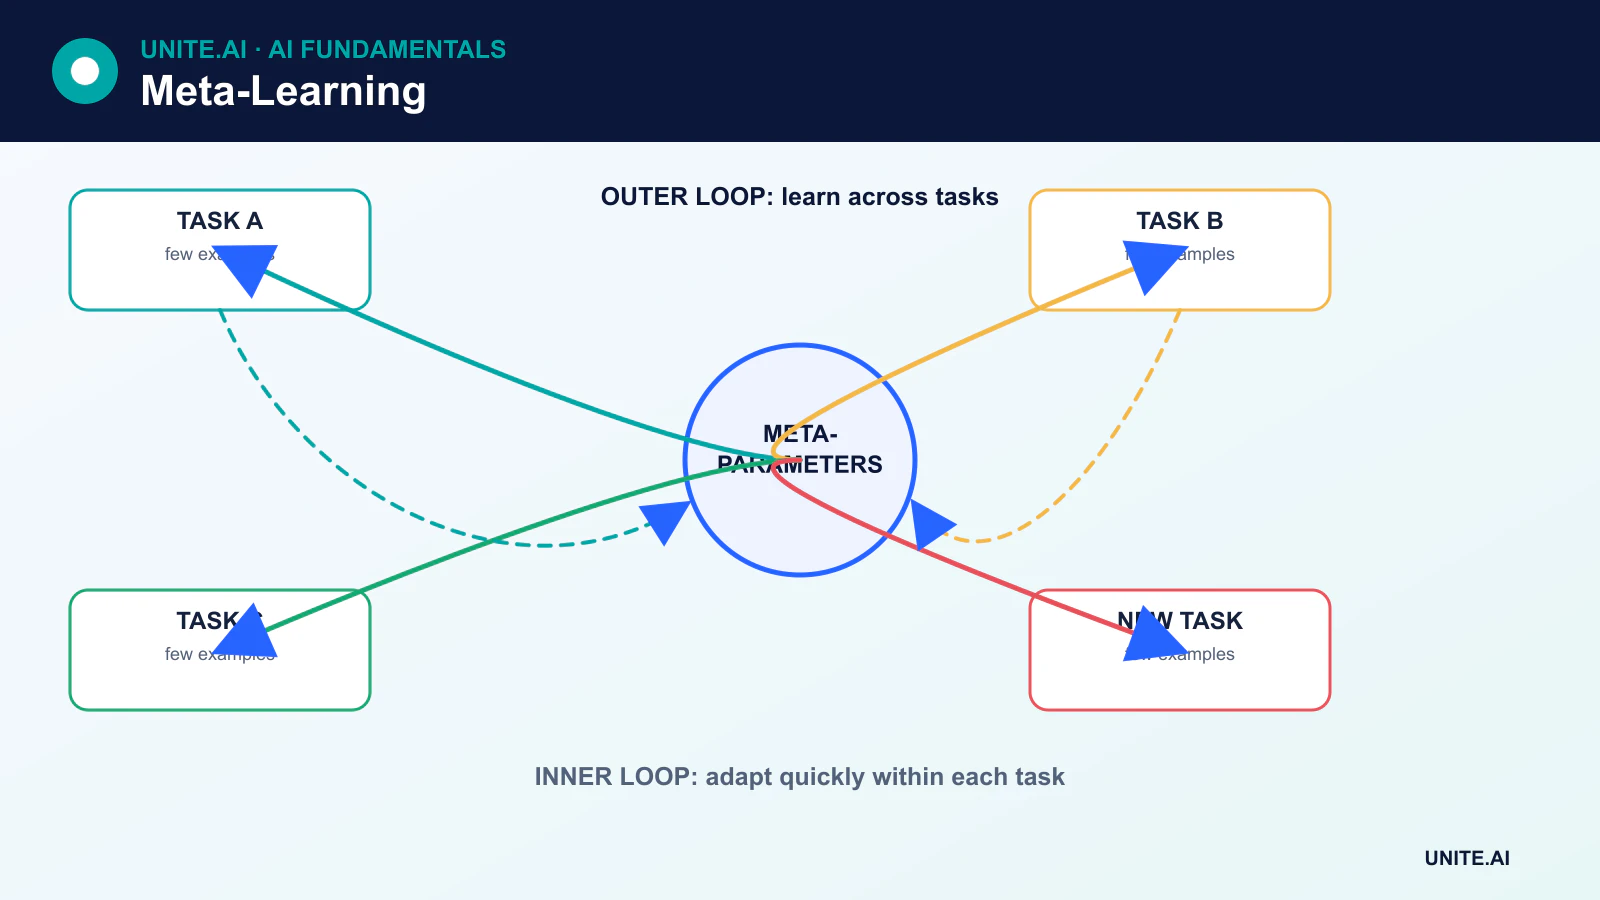
Tareas, conjuntos de soporte y conjuntos de consulta
Un conjunto de datos de meta‑aprendizaje se organiza como tareas. En clasificación few‑shot, un episodio puede ser 5‑way 1‑shot: cinco clases, un ejemplo de soporte etiquetado por clase, y ejemplos de consulta adicionales usados para evaluar la adaptación. Una tarea 5‑way 5‑shot tiene cinco ejemplos de soporte para cada una de las cinco clases, no cinco ejemplos en total.
Durante el meta‑entrenamiento, el aprendiz se adapta repetidamente sobre un conjunto de soporte y se evalúa en un conjunto de consulta. El objetivo externo mejora el rendimiento futuro en consultas a través de tareas. La meta‑validación ajusta opciones en tareas separadas, y la meta‑prueba evalúa tareas o clases realmente no vistas.
Meta‑aprendizaje basado en gradientes
Model-Agnostic Meta-Learning (MAML) aprende una inicialización desde la cual un pequeño número de gradient steps produce buen rendimiento en una nueva tarea. El bucle interno adapta los parámetros del modelo usando datos de soporte. El bucle externo actualiza la inicialización compartida usando la pérdida de consulta a través de tareas muestreadas.
MAML no se limita a la clasificación; puede aplicarse a regresión y reinforcement learning cuando el modelo y la tarea son diferenciables. Reptile ofrece un enfoque de primer orden más simple que mueve los parámetros hacia soluciones adaptadas a la tarea sin calcular el meta‑gradiente completo de MAML.
Meta‑aprendizaje basado en métricas
Los métodos basados en métricas aprenden una incrustación en la que los ejemplos de la misma clase están cercanos y las clases diferentes están separadas. Una red prototípica promedia las incrustaciones de soporte para formar un prototipo por clase, y luego clasifica las consultas por distancia a esos prototipos.
Las redes de coincidencia y estilo siamés utilizan mecanismos de similitud relacionados. Estos métodos no solo verifican si un modelo “alcaza una métrica objetivo”; la distancia o representación aprendida forma parte del procedimiento de predicción.
Métodos basados en memoria y optimizadores aprendidos
Los sistemas basados en memoria usan estado recurrente o basado en atención para almacenar información sobre la tarea actual. Los optimizadores aprendidos reciben gradientes o señales de entrenamiento como entradas y aprenden cómo actualizar otro modelo. Estos métodos pueden descubrir reglas de adaptación, pero añaden parámetros, cómputo y otro nivel de posible sobreajuste.
Meta‑aprendizaje y aprendizaje en contexto
Los grandes transformers pueden adaptar su salida a partir de ejemplos suministrados en un prompt sin actualizar los pesos. Esto se llama aprendizaje en contexto. Se asemeja al comportamiento del meta‑aprendizaje, y los datos de entrenamiento pueden fomentar la inferencia de tareas, pero un aprendiz en contexto no se entrena automáticamente con un objetivo clásico de meta‑aprendizaje episódico.
Dónde es útil el meta‑aprendizaje
Las aplicaciones potenciales incluyen personalización, robótica, reconocimiento con recursos limitados, tareas científicas con pocas mediciones y adaptación rápida a nuevos entornos. El meta‑aprendizaje es más atractivo cuando hay muchas tareas fuente relacionadas disponibles pero los datos de la tarea objetivo son escasos.
Limitaciones
El meta‑aprendizaje puede ser costoso computacionalmente porque el entrenamiento anida la adaptación dentro de la optimización. Los resultados son sensibles a la construcción de tareas, filtraciones entre soporte/consulta, arquitectura y cambio de dominio. Un modelo entrenado en tareas estrechas y homogéneas puede adaptarse pobremente fuera de esa distribución.
Las comparaciones deben incluir aprendizaje por transferencia ordinario y bases multitarea. Una representación preentrenada fuerte seguida de un ajuste fino estándar puede ser más simple y eficaz que un algoritmo de meta‑aprendizaje dedicado.
Tareas, adaptación y la estructura de optimización interna‑externa
El meta‑aprendizaje entrena sobre una distribución de tareas para que un aprendiz pueda adaptarse a una nueva tarea con datos o actualizaciones limitadas. Cada episodio muestrea una tarea, divide los ejemplos en un conjunto de soporte usado para la adaptación y un conjunto de consulta usado para la evaluación, y actualiza el conocimiento compartido a través de los episodios. Los métodos basados en métricas aprenden una incrustación y una regla de comparación; los métodos basados en optimización aprenden la inicialización o el comportamiento de actualización; los métodos basados en memoria y modelo se condicionan a los ejemplos de la tarea. La distribución de tareas es el verdadero conjunto de entrenamiento y debe asemejarse a los problemas de adaptación futuros.
En el meta‑aprendizaje agnóstico al modelo, un bucle interno adapta los parámetros sobre ejemplos de soporte y un bucle externo optimiza el rendimiento en ejemplos de consulta después de la adaptación. Los gradientes de orden superior pueden ser costosos; las aproximaciones de primer orden intercambian fidelidad por costo. Las redes prototípicas representan cada clase mediante un centroide del conjunto de soporte y clasifican por distancia. Estos métodos asumen que la geometría de clases, los pasos de adaptación y la construcción de episodios reflejan el despliegue. Un método puede aparentar aprender rápidamente mientras explota etiquetas fijas, artefactos de adquisición o superposición entre conjuntos de datos fuente.
Evaluación, bases de referencia y limitaciones del mundo real
Separar tareas de entrenamiento, validación y prueba —no solo ejemplos— para medir la adaptación a tareas realmente no vistas. Informar precisión o pérdida en función de los disparos y pasos de adaptación, intervalos de confianza a través de tareas, cómputo, memoria y sensibilidad a la composición del conjunto de soporte. Comparar con aprendizaje por transferencia, ajuste fino de un modelo preentrenado, vecinos más cercanos y un modelo entrenado conjuntamente con todos los datos fuente. Muchas ganancias aparentes del meta‑aprendizaje se reducen cuando las bases reciben arquitecturas, aumentación y afinación equivalentes.
Los despliegues reales necesitan una forma de reconocer cuándo una nueva tarea está fuera de la distribución de meta‑entrenamiento. Ejemplos de soporte pobres o mal etiquetados pueden causar fallos rápidos y seguros. Limitar la magnitud de las actualizaciones, validar los modelos adaptados, preservar una alternativa y proteger los datos de adaptación contra envenenamiento. Registrar el modelo base, el muestreador de tareas, las semillas de episodios y el código de adaptación. El meta‑aprendizaje es útil para familias repetidas de problemas con pocos datos, pero no crea una capacidad de aprendizaje general a partir de ejemplos arbitrarios y no elimina la necesidad de evaluación específica del dominio.
Ejemplo práctico: adaptación few‑shot entre máquinas
Un fabricante trata cada tipo de máquina como una tarea y meta‑entrena una representación de anomalías a través de muchas máquinas con resultados de mantenimiento verificados. Las máquinas de prueba se excluyen totalmente del entrenamiento de tareas. Para una máquina nueva, un pequeño conjunto de soporte cubre los modos de operación normales en lugar de minutos arbitrarios de datos. El meta‑aprendizaje se compara con un codificador preentrenado congelado, vecinos más cercanos y ajuste fino ordinario usando los mismos ejemplos de soporte y cómputo.
La evaluación repite muchas selecciones de soporte y reporta recall de eventos, falsas alarmas, tiempo de adaptación y varianza. El sistema se abstiene cuando el conjunto de sensores o la dinámica de la nueva máquina quedan fuera de la distribución de tareas. Las actualizaciones de adaptación están limitadas y se revisan antes de influir en el mantenimiento. Las etiquetas de soporte y la identidad de la máquina están protegidas contra envenenamiento, y cada modelo adaptado conserva su versión base y ejemplos. La adaptación rápida se acepta solo si supera consistentemente a la transferencia más simple bajo un cambio de tarea realista.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Definir los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establecer una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Probar casos ordinarios, condiciones límite, entradas mal formadas o ausentes, cambio de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Medir la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registrar cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asignar autoridad para la liberación, excepciones, cambios, reversión y retiro. Utilizar un despliegue escalonado, preservar una alternativa segura y verificar la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Definir umbrales de alerta y un responsable de respuesta, luego revisar la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevaluar siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿El prompting few-shot es meta‑aprendizaje?
El prompting few-shot es una técnica de adaptación en contexto. Puede mostrar un comportamiento asociado al aprendizaje a través de tareas, pero no se entrena automáticamente con episodios de soporte/consulta ni con un bucle de meta‑optimización explícito.
¿Cuál es el mayor riesgo del meta‑aprendizaje?
Una descoordinación entre las tareas de meta‑entrenamiento y la tarea objetivo puede hacer que la adaptación rápida parezca fuerte en una referencia, pero falle en el despliegue. Las divisiones de tareas y la procedencia de los datos fuente deben auditarse con la misma rigurosidad que las divisiones de entrenamiento/prueba habituales.
Referencias principales











