
Fundamentos de la IA
Aprendizaje supervisado vs aprendizaje no supervisado

 Añade Unite.AI a tus fuentes preferidas en Google
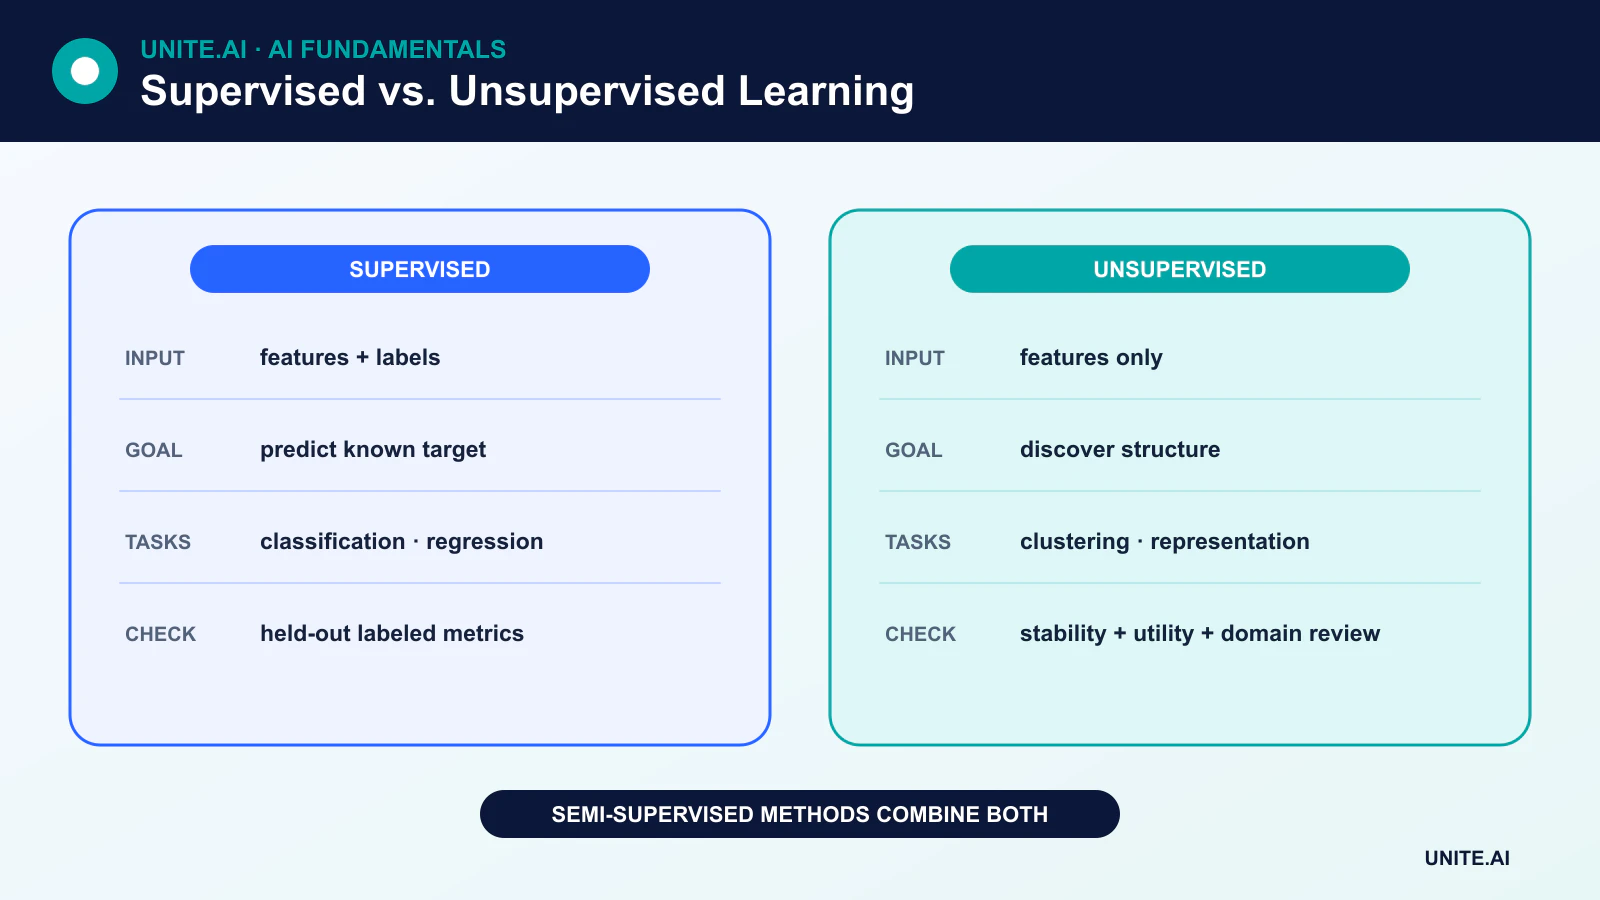
Aprendizaje supervisado aprende a partir de ejemplos emparejados con respuestas objetivo. Aprendizaje no supervisado busca estructura en los datos sin etiquetas objetivo. La diferencia no es cuál enfoque es más inteligente o preciso; es el tipo de señal de aprendizaje disponible y la pregunta que el sistema está diseñado para responder.
Estos son dos paradigmas principales dentro del aprendizaje automático, pero los sistemas modernos también utilizan aprendizaje semi‑supervisado, auto‑supervisado y por refuerzo.
Puntos clave
- El aprendizaje supervisado predice un objetivo conocido; el aprendizaje no supervisado descubre patrones o representaciones.
- Clasificación y regresión son tareas supervisadas; agrupamiento, estimación de densidad y muchos métodos de reducción de dimensionalidad son no supervisados.
- Las salidas no supervisadas no son automáticamente clases del mundo real y pueden ser más difíciles de evaluar.
- El costo computacional y la precisión dependen del algoritmo, los datos, la tarea y la evaluación, no solo del paradigma.
Cómo funciona el aprendizaje supervisado
Un conjunto de datos supervisado contiene características X y un objetivo y. El entrenamiento ajusta un modelo de modo que sus predicciones se aproximen a los objetivos. La evaluación usa ejemplos etiquetados reservados para estimar qué tan bien generaliza.
Clasificación
La clasificación predice una categoría: spam o no spam, un tema de documento entre varios, o uno o más objetos en una imagen. Las métricas relevantes incluyen precisión, exhaustividad, F1, calibración y medidas sensibles al costo. La exactitud puede ser engañosa cuando una clase es rara; una matriz de confusión revela qué clases se confunden.
Regresión
La regresión predice un valor continuo, como demanda, duración o temperatura. La regresión lineal puede usar una o muchas características; no se limita a dibujar una relación entre dos variables. Las métricas de regresión incluyen error absoluto medio, raíz del error cuadrático medio y costos específicos de la tarea.
Algoritmos supervisados comunes
Los métodos supervisados incluyen modelos lineales y logísticos, árboles de decisión, bosques aleatorios, gradient boosting, máquinas de vectores de soporte, K‑nearest neighbors y redes neuronales.
La regresión logística produce una puntuación o probabilidad que puede convertirse en una clase usando un umbral elegido. Una hoja de árbol de decisión contiene una predicción basada en una región del espacio de características, no necesariamente en una observación de entrenamiento. KNN predice a partir de ejemplos de entrenamiento etiquetados cercanos y aún requiere un diseño sólido de entrenamiento/validación/prueba.
Cómo funciona el aprendizaje no supervisado
El aprendizaje no supervisado recibe características sin una columna objetivo. Su objetivo se define indirectamente —por ejemplo, minimizar la distancia dentro de los grupos, reconstruir una entrada, estimar la densidad de los datos o retener la mayor varianza posible en menos dimensiones.
Agrupamiento
K‑means asigna puntos a un número elegido de grupos y actualiza los centros de los grupos para reducir la distancia cuadrática intra‑grupo. El algoritmo descubre agrupaciones geométricas bajo una distancia y representación de características particulares. Esos grupos no corresponden automáticamente a tipos de clientes, diagnósticos u otras etiquetas de dominio significativas.
Reducción de dimensionalidad
La reducción de dimensionalidad representa los datos usando menos variables. El análisis de componentes principales encuentra direcciones ortogonales que retienen la mayor varianza posible bajo una proyección lineal. Otros métodos preservan distintas nociones de estructura y pueden producir visualizaciones muy diferentes.
Detección de anomalías y estimación de densidad
Los métodos no supervisados pueden estimar dónde los datos son densos y señalar observaciones inusuales. Una puntuación de anomalía no prueba fraude, falla o comportamiento malicioso; identifica una desviación bajo la representación y el modelo elegidos.
Cómo se evalúa el aprendizaje no supervisado
No existe una noción universal de “exactitud” no supervisada. Un profesional puede usar métricas internas como la puntuación de silueta, comparar la estabilidad entre muestras, probar la utilidad en una tarea posterior, o preguntar a expertos del dominio si la estructura descubierta es significativa. Si existen etiquetas de referencia para la evaluación, pueden usarse métricas externas de agrupamiento sin convertir el proceso de entrenamiento en aprendizaje supervisado.
Más allá de la comparación binaria
Aprendizaje semi‑supervisado
El aprendizaje semi‑supervisado combina un conjunto pequeño etiquetado con un conjunto grande no etiquetado. El pseudoetiquetado, la regularización por consistencia y los métodos basados en grafos son ejemplos. Los datos no etiquetados deben seguir asemejándose lo suficiente a la distribución objetivo para ser útiles.
Aprendizaje auto‑supervisado
El aprendizaje auto‑supervisado deriva objetivos a partir de la propia entrada, como predecir tokens enmascarados o emparejar vistas transformadas. Es una base para los modelos modernos de lenguaje, visión y multimodales, incluidos los transformers.
Aprendizaje por refuerzo
El aprendizaje por refuerzo optimiza decisiones mediante recompensas generadas por la interacción. Difiere tanto de la predicción etiquetada como del descubrimiento estático de patrones.
Elegir el enfoque adecuado
Comience con la decisión o el insight que el sistema debe producir. Si existen objetivos fiables y la meta es la predicción, el aprendizaje supervisado es natural. Si el objetivo es exploración, representación o agrupamiento, un método no supervisado puede ajustarse. Cuando las etiquetas son escasas, el preentrenamiento auto‑supervisado o semi‑supervisado seguido de evaluación supervisada puede ser más efectivo.
En cualquier caso, la fuga de datos, el muestreo sesgado, los proxies débiles y el cambio de distribución pueden dominar la elección del algoritmo. Un modelo técnicamente correcto entrenado con el objetivo equivocado aún puede fallar.
Señales de aprendizaje, objetivos y métodos representativos
El aprendizaje supervisado usa ejemplos emparejados con etiquetas o valores objetivo y optimiza el error predictivo. Clasificación, regresión, ranking y predicción estructurada difieren en salida y pérdida. El aprendizaje no supervisado busca estructura sin etiquetas objetivo mediante agrupamiento, estimación de densidad, reducción de dimensionalidad, aprendizaje de representaciones o modelado generativo. El aprendizaje auto‑supervisado crea objetivos de predicción a partir de los propios datos, mientras que el aprendizaje semi‑supervisado combina un pequeño conjunto etiquetado con datos no etiquetados más amplios. Estas categorías describen la señal de aprendizaje; la misma arquitectura neuronal puede entrenarse bajo varios paradigmas.
Las etiquetas hacen explícito un objetivo pero introducen costo de anotación, ruido, supuestos de política y retraso temporal. Los datos no etiquetados son más fáciles de recopilar pero no indican al algoritmo qué estructura descubierta es útil. Un grupo puede reflejar iluminación, longitud del documento o fuente de adquisición en lugar de una categoría significativa. Defina la evaluación de forma independiente: los modelos supervisados usan resultados etiquetados reservados, mientras que los modelos no supervisados requieren estabilidad, reconstrucción, verosimilitud, recuperación, utilidad en tareas posteriores o validación experta. La separación visual por sí sola no prueba la validez de la estructura.
Elegir un paradigma y prevenir errores comunes
Use aprendizaje supervisado cuando exista un objetivo estable y etiquetas representativas. Use exploración no supervisada para resumir, detectar novedad, comprimir o generar hipótesis, pero trate las salidas como provisionales. El preentrenamiento auto‑supervisado es valioso cuando los datos crudos son abundantes y las tareas posteriores comparten representaciones. Los métodos semi‑supervisados solo ayudan cuando se cumplen los supuestos sobre los datos no etiquetados y la estructura de clases. Compare con líneas base simples y tenga en cuenta el costo total de recolección, etiquetado, revisión, cómputo y errores, en lugar de asumir que lo no etiquetado es automáticamente barato.
Prevenga fugas separando entidades relacionadas antes de derivar etiquetas, aumentos o pseudoetiquetas. Monitoree el equilibrio de clases, el acuerdo de anotación, la estabilidad de los grupos, colapsos y deriva. Las pseudoetiquetas pueden reforzar errores tempranos; el agrupamiento puede codificar atributos sensibles; una representación preentrenada puede transferir sesgos de origen. La revisión humana debe centrarse en casos límite y consecuencias. En producción, documente cómo se creó la señal de aprendizaje y cuándo queda obsoleta. El paradigma determina dónde entra la supervisión en el sistema, no si existen decisiones y valores humanos.
Ejemplo práctico: descubrimiento y etiquetado de temas de soporte
Una empresa primero usa incrustaciones y agrupamiento no supervisados para explorar temas en mensajes de soporte desidentificados. Los analistas inspeccionan ejemplos representativos y límite y descubren que algunos grupos reflejan longitud del mensaje y canal en lugar de problemas. Desarrollan una taxonomía supervisada con una clase desconocida, guía de anotación y acuerdo medido. Luego se evalúa un clasificador en períodos posteriores, idiomas y productos contra líneas base de palabras clave y vecinos más cercanos.
Los nuevos mensajes no etiquetados permiten descubrir deriva, pero no reentrenan el clasificador automáticamente. Los revisores etiquetan casos inciertos y emergentes seleccionados mediante aprendizaje activo, con controles de calidad y un conjunto de evaluación sellado. El monitoreo rastrea la prevalencia de temas, confianza, desacuerdo y resultados de encaminamiento. Cuando se lanza un nuevo producto, la taxonomía y la capacidad de los equipos posteriores se actualizan conjuntamente. El flujo de trabajo usa métodos no supervisados para generación de hipótesis y evidencia supervisada para encaminamiento operativo.
Pruebas de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, cambio de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para liberación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, sobresesiones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos cambien. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Referencias principales












