Fundamentos de la IA
¿Qué es el clustering K-means?

 Añade Unite.AI a tus fuentes preferidas en Google
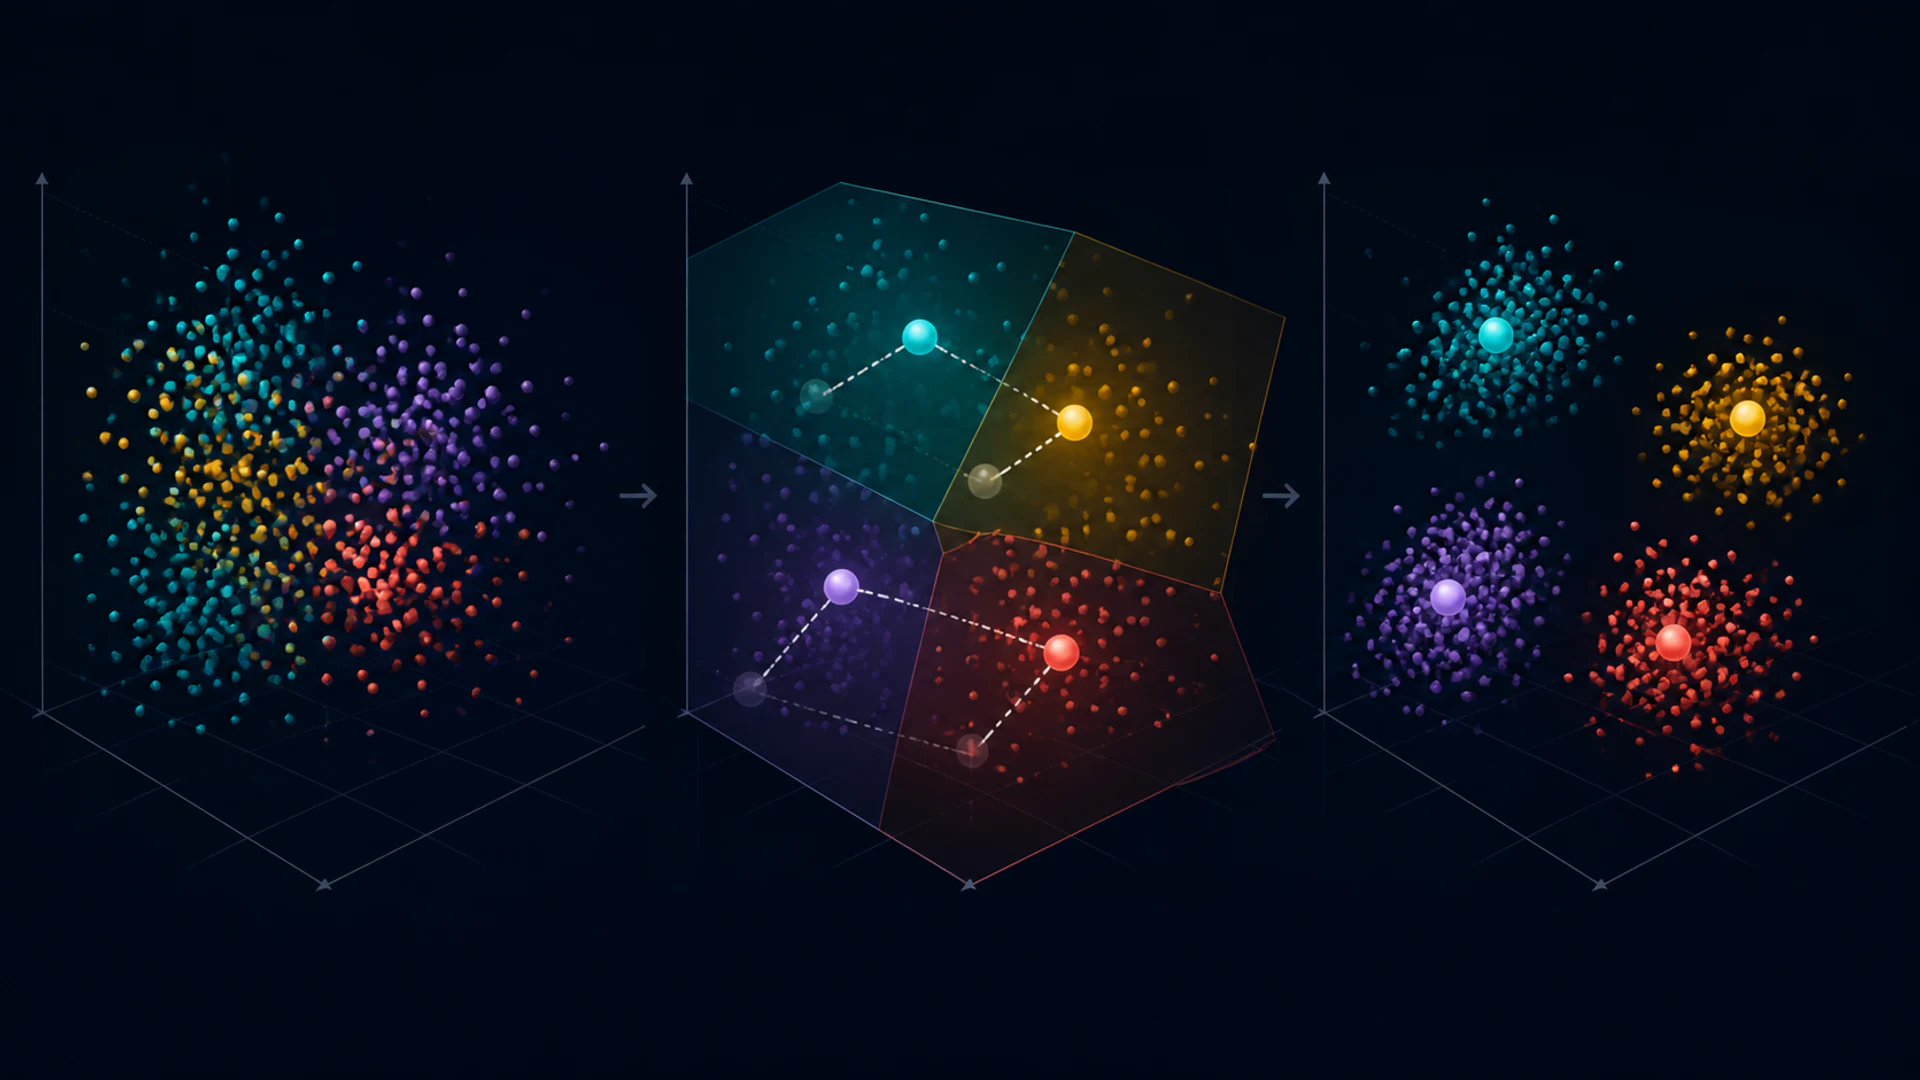
K-means es un algoritmo no supervisado que parte observaciones numéricas en k clústeres. Alterna entre asignar cada punto a su centroide más cercano y recalcular cada centroide como la media de los puntos asignados.
El algoritmo es rápido y útil, pero su resultado depende del escalado, la distancia, la inicialización y el valor de k elegido. Un clúster es una partición matemática, no automáticamente una categoría del mundo real.
Puntos clave
- K-means minimiza la distancia euclidiana cuadrada dentro del clúster a los centroides.
- La inicialización es importante; k-means++ dispersa los centroides iniciales y suele mejorar los resultados.
- Se deben estandarizar las características cuando sus unidades o escalas deben contribuir de forma comparable.
- K-means tiene dificultades con valores atípicos, clústeres no esféricos, densidades desiguales y datos categóricos.
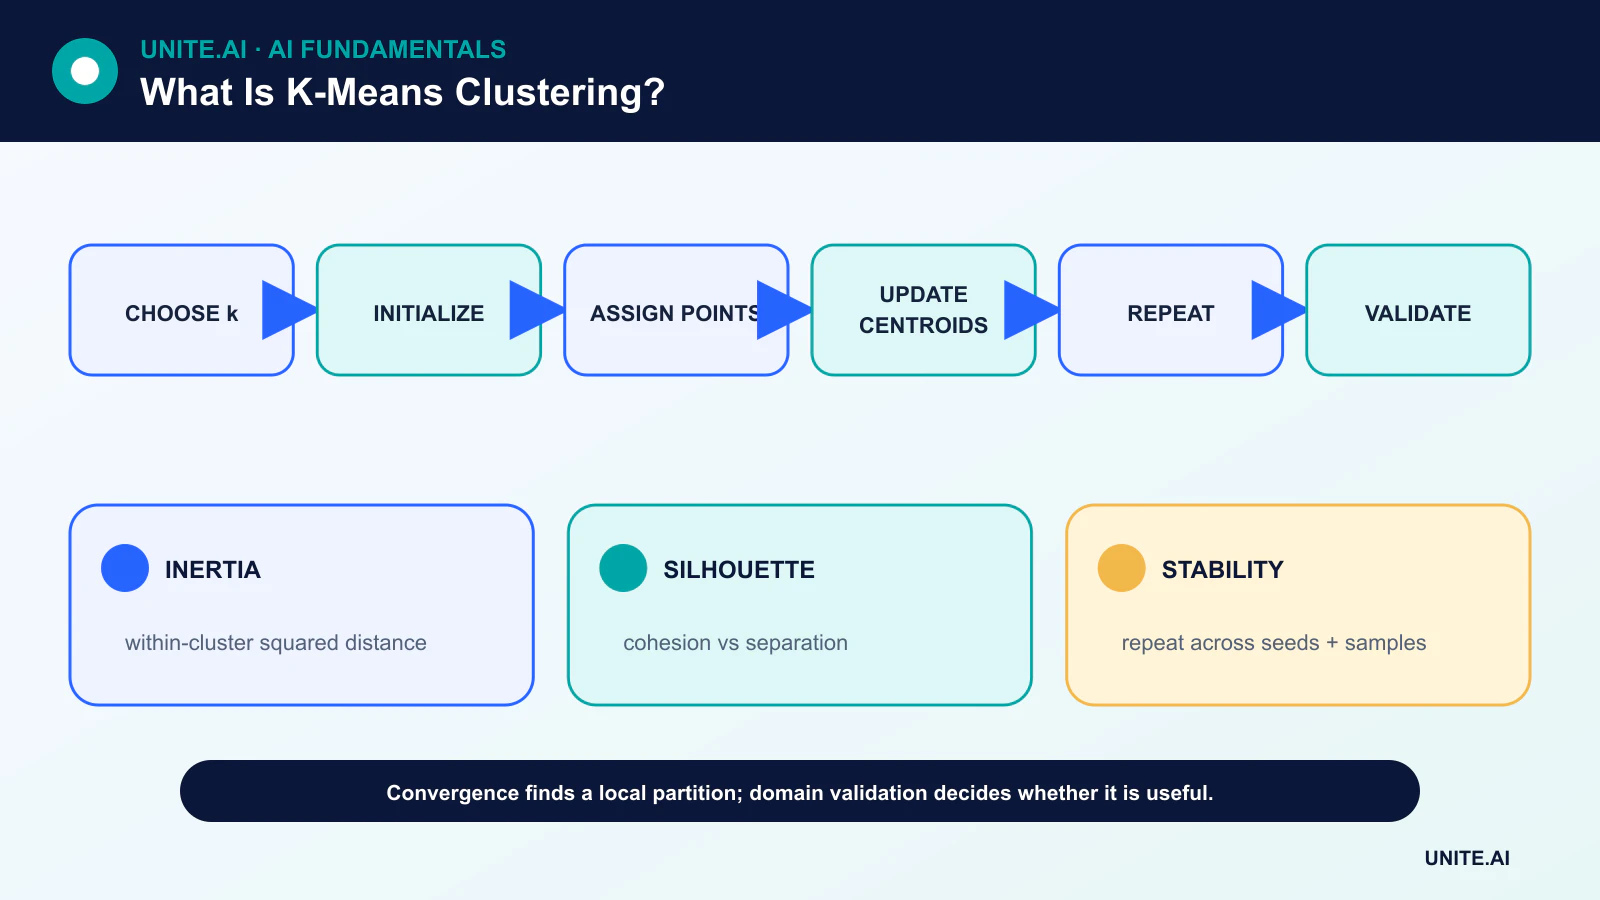
El objetivo y el bucle de actualización
Dado k centroides, el paso de asignación envía cada observación al más cercano. El paso de actualización reemplaza cada centroide por la media de sus observaciones asignadas. La suma de cuadrados dentro del clúster no puede aumentar con estos pasos, por lo que el proceso converge a un óptimo local.
La convergencia no garantiza el óptimo global. Diferentes centroides iniciales pueden producir distintas particiones, por lo que las implementaciones ejecutan varias inicializaciones y conservan la solución con la menor inercia.
Inicialización y k-means++
Seleccionar aleatoriamente todos los centroides iniciales de una sola región densa puede generar una solución pobre o una convergencia lenta. k-means++ elige semillas con una probabilidad relacionada con la distancia a las semillas existentes, fomentando una cobertura del conjunto de datos.
Ejecutar múltiples iteraciones sigue siendo útil. Registre la semilla aleatoria y el número de inicializaciones para que los resultados puedan reproducirse.
Escalado y distancia
La distancia euclidiana cuadrada hace que K-means sea sensible a las unidades. Una característica medida en miles puede dominar a otra medida entre cero y uno. La estandarización es habitual, pero el conocimiento del dominio debe decidir si una varianza estandarizada igual refleja una importancia igual.
Los valores atípicos pueden desplazar la media lejos de los puntos típicos. Un escalado robusto, recorte o métodos basados en medoids pueden ser mejores. Las características categóricas codificadas en one‑hot crean una geometría de distancia que puede no coincidir con la similitud de categorías.
Elegir k y validar los clústeres
La inercia disminuye cada vez que k aumenta, por lo que no puede usarse sola para seleccionar k. La heurística del codo busca una mejora decreciente. El análisis de silueta compara cohesión y separación. La estabilidad entre muestras y semillas añade otra verificación.
La validación más fuerte es la utilidad para el dominio previsto. Compare los clústeres con resultados conocidos, revisión de expertos o una tarea posterior sin pretender que las etiquetas post‑hoc fueron descubiertas objetivamente.
Limitaciones y alternativas
K-means favorece grupos compactos, aproximadamente esféricos y de escala similar. Los modelos de mezcla gaussiana representan componentes elipsoidales probabilísticos; los métodos tipo DBSCAN identifican regiones densas y ruido; el clustering jerárquico produce un árbol de fusiones.
La reducción de dimensionalidad puede mejorar la velocidad o eliminar ruido de las entradas, pero ajustarla en todo el conjunto de datos puede cambiar la cuestión de validación. Mini‑batch K-means reduce el cómputo para conjuntos de datos grandes a costa de una actualización aproximada.
Objetivo, inicialización y convergencia
K-means divide las observaciones numéricas en k clústeres minimizando la distancia euclidiana cuadrada dentro del clúster a los centroides. El algoritmo de Lloyd alterna la asignación de cada punto al centroide más cercano y el recálculo de los centroides hasta que las asignaciones o el objetivo se estabilizan. Converge a un óptimo local, no necesariamente al mejor global. La inicialización k-means++ dispersa los centros iniciales y suele mejorar los resultados, pero múltiples semillas siguen siendo importantes. Estandarice las características cuando las unidades deben contribuir de forma comparable, ya que la distancia al cuadrado magnifica variables de gran escala y valores atípicos.
El método asume clústeres aproximadamente compactos, esféricos y de escala similar bajo geometría euclidiana. Tiene dificultades con variedades alargadas, densidad desigual, datos categóricos, valores atípicos intensos y estructuras anidadas. Los clústeres vacíos y los puntos duplicados requieren un manejo definido. Mini‑batch k-means escala a datos grandes con un compromiso de aproximación. Para texto disperso, el k‑means esférico orientado al coseno puede ajustarse mejor a la dirección, mientras que mezclas, métodos de densidad, clustering jerárquico o k‑medoids codifican otras suposiciones.
Elegir k y validar el significado
Las curvas del codo, los puntajes de silueta, los criterios de información en modelos relacionados y la estabilidad pueden orientar la elección de k, pero ninguno descubre un número exclusivamente correcto. La utilidad empresarial y la interpretación del dominio son importantes. Reajuste a través de muestras y semillas, compare el movimiento de centroides y la consistencia de asignaciones, y valide los clústeres con resultados independientes no usados para formarlos. Una proyección bidimensional puede distorsionar la separación, por lo que conviene examinar distancias y ejemplos en el espacio de representación original o validado.
Los clústeres son grupos descriptivos creados por las características y la métrica seleccionadas; no son tipos naturales ni segmentos causales. Los perfiles basados en las mismas variables usadas para el clustering pueden ser circulares. Use atributos reservados y revisión cualitativa, e inspeccione si los clústeres reproducen principalmente la geografía, la fuente de datos o rasgos sensibles. Los clústeres pequeños pueden ser anomalías o artefactos. Nombrar un clúster no hace que todos sus miembros encajen en la etiqueta.
Despliegue y mantenimiento
Almacene el escalado, el orden de las características, los centroides, la definición de distancia y las etiquetas de clúster juntos. Para nuevos puntos, monitoree la distancia al centroide asignado y la fracción que está muy más allá del soporte de entrenamiento; proporcione un estado desconocido en lugar de forzar cada caso a un clúster. Rastree el tamaño de los clústeres, los centroides y la relevancia de los resultados a lo largo del tiempo. El reentrenamiento cambia las identidades de los clústeres, por lo que es necesario mapear o versionar las reglas posteriores en lugar de reutilizar silenciosamente nombres antiguos. K-means es una línea base útil de compresión y segmentación cuando su geometría coincide con la pregunta, no un motor de descubrimiento universal.
Ejemplo práctico: segmentación de clientes con k-means
Una empresa de suscripción estandariza las características de uso durante una ventana fija, elimina los identificadores de cuentas y prueba k con distintas semillas. Se revisan la estabilidad, la silueta y los resultados comerciales reservados, pero los equipos de producto también inspeccionan cuentas representativas y límite. Descubren que un clúster es simplemente clientes nuevos con observación más corta, por lo que la permanencia se maneja explícitamente. K-means se compara con alternativas jerárquicas y basadas en densidad en lugar de asumir su idoneidad. El ejercicio se trata como aprendizaje no supervisado, no descubrimiento de etiquetas.
Los segmentos guían la investigación y los experimentos de mensajería, no la elegibilidad o el precio. Las cuentas nuevas que están lejos de cualquier centroide reciben una asignación desconocida. El escalado, las características, los centroides y los nombres se versionan, y el reentrenamiento asigna los nuevos clústeres a los antiguos solo con evidencia. El monitoreo rastrea el tamaño del clúster, la distancia y la relevancia de los resultados. Los atributos sensibles y los proxies se auditan, y el equipo evita describir los clústeres como tipos de personalidad naturales cuando son particiones matemáticas de comportamientos seleccionados.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, conserve una alternativa segura y verifique el monitoreo con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Es K-means supervisado o no supervisado?
Es no supervisado porque recibe características y un número de clústeres elegido, no etiquetas objetivo.
¿Clasifica K-means datos nuevos?
Después de entrenar, un nuevo punto puede asignarse a su centroide más cercano. Eso es asignación a un clúster, no necesariamente una predicción de clase supervisada.
Referencias principales