
Fundamentos de la IA
¿Qué es un autoencoder?

 Añade Unite.AI a tus fuentes preferidas en Google
Un autoencoder es una red neuronal entrenada para reconstruir su entrada. Un codificador asigna la entrada a una representación latente; un decodificador convierte esa representación de nuevo en una reconstrucción. El entrenamiento minimiza una pérdida de reconstrucción, a veces con restricciones adicionales.
Copiar la entrada perfectamente no es automáticamente útil. La arquitectura o el objetivo deben crear un cuello de botella, añadir ruido, imponer escasez o, de otro modo, impedir un mapeo idéntico trivial para que el código latente capture una estructura útil.
Conclusiones clave
- El codificador comprime o transforma una entrada; el decodificador la reconstruye a partir de un código latente.
- Un cuello de botella subcompleto, ruido o regularización fomentan que el modelo aprenda estructura en lugar de copiar.
- El error de reconstrucción puede respaldar la detección de anomalías, pero no se garantiza que las anomalías tengan un error alto.
- Los autoencoders variacionales aprenden un modelo latente probabilístico y difieren de los autoencoders deterministas.
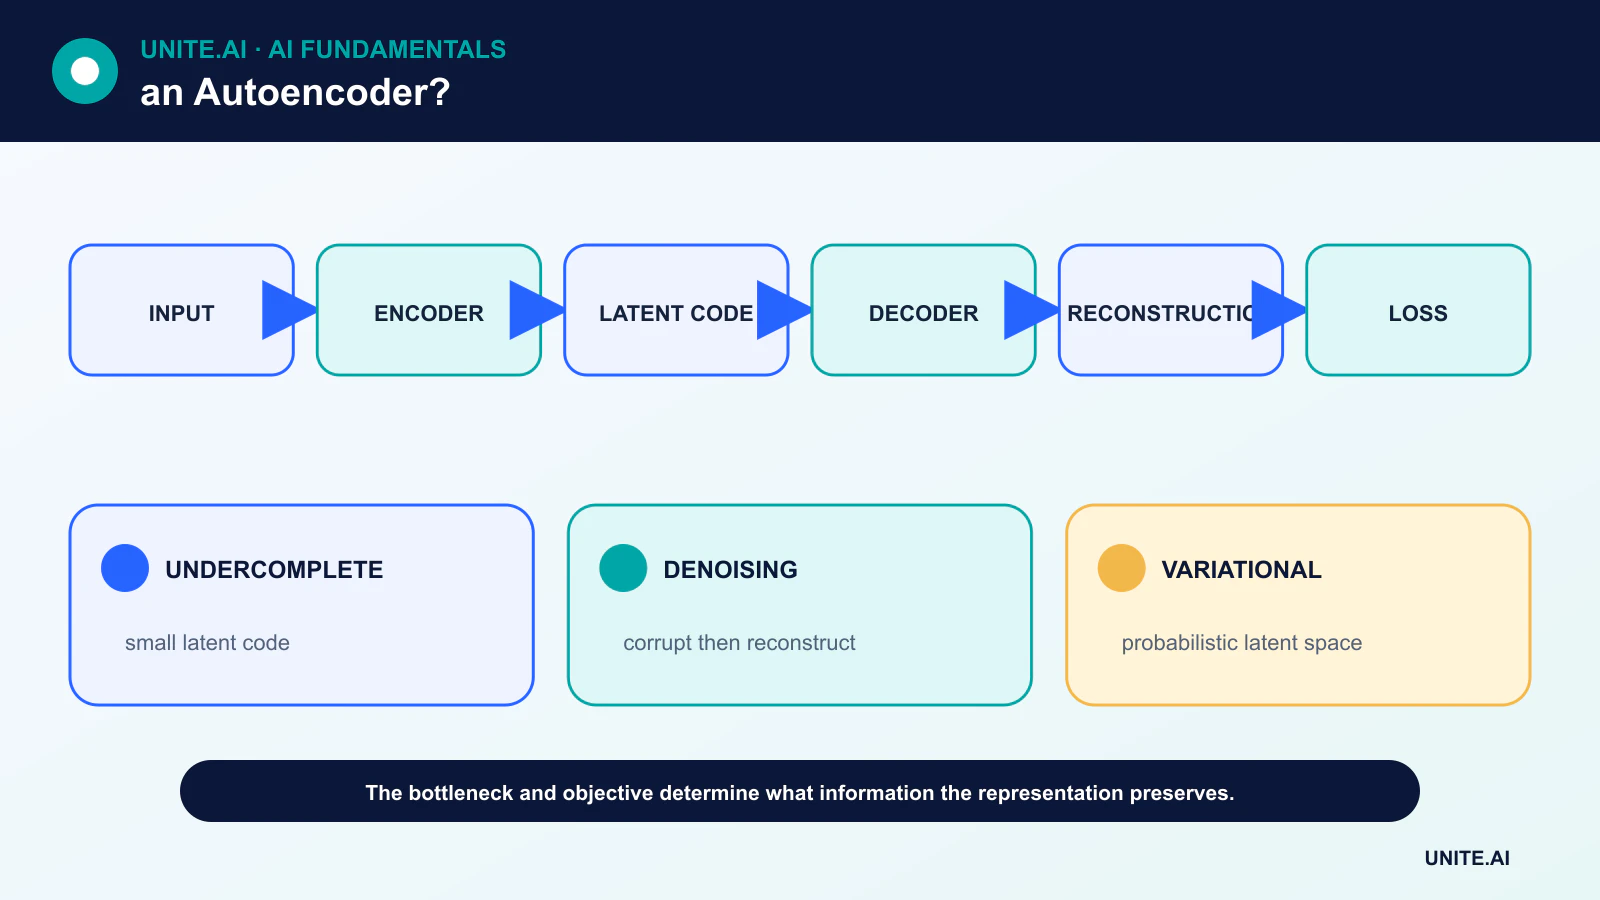
Codificador, espacio latente y decodificador
Para la entrada x, el codificador produce el código latente z = f(x) y el decodificador produce la reconstrucción x̂ = g(z). La pérdida compara x y x̂, por ejemplo con error cuadrático medio para valores continuos o con una verosimilitud adecuada a los datos.
La dimensión latente puede ser menor que la de la entrada, creando un autoencoder subcompleto. Una red profunda también puede aprender representaciones no lineales, ampliando la idea detrás de la reducción de dimensionalidad.
Variantes comunes de autoencoders
Un autoencoder escaso penaliza la activación generalizada. Un autoencoder de denoising recibe una entrada corrupta y reconstruye la versión limpia. Un autoencoder contractivo penaliza la sensibilidad del código a pequeños cambios en la entrada.
Un autoencoder variacional (VAE) codifica los parámetros de una distribución de probabilidad, muestra un valor latente y equilibra la reconstrucción con un término de regularización que da forma al espacio latente. Esto permite muestrear, pero cambia el objetivo y la interpretación.
Entrenamiento y evitación de soluciones triviales
Los autoencoders usan propagación hacia atrás como otras redes neuronales. Una red con capacidad excesiva puede memorizar los ejemplos de entrenamiento o aprender una función casi idéntica. El tamaño del cuello de botella, la corrupción, las penalizaciones y la validación con datos no vistos lo restringen.
La elección de la pérdida es importante. Una pérdida a nivel de píxel puede producir reconstrucciones borrosas, mientras que las pérdidas perceptuales heredan supuestos de otra red. La mejor métrica de reconstrucción no es necesariamente la mejor medida de similitud semántica.
Usos y limitaciones
Los autoencoders pueden aprender características, eliminar ruido de señales, comprimir datos, inicializar modelos y producir variables latentes para visualización. Para detección de anomalías, un modelo entrenado con datos normales puede asignar un mayor error de reconstrucción a entradas inusuales.
Ese enfoque puede fallar cuando el autoencoder también reconstruye bien las anomalías o cuando una variación inocua es más difícil de reconstruir que la anomalía objetivo. Los umbrales necesitan datos de validación etiquetados o revisados cuidadosamente, y el error debe monitorizarse por subgrupo y condición operativa.
Autoencoders frente a otros modelos generativos
Un autoencoder determinista no es automáticamente un modelo generativo probabilístico. Los VAE definen una distribución latente estructurada; los GAN entrenan un generador contra un discriminador; los modelos de difusión aprenden un proceso de denoising.
La elección depende de si el objetivo es reconstrucción, representación, verosimilitud, fidelidad de muestra, controlabilidad o puntuación de anomalías. Un modelo específico de tarea más pequeño suele ser más práctico que un gran generador de imágenes.
Objetivos codificador‑decodificador y representaciones latentes
Un autoencoder aprende un codificador que asigna la entrada x a un código latente z y un decodificador que reconstruye x a partir de z. Si la capacidad no está restringida, puede aprender un mapeo idéntico con poca estructura útil. Los cuellos de botella, la regularización, la corrupción, la escasez o las restricciones arquitectónicas obligan a una representación que conserva la información seleccionada. La pérdida de reconstrucción define qué se considera similar: el error cuadrático medio favorece la fidelidad promedio de píxeles, mientras que las pérdidas perceptuales o específicas de modalidad enfatizan diferentes rasgos. Una pérdida baja no garantiza significado semántico.
Los autoencoders subcompletos limitan la dimensión latente. Los autoencoders de denoising reconstruyen datos limpios a partir de entradas corruptas. Las variantes escasas penalizan la activación; las variantes contractivas penalizan la sensibilidad. Los autoencoders variacionales aprenden una distribución latente probabilística combinando la reconstrucción con un término de divergencia, lo que permite muestrear pero altera el objetivo. Los autoencoders convolucionales, de secuencia, de grafos y basados en transformadores codifican la estructura de la modalidad. Elija el tamaño latente y la regularización mediante validación posterior, no solo por gráficos bidimensionales atractivos.
Detección de anomalías, compresión y evaluación
Para detección de anomalías, entrene con datos normales representativos y evalúe el error de reconstrucción o la verosimilitud latente, pero las anomalías a veces pueden reconstruirse bien y los casos normales raros pueden hacerlo mal. Seleccione umbrales en casos de validación etiquetados o revisados, informe la recuperación a nivel de evento y las falsas alarmas, y pruebe cambios en el estado operativo. Compárese con líneas base estadísticas simples y de una sola clase. Para compresión, cuente el códec completo —incluyendo el tamaño del modelo, cuantización, metadatos y cómputo de decodificación— y compare la calidad a una tasa de bits equivalente con códecs establecidos.
La calidad de la representación puede evaluarse mediante sondas lineales, estabilidad de agrupamiento, recuperación, reconstrucción y tareas posteriores, cada una respondiendo a una pregunta distinta. Evite filtraciones al aprender el codificador y al seleccionar umbrales. Inspeccione qué características ignora la pérdida y si atributos sensibles siguen codificados. Un latente comprimido no está automáticamente anonimizado; la inversión y la inferencia de atributos pueden recuperar información privada. Las reconstrucciones generadas también pueden parecer plausibles mientras alteran detalles críticos.
Despliegue y monitorización
Versione el codificador y el decodificador juntos, valide los cambios numéricos después de la exportación y preserve la escala de entrada. Monitoree la distribución de reconstrucción, la deriva latente, las alertas de umbral y los resultados confirmados. En la monitorización industrial, condicione el modelo al modo operativo para que las transiciones normales no se consideren fallas. Para reconstrucción médica o científica, nunca presente un detalle generado como evidencia medida sin validación y procedencia. Los autoencoders son aprendices de representación flexibles, pero son las restricciones y la pérdida —no el nombre de la arquitectura— las que determinan qué información se conserva, descarta o fabrica.
Ejemplo práctico: un autoencoder para anomalías en bombas
Un autoencoder subcompleto aprende ventanas de vibración a partir de operaciones de bomba saludables verificadas, cubriendo carga y temperatura. Se compara con umbrales estadísticos y métodos de una sola clase, y su umbral de reconstrucción se selecciona en transiciones normales revisadas y fallas conocidas. La evaluación usa recuperación de eventos, tiempo de anticipación de alerta, falsas alarmas por hora de operación y resultados por bomba, no ventanas aleatorias que colocan muestras adyacentes en entrenamiento y prueba.
El modelo de producción se condiciona al estado operativo y expone patrones residuales a los ingenieros. Un error alto solicita inspección; no diagnostica la pieza ni detiene la bomba automáticamente. Desconexiones de sensores, recortes y cargas no vistas generan estados explícitos inválidos. La monitorización rastrea la distribución de reconstrucción, la confirmación de alertas y la salud del sensor. Cuando el mantenimiento o cambios de hardware alteran la línea base, el modelo antiguo sigue disponible mientras se entrena un candidato con datos revisados y se prueba contra incidentes históricos.
Pruebas de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Use un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿Los autoencoders son compresión sin pérdida?
No en general. Suelen aprender representaciones con pérdida específicas de la tarea y la distribución, y requieren el decodificador entrenado para reconstruir los datos.
¿Cada cuello de botella es interpretable?
No. Un código compacto puede ser útil sin que cada dimensión se corresponda con un concepto legible por humanos.
Referencias principales












