
Fundamentos de la IA
¿Qué son las máquinas de vectores de soporte?

 Añade Unite.AI a tus fuentes preferidas en Google
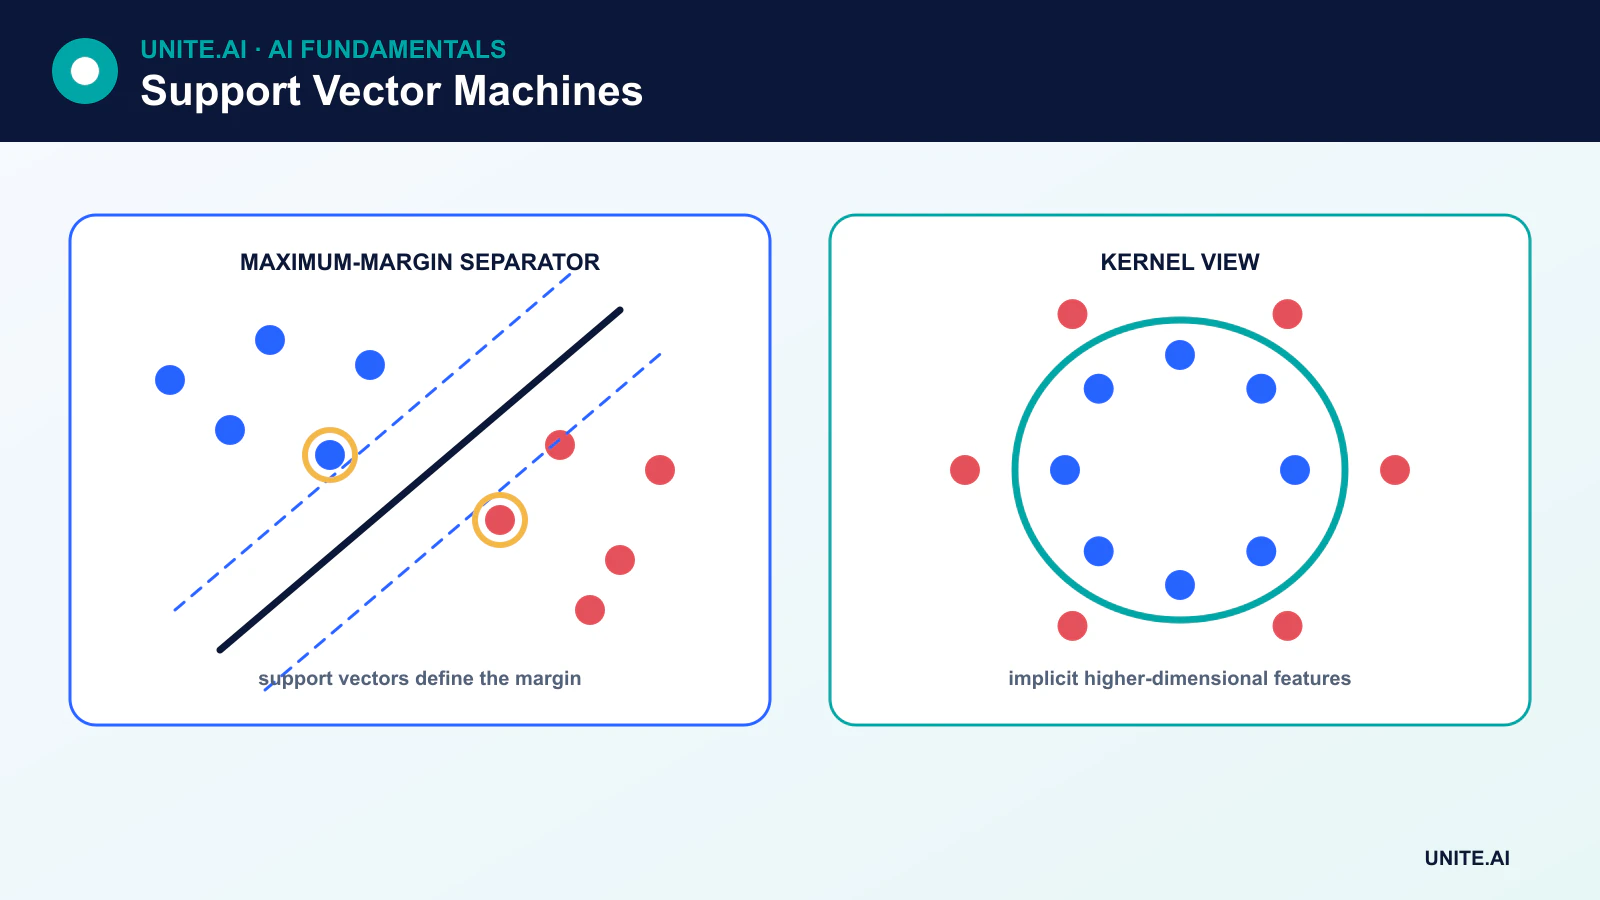
Una máquina de vectores de soporte (SVM) es un método de aprendizaje supervisado que encuentra una frontera de decisión con el margen más amplio posible entre clases. Los ejemplos de entrenamiento que determinan esa frontera son los vectores de soporte.
Las SVM pueden realizar clasificación lineal o no lineal, regresión y detección de novedades. Son especialmente útiles para conjuntos de datos pequeños a medianos con características informativas, incluidos datos dispersos de alta dimensión, aunque su costo de entrenamiento puede volverse impráctico en conjuntos de datos muy grandes.
Puntos clave
- Una SVM maximiza el margen mínimo entre la frontera y los puntos de entrenamiento más cercanos.
- Los vectores de soporte son puntos de datos, no hiperplanos adicionales.
- El parámetro C equilibra el ancho del margen con las penalizaciones por violaciones.
- Los kernels calculan la similitud en un espacio de características implícito sin materializar explícitamente cada característica transformada.
La idea del margen máximo
Para un clasificador binario lineal, la frontera de decisión es un hiperplano:
w · x + b = 0
El vector w determina la orientación y b el desplazamiento. Muchos hiperplanos pueden separar las clases de entrenamiento. La SVM elige aquel que maximiza la distancia a los ejemplos más cercanos a cada lado. Esos ejemplos más cercanos son los vectores de soporte y tienen la mayor influencia en la frontera ajustada.
El objetivo no es maximizar la distancia entre la frontera y cada punto de forma independiente. Se maximiza el margen mínimo mientras se satisfacen o penalizan las restricciones de clase.
Márgenes duros y blandos
Una SVM de margen duro requiere una separación lineal perfecta y es sensible a los valores atípicos. Los conjuntos de datos reales suelen necesitar un margen blando, que introduce variables de holgura para observaciones dentro del margen o del lado incorrecto de la frontera.
El hiperparámetro C controla la penalización de estas violaciones:
- Un C mayor penaliza las violaciones con mayor fuerza y a menudo produce un margen más estrecho que sigue los ejemplos de entrenamiento más de cerca.
- Un C menor permite más violaciones a cambio de un margen más amplio y más regularizado.
El número de vectores de soporte es resultado de los datos y la solución; aumentar C no garantiza una cantidad específica de vectores de soporte.
El truco del kernel
Algunas clases no pueden separarse con un hiperplano recto en el espacio de características original. Un kernel evalúa un producto interno correspondiente a otro espacio de características. Esto permite que la SVM ajuste una frontera no lineal sin calcular explícitamente cada coordenada transformada.
Los kernels comunes incluyen:
- Lineal: eficiente para características dispersas de alta dimensión, como texto.
- Polinomial: modela interacciones hasta un grado elegido.
- Función de base radial (RBF): crea fronteras locales flexibles basadas en la distancia.
- Sigmoide: se asemeja a una activación neuronal pero es menos frecuente como opción predeterminada.
Para una SVM RBF, gamma controla cuán localmente cada ejemplo de entrenamiento influye en la frontera. Un gamma grande puede crear regiones muy detalladas y sobreajustar; un gamma pequeño produce una influencia más suave.
Clasificación multiclase
El objetivo clásico de la SVM es binario. Las bibliotecas lo amplían mediante estrategias como uno contra el resto, que entrena un clasificador por clase, o uno contra uno, que entrena clasificadores para pares de clases y combina sus decisiones. Las SVM multiclase no simplemente dibujan una línea menos que el número de clases.
Regresión de vectores de soporte y SVM de una clase
La regresión de vectores de soporte (SVR) ajusta una función mientras ignora errores dentro de un tubo de ancho epsilon y penaliza desviaciones mayores. Una SVM de una clase estima una frontera alrededor de los datos típicos y puede soportar la detección de novedades. Un punto inusual no es automáticamente fraude o falla; es inusual bajo la representación ajustada.
Requisitos prácticos
Las SVM dependen de distancias y productos internos, por lo que las características numéricas generalmente necesitan escalado. C, kernel, gamma y los pesos de clase deben seleccionarse mediante validación. Las estimaciones de probabilidad no son inherentes al margen y a menudo requieren calibración, lo que añade costo y debe evaluarse por separado.
El entrenamiento de SVM con kernel puede escalar entre tiempo cuadrático y cúbico en función del número de muestras, según los datos y la implementación. Las variantes lineales de SVM o los modelos lineales estocásticos son más adecuados para conjuntos de datos muy grandes. Para imágenes, audio o texto sin procesar, las representaciones aprendidas mediante deep learning pueden ser más efectivas, mientras que una SVM aún puede clasificar una incrustación fija.
Fortalezas y limitaciones de las SVM
Las SVM pueden funcionar bien con muchas características, ofrecen un objetivo regularizado claro y dependen principalmente de los vectores de soporte en el momento de la predicción. Las limitaciones incluyen sensibilidad al escalado y a los hiperparámetros, entrenamiento potencialmente costoso, menor interpretabilidad bajo kernels no lineales y la necesidad de calibración de probabilidades.
Márgenes, kernels y el objetivo de optimización
Una máquina de vectores de soporte busca un hiperplano separador con un margen amplio entre clases. Sólo los vectores de soporte que están en o dentro del margen determinan la frontera. Las SVM de margen blando introducen holgura para solapamientos y puntos mal etiquetados; el parámetro C intercambia un margen más amplio contra violaciones durante el entrenamiento. Las entradas suelen escalarse porque la distancia y los productos punto impulsan la solución. Los pesos de clase o el remuestreo ayudan cuando los costos de error y la prevalencia son desiguales, pero los umbrales y las probabilidades aún requieren validación independiente.
El truco del kernel evalúa la similitud como si las entradas se mapearan a un espacio de características de mayor dimensión. Los kernels lineales, polinomiales, de base radial y especializados codifican diferentes suposiciones. Para un kernel RBF, gamma controla cuán localmente cada punto influye en la frontera: un gamma alto puede crear regiones intrincadas y sobreajustar, mientras que un gamma bajo puede subajustar. Las matrices de kernel crecen cuadráticamente con el número de muestras, lo que hace que las SVM no lineales sean costosas en conjuntos de datos grandes. Los solucionadores lineales o los mapas de características aproximados suelen ser preferibles a gran escala.
Uso multiclase, calibración y límites operacionales
Las SVM binarias se extienden a multiclase mediante uno contra el resto, uno contra uno o formulaciones estructuradas. Los hiperparámetros deben ajustarse dentro de la validación cruzada, con divisiones agrupadas o temporales cuando sea necesario. Evalúe la precisión y exhaustividad específicas de cada clase, las distribuciones de márgenes, la calibración y el rendimiento bajo desplazamiento. Las puntuaciones de decisión crudas no son probabilidades; la escala de Platt o la calibración isotónica utilizan datos separados y pueden degradarse si la prevalencia cambia. Compare con regresión logística, árboles y métodos modernos basados en representaciones con un esfuerzo de preprocesamiento y ajuste equivalente.
El despliegue requiere el escalador exacto, el orden de las características, los parámetros del kernel, los vectores de soporte y el mapeo de clases. El costo de predicción de una SVM con kernel crece con los vectores de soporte, por lo que se debe medir la latencia y la memoria en lotes realistas. Las entradas muy alejadas del soporte de entrenamiento aún pueden recibir etiquetas confiables; añada verificaciones fuera de distribución o una política de abstención cuando corresponda. Inspeccione los errores en busca de proxies sensibles y artefactos del conjunto de datos. Las SVM siguen siendo fuertes para problemas de tamaño medio y alta dimensión, pero un margen geométrico máximo no es prueba de estructura causal o seguridad.
Ejemplo práctico: una SVM para el enrutamiento de documentos raros
Un equipo de operaciones legales clasifica presentaciones breves en categorías de enrutamiento usando características TF–IDF y una SVM lineal. Divide por asunto y tiempo para evitar que las plantillas se filtren, escala los pesos de clase según el costo de error revisado y ajusta C dentro de una validación anidada. El modelo lineal se compara con regresión logística y un transformer. La precisión, exhaustividad, calibración y carga de trabajo del revisor por clase son más importantes que la precisión global.
Las puntuaciones de decisión se calibran con datos separados, y los documentos de bajo margen o con lenguaje no admitido se envían a la captura manual. El artefacto de despliegue incluye tokenizador, vocabulario, ponderación, modelo, calibración y mapa de etiquetas. El monitoreo rastrea nuevos términos, la prevalencia de categorías, márgenes y rutas corregidas. Los documentos y los vectores de soporte están protegidos porque las características de texto pueden revelar información confidencial. Un kernel no lineal se rechaza cuando su pequeño aumento de calidad no puede justificar el costo de latencia, memoria e interpretabilidad.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes del ajuste. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Utilice un despliegue escalonado, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, y luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Las SVM solo realizan clasificación?
No. La regresión de vectores de soporte predice objetivos continuos, mientras que una SVM de una clase puede estimar una frontera de novedad. Cada variante tiene un objetivo diferente y un conjunto de hiperparámetros.
¿Cuándo es una SVM lineal una opción sólida?
Las SVM lineales suelen ser efectivas para características dispersas de alta dimensión, incluidas las representaciones tradicionales de texto, donde un kernel flexible añadiría costo sin un beneficio claro.
Referencias principales












