
Fundamentos de la IA
¿Qué es el aprendizaje en conjunto?

 Añade Unite.AI a tus fuentes preferidas en Google
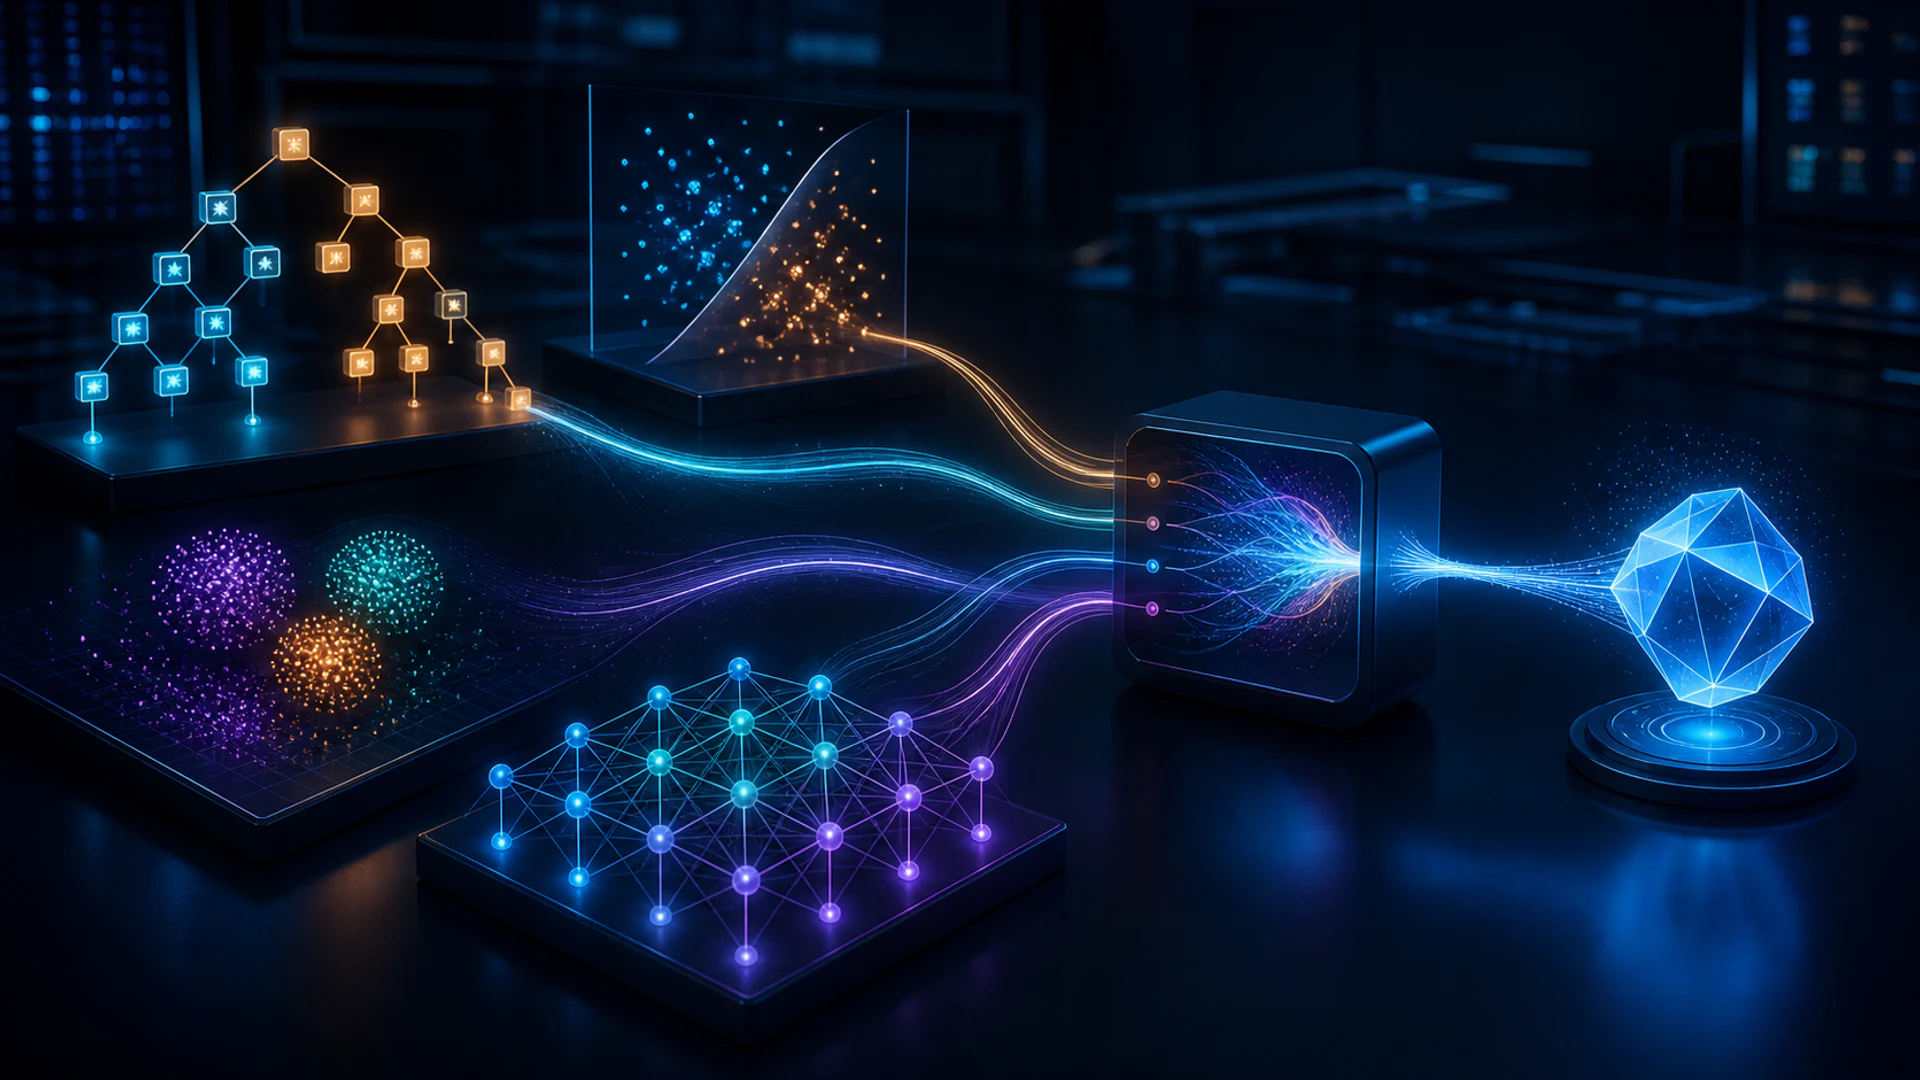
Ensemble learning combina predicciones de varios modelos. La idea central es que modelos con errores diferentes pueden producir un resultado más preciso o estable cuando sus salidas se promedian, se votan o se pasan a un meta‑aprendiz.
Añadir modelos no basta. Si cada miembro aprende el mismo atajo, sus errores estarán correlacionados y el conjunto puede simplemente volverse más confiado en el mismo error.
Conclusiones clave
- Los conjuntos funcionan mejor cuando los modelos miembros son útiles individualmente y cometen errores significativamente diferentes.
- Bagging entrena a los miembros en paralelo con datos remuestreados; boosting entrena a los aprendices secuencialmente para corregir errores.
- Stacking entrena un meta‑modelo con predicciones fuera de pliegue, no con predicciones dentro de la muestra.
- Los incrementos de precisión deben sopesarse frente a la latencia, calibración, interpretabilidad y costo de mantenimiento.
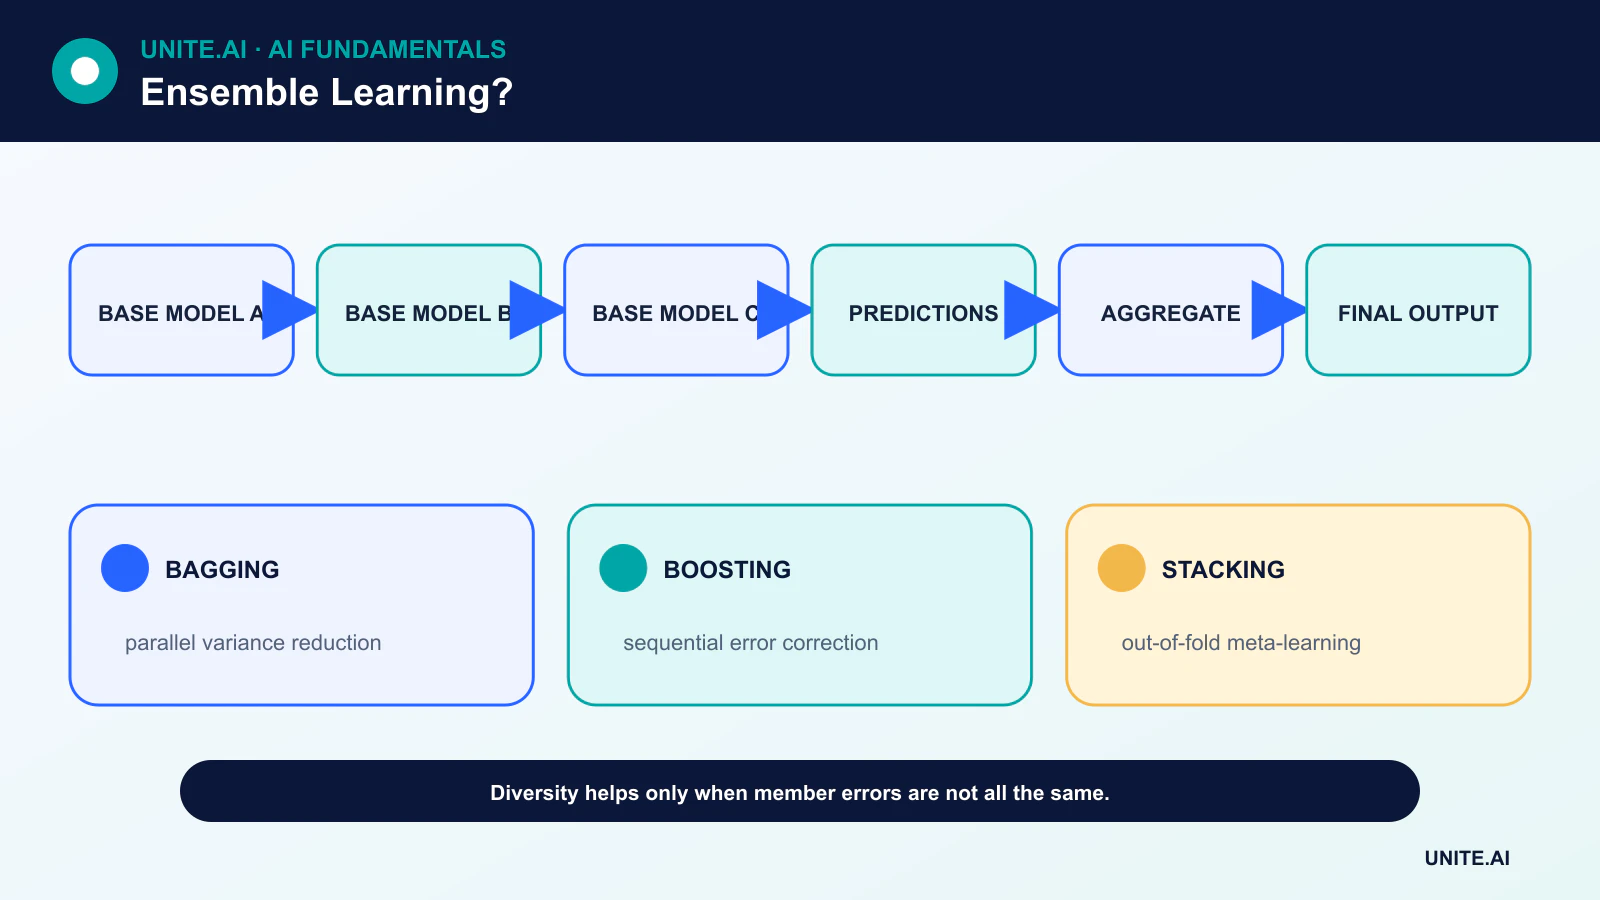
Votación y promediado
El voto duro selecciona la clase con más votos. El voto suave promedia las probabilidades de clase, generalmente después de la calibración. Los conjuntos de regresión suelen promediar predicciones numéricas. Las versiones ponderadas otorgan mayor influencia a los miembros más fuertes.
Un promedio puede reducir la varianza cuando los errores no están perfectamente correlacionados. No puede reparar un defecto de datos compartido, un error de etiqueta o un subgrupo ausente. La diversidad debe medirse mediante desacuerdo y superposición de errores, no asumirse por nombres diferentes de modelos.
Bagging y bosques aleatorios
El agregamiento por bootstrap entrena modelos en conjuntos de datos remuestreados y los promedia. Un árbol de decisión tiene alta varianza, lo que lo convierte en un candidato natural para bagging.
Los bosques aleatorios añaden selección aleatoria de características en las divisiones, reduciendo la correlación entre árboles. Los ejemplos fuera de bolsa pueden estimar el rendimiento, pero un conjunto de prueba final e intacto sigue siendo valioso para la selección de modelos y las afirmaciones de despliegue.
Boosting
Boosting construye un modelo aditivo en etapas. Los aprendices posteriores se centran en ejemplos o patrones residuales que el conjunto actual maneja pobremente. AdaBoost cambia los pesos de los ejemplos; gradient boosting ajusta los aprendices a los gradientes negativos de una pérdida elegida.
Los árboles potenciados pueden modelar relaciones tabulares complejas, pero los árboles profundos, rondas excesivas y fugas pueden aún sobreajustar. La tasa de aprendizaje, la profundidad del árbol, el submuestreo y la detención temprana son controles clave.
Stacking y blending
Stacking crea un modelo de segundo nivel que aprende a combinar predicciones base. Para evitar fugas, cada fila de entrenamiento del meta‑modelo debe provenir de un modelo base que no haya sido entrenado con esa fila. La validación cruzada genera estas predicciones fuera de pliegue.
Blending utiliza un conjunto de retención separado para el meta‑modelo, lo que es más simple pero reduce los datos disponibles para el entrenamiento. Ambos enfoques requieren el mismo preprocesamiento y control de versiones en la inferencia.
Compromisos operacionales
Un conjunto puede multiplicar la memoria, el cómputo y los modos de falla. Puede ser más difícil de explicar, calibrar y actualizar de forma consistente. La destilación puede comprimir un conjunto en un modelo más pequeño, pero el estudiante debe evaluarse de manera independiente.
Una selección práctica compara rendimiento, latencia de cola, calibración, uso de recursos y costo de error. A veces, un modelo bien regularizado resulta preferible a una pequeña ganancia de precisión obtenida de una pila frágil.
Por qué funcionan los conjuntos
El aprendizaje en conjunto combina varios modelos de modo que sus errores se cancelen parcialmente o sus fortalezas cubran distintas regiones. Bagging entrena modelos con datos remuestreados y promedia predicciones, reduciendo la varianza; los bosques aleatorios añaden selección aleatoria de características para decorrelacionar los árboles. Boosting entrena aprendices secuencialmente para enfocarse en el error residual, a menudo reduciendo el sesgo pero aumentando la sensibilidad al ruido y a la sintonía. Stacking entrena un meta‑modelo con predicciones de los modelos base. La diversidad debe ser útil: promediar modelos idénticos añade costo sin reducir mucho el error.
La correlación entre errores determina el beneficio. La diversidad puede provenir de muestras de datos, características, algoritmos, hiperparámetros, inicialización aleatoria o ventanas temporales. El voto duro descarta la confianza; el voto suave promedia probabilidades pero requiere una calibración compatible. La regresión puede promediar o usar agregación robusta. En stacking, las predicciones fuera de pliegue son esenciales: entrenar el meta‑modelo con predicciones base de los mismos datos ajustados genera fuga. Mantenga una línea base de promediado simple antes de adoptar un combinador complejo.
Evaluación, calibración e incertidumbre
Compare cada miembro y el conjunto en un conjunto retenido con el mismo preprocesamiento. Informe métricas de la tarea, calibración, errores por subgrupos, varianza entre pliegues o semillas, y costo de recursos. Un conjunto puede mejorar la calidad promedio mientras oculta un punto ciego compartido causado por datos o etiquetas comunes. Inspeccione el desacuerdo: puede identificar incertidumbre, pero modelos correlacionados y erróneos con confianza pueden coincidir. Calibre el conjunto final, no solo a los miembros, y valide los umbrales de abstención contra la capacidad de revisión y sus consecuencias.
Las estimaciones fuera de bolsa son útiles para modelos baggeados pero no sustituyen una prueba final representativa del despliegue. Para datos temporales, evite remuestrear que rompa el orden. Para usos relacionados con la seguridad, pruebe fallas de miembros, modelos obsoletos y entradas adversarias. Los conjuntos ponderados pueden sobreajustar los datos de validación cuando se prueban muchos candidatos. Registre la selección de candidatos y use validación anidada cuando la sintonía sea extensa.
Servicio y mantenimiento
Los conjuntos multiplican la memoria, latencia, energía y dependencias operativas. La destilación puede comprimir el comportamiento combinado en un solo modelo, con un nuevo requisito de validación. Versione a los miembros, el preprocesamiento, los pesos y el enrutamiento como un único artefacto; defina el comportamiento cuando un miembro agota el tiempo o produce un resultado inválido. Monitoree las predicciones de los miembros y el desacuerdo para que una falla silenciosa sea visible. Retire miembros redundantes y reentrene deliberadamente. Los conjuntos mejoran la predicción cuando la diversidad de errores es real, pero no convierten datos de entrenamiento sesgados o un objetivo inválido en evidencia fiable.
Ejemplo práctico: un conjunto para alertas de clima severo
Un equipo de pronóstico combina un conjunto de características de modelo físico, un árbol potenciado por gradiente, un modelo neuronal secuencial y una línea base estadística calibrada. Las predicciones fuera de pliegue entrenan un meta‑modelo sencillo, y la evaluación usa tormentas futuras totalmente excluidas del entrenamiento de los miembros. Las métricas incluyen recall de eventos, falsas alarmas, tiempo de anticipación, calibración, desempeño geográfico y fiabilidad bajo condiciones extremas raras. Se examina la correlación de errores entre miembros porque los datos de entrada compartidos pueden crear puntos ciegos comunes.
El servicio conserva cada predicción y el resultado combinado. Si un miembro no está disponible, el sistema utiliza una configuración degradada prevalidada en lugar de renormalizar silenciosamente. El desacuerdo genera una revisión adicional pero no se trata como incertidumbre en todos los casos. El monitoreo rastrea deriva de los miembros, latencia y resultados de tormentas, con pesos actualizados solo mediante validación controlada. Las advertencias públicas permanecen bajo procesos de decisión meteorológica autorizados; el conjunto mejora la evidencia pero no redefine autónomamente la política de alertas.
Pruebas de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de la sintonía. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, fallas de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿Un bosque aleatorio es un conjunto?
Sí. Combina muchos árboles de decisión aleatorizados, generalmente mediante votación o promediado.
¿Pueden modelos idénticos formar un conjunto útil?
Pueden si los datos de entrenamiento, la inicialización o el muestreo generan errores suficientemente diferentes, pero la mera duplicación no aporta beneficio.
Referencias principales












