
Fundamentos de la IA
¿Qué es la IA de borde y la computación de borde?

 Añade Unite.AI a tus fuentes preferidas en Google
Edge computing sitúa el procesamiento cerca de los dispositivos y procesos físicos que generan datos. Edge AI ejecuta inferencia de aprendizaje automático —y a veces entrenamiento o adaptación— en un sensor, teléfono, vehículo, pasarela o servidor local en lugar de enviar cada entrada a una nube distante.
La arquitectura suele ser un continuo más que una elección entre borde y nube. Las decisiones inmediatas pueden permanecer locales mientras la nube respalda la gestión de flotas, análisis agregados, entrenamiento de modelos y almacenamiento a largo plazo.
Conclusiones clave
- La IA de borde puede reducir la latencia, el uso de ancho de banda y la transferencia de datos sin procesar, pero no garantiza automáticamente la privacidad.
- Los límites de memoria, energía, temperatura y el soporte de aceleradores definen el modelo desplegable.
- La cuantización, la poda y la destilación intercambian el tamaño y la velocidad del modelo por precisión y robustez.
- Las actualizaciones seguras, la telemetría, la reversión y la diversidad de hardware son componentes esenciales del sistema.
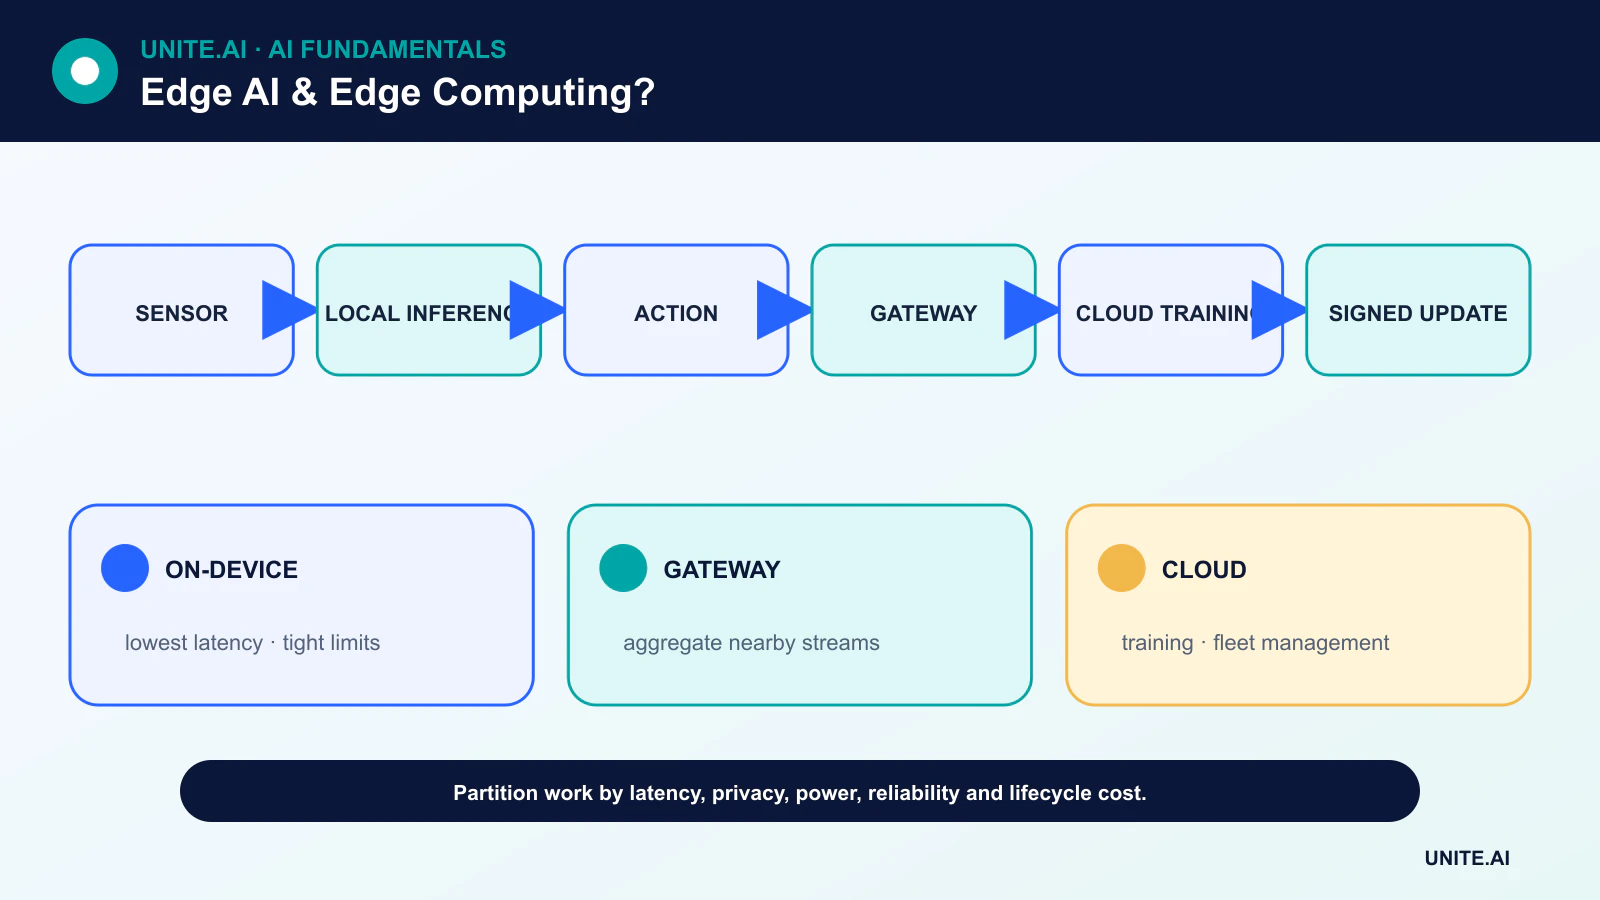
El continuo borde‑nube
Un sensor puede ejecutar un modelo de umbral diminuto, una pasarela cercana puede combinar varios flujos, y un servidor regional puede realizar inferencias más pesadas. La nube puede entrenar modelos y distribuir actualizaciones firmadas. La partición depende de la latencia, la conectividad, la energía, la sensibilidad de los datos y el mantenimiento.
Para el control industrial, los milisegundos y la operación sin conexión pueden justificar la inferencia local. Para una predicción empresarial de baja frecuencia, la computación centralizada puede ser más simple y observable.
Restricciones de hardware y modelo
Los dispositivos de borde van desde microcontroladores con kilobytes de memoria hasta teléfonos y servidores con NPUs o GPUs. El modelo debe ajustarse al almacenamiento y a la RAM, cumplir con los plazos en tiempo real, mantenerse dentro de los límites térmicos y usar operadores compatibles.
Las pruebas de referencia deben incluir el preprocesamiento, el movimiento de datos y el costo de activación, no solo el rendimiento del kernel. El tamaño de lote suele ser uno, y el rendimiento sostenido puede diferir de una ejecución breve en laboratorio.
Compresión y optimización
La cuantización representa pesos y activaciones con menor precisión. La poda elimina parámetros o estructuras. La destilación de conocimiento entrena a un estudiante más pequeño para imitar a un maestro más grande. La fusión de operadores y la planificación de memoria pueden reducir aún más la latencia.
La compresión puede alterar la precisión, la calibración y el rendimiento de subgrupos. Los equipos deben validar el artefacto convertido en el hardware objetivo en lugar de asumir que las métricas del modelo original de punto flotante siguen siendo válidas.
Privacidad, aprendizaje federado y seguridad
La inferencia local puede mantener audio sin procesar, imágenes o registros de sensores en el dispositivo, pero los metadatos, incrustaciones y la telemetría pueden seguir siendo sensibles. Aprendizaje federado puede coordinar el entrenamiento distribuido, con sus propios riesgos de privacidad y envenenamiento.
Las flotas de borde amplían la superficie de ataque. El arranque seguro, los modelos firmados, los servicios de mínimo privilegio, la comunicación cifrada y las actualizaciones oportunas forman parte del diseño de ciberseguridad. Se debe asumir el acceso físico y la existencia de dispositivos antiguos sin soporte.
Monitoreo y operaciones de flota
Un modelo local aún necesita observabilidad. Los dispositivos pueden reportar métricas agregadas respetuosas con la privacidad, versión, estado, latencia y tasas de rechazo. Muestrear entradas seleccionadas para revisión requiere consentimiento explícito y controles de retención.
Los despliegues deben usar grupos canario y reversión automática. El sistema debe manejar hardware incompatible, actualizaciones interrumpidas y deriva del modelo. Un dispositivo que no pueda recibir correcciones de seguridad puede necesitar ser retirado del servicio.
Arquitectura de borde y ubicación de cargas de trabajo
La computación de borde procesa los datos cerca de su origen —en un sensor, dispositivo, pasarela, vehículo, punto de venta o servidor local— en lugar de depender totalmente de una nube distante. La IA de borde coloca la inferencia de modelo o, a veces, el entrenamiento en ese entorno. La ubicación debe seguir la latencia, conectividad, ancho de banda, privacidad, resiliencia, energía y necesidades de gestión. Un diseño híbrido puede realizar detección inmediata localmente, enviar eventos seleccionados a un sistema regional y usar la nube para análisis de flota y entrenamiento de modelos.
El hardware varía desde microcontroladores y NPUs hasta GPUs y servidores resistentes. Los modelos se exportan, cuantizan, podan, destilan o compilan para los operadores y la memoria disponibles. El preprocesamiento y la entrada/salida del sensor pueden dominar la latencia, mientras que el calor o los límites de la batería restringen el rendimiento sostenido. Evalúe la línea completa en el dispositivo exacto bajo concurrencia, temperatura y modos de energía realistas. Una cifra TOPS destacada no revela retroceso de operadores, transferencias de memoria o la precisión desplegada.
Seguridad de flota, actualizaciones y observabilidad
Los dispositivos distribuidos amplían la superficie de ataque y pueden ser accesibles físicamente. Utilice arranque seguro, firmware y modelos firmados, identidad respaldada por hardware cuando sea posible, comunicación cifrada, mínimo privilegio, segmentación de red y secretos protegidos. Las actualizaciones requieren despliegues por etapas, verificaciones de compatibilidad, política anti-reversión cuando corresponda, recuperación de actualizaciones interrumpidas y una imagen conocida como buena. Inventarice versiones de dispositivos, sensores, firmware, tiempo de ejecución y modelos para que un incidente pueda ser delimitado rápidamente.
La conectividad es intermitente, por lo que se debe almacenar en búfer los datos con almacenamiento limitado, secuenciar eventos, hacer reintentos idempotentes y definir el comportamiento sin conexión. La observabilidad debe capturar estado, latencia, energía, resúmenes de entrada, predicciones, confianza y resultados confirmados sin transmitir datos sin procesar innecesarios. La deriva del reloj, fallas del sensor y el agotamiento del almacenamiento local pueden invalidar los resultados. Los comandos remotos y los canales de depuración requieren una autorización más fuerte porque pueden convertirse en rutas de control para toda la flota.
Despliegue responsable
El procesamiento local puede reducir la transferencia pero no protege automáticamente la privacidad; las entradas sin procesar, incrustaciones y registros pueden seguir permaneciendo en el dispositivo o sincronizarse después. Minimice la retención y divulgue la opción de recurrir a la nube. Pruebe la deriva del modelo en distintos sitios y condiciones ambientales, con un valor predeterminado seguro cuando la confianza o la salud del sensor se degrade. La IA de borde es valiosa cuando las limitaciones locales son reales, pero transfiere la responsabilidad del ciclo de vida, la seguridad y la calidad a una gran flota heterogénea que debe diseñarse y mantenerse como un solo sistema.
Ejemplo práctico: IA de borde para una cámara de seguridad remota
Un sitio remoto detecta si una puerta restringida está abierta mientras la maquinaria funciona. El dispositivo de borde procesa el video localmente para lograr baja latencia y solo transmite eventos y miniaturas permitidas. Los datos incluyen clima, iluminación nocturna, suciedad, vibración y escenas vacías. El modelo está cuantizado y evaluado de extremo a extremo en el dispositivo objetivo para detección, falsas alarmas, latencia, energía y comportamiento térmico sostenido.
El arranque seguro, las actualizaciones firmadas, la identidad del dispositivo y la segmentación de la red protegen la flota. Obstrucción de la cámara, agotamiento del almacenamiento, deriva del reloj, pérdida de red y tiempo de espera del modelo generan alarmas de estado y una regla de equipo seguro independiente de la IA. Las actualizaciones se despliegan a un pequeño grupo con reversión automática. El monitoreo recopila datos mínimos de salud y resultados, y el personal del sitio puede inspeccionar y anular. La inferencia local reduce la transferencia pero no elimina las obligaciones de privacidad, retención o seguridad física.
Evidencia de implementación y preparación operativa
Una decisión de producción requiere más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, responsable y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, reversión y retiro. Utilice un despliegue por etapas, conserve una opción segura de respaldo y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento sin conexión persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Es la IA de borde siempre más rápida que la IA en la nube?
No. La inferencia local evita el retraso de la red, pero puede ejecutarse en hardware más débil. La totalidad de la cadena y los requisitos de fiabilidad determinan la latencia.
¿Puede la IA de borde funcionar sin acceso a internet?
Sí, si el modelo, el preprocesamiento y la lógica de decisión son locales. Las actualizaciones, la sincronización o las funciones dependientes de la nube pueden no estar disponibles.
Referencias principales












