
Fundamentos de la IA
¿Qué es la regresión lineal?

 Añade Unite.AI a tus fuentes preferidas en Google
Regresión lineal modela un objetivo continuo como una combinación lineal de una o más características de entrada. Se usa para predicción, estimación y como una línea base transparente para comprender si un modelo más complejo aporta valor significativo.
Los términos variable independiente y variable dependiente describen roles en el modelo, no una causa y efecto probadas. Una regresión puede identificar una asociación mientras que confusión, sesgo de selección, causalidad inversa o error de medición explican la relación.
Conclusiones clave
- El objetivo y se modela a partir de las características de entrada X; la versión anterior del artículo invirtió estas etiquetas en una explicación de fórmula.
- Los mínimos cuadrados ordinarios minimizan la suma de los residuos al cuadrado.
- Los diagnósticos de residuos y los supuestos son importantes para la inferencia y la incertidumbre.
- La regularización ridge y lasso ayuda cuando los predictores son numerosos o están correlacionados.
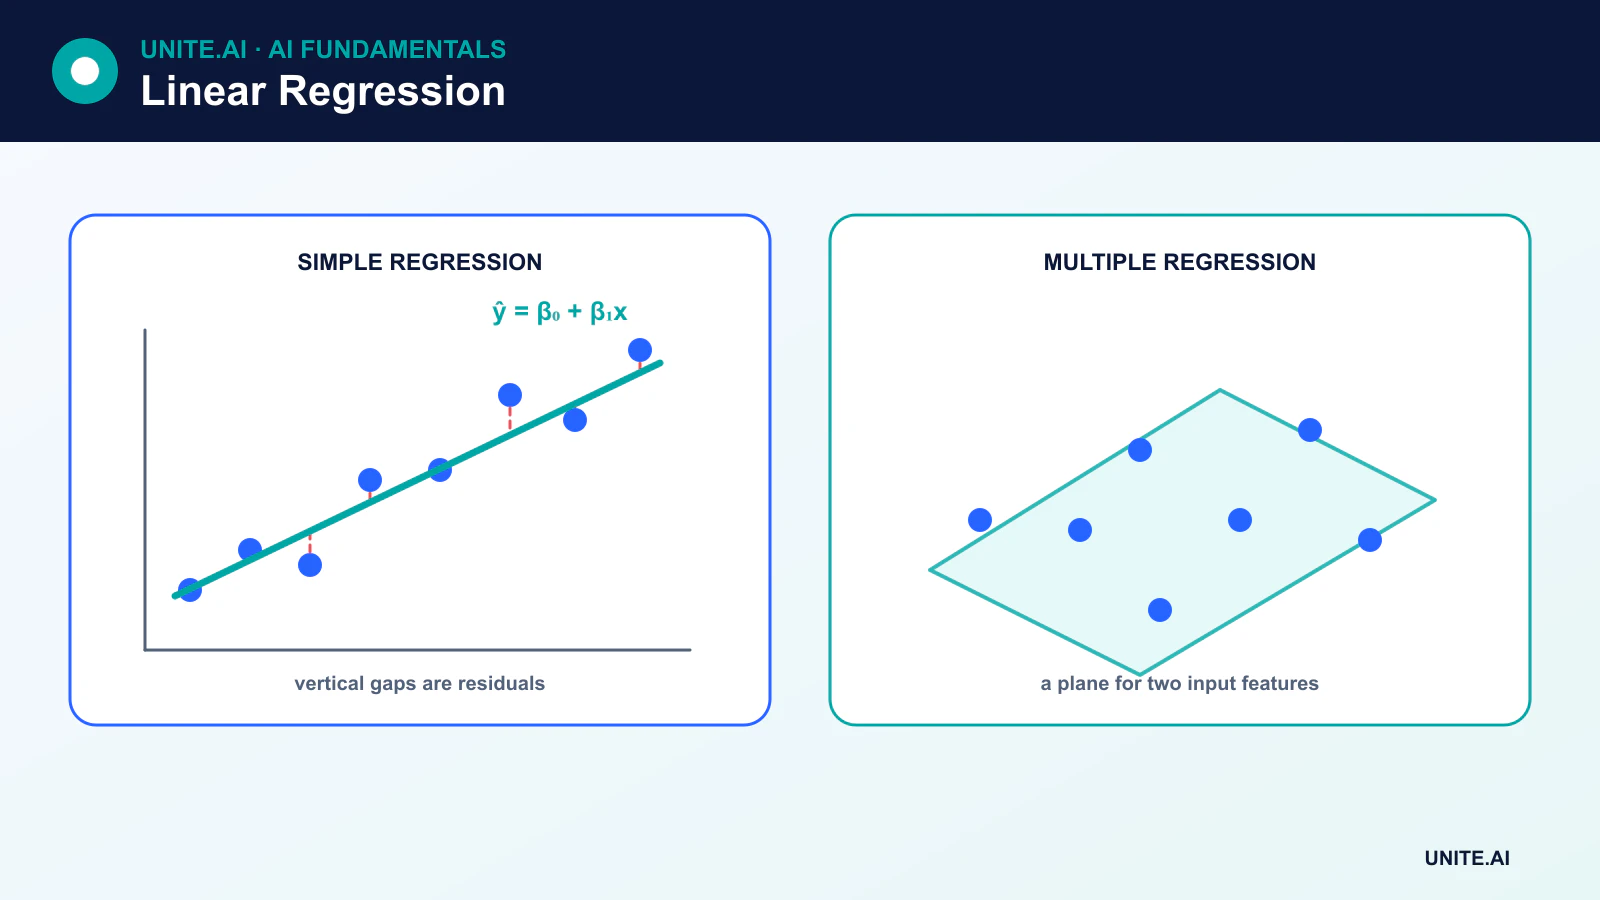
Regresión lineal simple
Con una característica, el modelo es:
ŷ = β₀ + β₁x
β₀ es la intersección y β₁ es la pendiente. El residuo para la observación i es yᵢ - ŷᵢ. Los mínimos cuadrados ordinarios (OLS) eligen los coeficientes que minimizan la suma de los residuos al cuadrado.
La pendiente estima el cambio esperado en el objetivo asociado a un cambio de una unidad en la característica bajo el modelo ajustado. No debe describirse como un efecto causal a menos que el diseño del estudio y los supuestos respalden la identificación causal.
Regresión lineal múltiple
Con p características:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Cada coeficiente se interpreta condicionando a las demás características incluidas. La regresión múltiple puede incorporar variables categóricas mediante codificación, términos polinomiales e interacciones. Sigue siendo “lineal” porque es lineal en los coeficientes, incluso si se incluyen características transformadas como x².
Supuestos y diagnósticos
Para la predicción, la pregunta central es qué tan bien generaliza el modelo. Para pruebas clásicas de coeficientes e intervalos, se vuelven importantes supuestos adicionales:
- Linealidad: la media condicional está representada por la forma lineal elegida.
- Errores independientes o modelados correctamente: observaciones repetidas, agrupadas, espaciales o de series temporales pueden requerir una estructura de error diferente.
- Varianza constante del error: la heterocedasticidad afecta los errores estándar y las estimaciones de incertidumbre.
- Multicolinealidad limitada: predictores fuertemente correlacionados hacen que los coeficientes individuales sean inestables.
- Distribución de residuos: la normalidad es relevante para algunas inferencias con muestras pequeñas, no es un requisito de que cada característica esté distribuida normalmente.
Los diagramas de residuos, las medidas de apalancamiento e influencia, y la revisión del dominio pueden identificar valores atípicos, no linealidad, variación cambiante u observaciones que dominan el ajuste.
Evaluación de predicciones
- Error absoluto medio (MAE) promedia el tamaño absoluto de los residuos.
- Error cuadrático medio (MSE) otorga mayor peso a los errores más grandes.
- Raíz del error cuadrático medio (RMSE) devuelve el error al cuadrado a las unidades del objetivo.
- R² compara la variación residual con una línea base constante en los datos evaluados.
R² no es una medida de exactitud, no establece causalidad y puede ser negativo en datos de prueba. La validación debe coincidir con el entorno real de predicción, incluyendo divisiones conscientes del tiempo o de grupos cuando sea necesario.
Ridge, lasso y elastic net
La regresión ridge añade una penalización L2 que reduce los coeficientes y estabiliza los predictores correlacionados. Lasso añade una penalización L1 y puede fijar coeficientes a cero. Elastic net combina ambas. Las características generalmente necesitan una escala compatible antes de comparar estas penalizaciones.
La regularización introduce sesgo a cambio de menor varianza y puede reducir el overfitting. La intensidad de la penalización se selecciona mediante validación, no con el conjunto de prueba final.
Cuando la regresión lineal es la herramienta incorrecta
Un modelo lineal puede fallar cuando las relaciones son fuertemente no lineales, los errores dependen de valores pasados, las distribuciones del objetivo requieren un modelado especializado, o unos pocos valores atípicos dominan la pérdida cuadrática. Los Decision trees, los modelos lineales generalizados, los modelos de series temporales, la regresión robusta o los métodos no lineales pueden ajustarse mejor.
Incluso cuando un modelo complejo resulta mejor, la regresión lineal sigue siendo una línea base valiosa. Si un sistema grande no puede superarlo de forma fiable, la complejidad añadida puede no estar justificada.
Supuestos del modelo, estimación y diagnósticos
Los modelos de regresión lineal modelan la media condicional de un resultado numérico como una intersección más predictores ponderados. Los mínimos cuadrados ordinarios eligen los coeficientes que minimizan los residuos al cuadrado. Los coeficientes describen el cambio esperado en el resultado por un cambio de una unidad en el predictor mientras se mantienen constantes las demás variables incluidas, bajo el modelo especificado. Esto es una asociación a menos que los supuestos de identificación causal y el diseño del estudio justifiquen lo contrario. Unidades, codificación, transformaciones, interacciones y categorías de referencia determinan la interpretación, por lo que los coeficientes sin un diccionario de datos son incompletos.
La inferencia clásica depende de supuestos sobre la forma funcional, errores independientes, varianza constante y distribución del error para pruebas e intervalos específicos. Los diagramas residuo versus ajustado revelan no linealidad o heterocedasticidad; los gráficos Q–Q evalúan el comportamiento de las colas; los diagnósticos de apalancamiento e influencia identifican observaciones que afectan fuertemente las estimaciones. Los predictores correlacionados inflan la incertidumbre y hacen inestables los coeficientes individuales incluso cuando las predicciones siguen siendo adecuadas. Pueden ser necesarios errores estándar robustos, transformaciones, splines, estructuras jerárquicas u otro modelo en lugar de eliminar puntos de datos inconvenientes.
Regularización, evaluación y uso responsable
Ridge regression reduce los coeficientes con una penalización L2, mientras que lasso puede fijar algunos a cero con una penalización L1; elastic net los combina. Estandarice los predictores cuando la escala de la penalización debe ser comparable y seleccione la intensidad usando validación o validación cruzada. Evalúe el error absoluto medio, la raíz del error cuadrático medio, la distribución de residuos, la calibración a través de rangos, y la incertidumbre, con divisiones temporales o de grupos que reflejen el uso. Compare con una línea base de media y alternativas no lineales, pero mantenga los modelos lineales cuando la transparencia y estabilidad sean valiosas.
La extrapolación más allá del rango observado de los predictores sigue la línea ajustada sin evidencia y puede ser peligrosa. Supervise los rangos de características, ausencias, residuos y errores de subgrupos en producción. Los intervalos de predicción describen la incertidumbre de resultados individuales y son más amplios que los intervalos de confianza de la media; ambos requieren supuestos. Evite controlar variables que introduzcan sesgo causal cuando el objetivo es estimar efectos. La regresión lineal es una herramienta precisa para una relación definida, no una garantía universal de que el mundo sea lineal o de que un coeficiente represente una intervención.
Ejemplo práctico: estimación del tiempo de entrega
Un equipo de logística modela la duración de la entrega a partir de distancia, nivel de servicio, región, día de la semana y clima conocido. Inspecciona patrones no lineales en los residuos y añade splines e interacciones justificadas en lugar de tratar una ecuación lineal como física literal. Los grupos de transportista y ruta definen los pliegues de validación. Se reportan error absoluto medio, error de cola, cobertura de intervalos y sesgo sistemático. Las entregas canceladas y los datos registrados después de la llegada se excluyen o se modelan explícitamente.
Los coeficientes se documentan con unidades y se verifican por inestabilidad bajo predictores correlacionados. El modelo rechaza la extrapolación más allá de los rangos validados de distancia y región. Los intervalos de predicción acompañan a las estimaciones, y la programación posterior utiliza su incertidumbre. El monitoreo rastrea rangos de características, residuos, cobertura de intervalos y sesgo tras cambios en la red. No se hace una afirmación causal sobre el transportista o el clima a partir de los coeficientes predictivos; se requerirían experimentos causales u identificación más fuerte para sustentar una intervención.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambio de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Use un despliegue por etapas, preserve una reserva segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos cambien. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿La regresión lineal requiere solo una variable de entrada?
No. La regresión simple tiene un predictor, mientras que la regresión lineal múltiple puede usar muchas características numéricas, categóricas codificadas, transformadas e interacciones.
¿Puede la regresión lineal demostrar causalidad?
No. La interpretación causal requiere un diseño de investigación defensible y supuestos sobre confusión, selección, medición e intervención. Un coeficiente predictivo por sí solo describe una asociación en el modelo ajustado.
Referencias principales












