
Fundamentos de la IA
¿Qué es KNN (K-Nearest Neighbors)?

 Añade Unite.AI a tus fuentes preferidas en Google
K-nearest neighbors (KNN) predice un resultado a partir de los ejemplos de entrenamiento etiquetados más cercanos a un punto de consulta. Para clasificación, los vecinos votan por la clase. Para regresión, sus valores objetivo se promedian o se combinan de otra manera.
KNN es un método basado en instancias, no generalizante: el ajuste consiste principalmente en almacenar los ejemplos de entrenamiento y un índice de búsqueda opcional. Eso no elimina la necesidad de dividir los datos en entrenamiento, validación y prueba. Evaluar con datos reservados es esencial para elegir k, la métrica de distancia, el procesamiento de características y la regla de votación.
Conclusiones clave
- KNN predice localmente; no divide el conjunto de datos en clústeres primero.
- El escalado de características es crítico porque la distancia define qué ejemplos cuentan como vecinos.
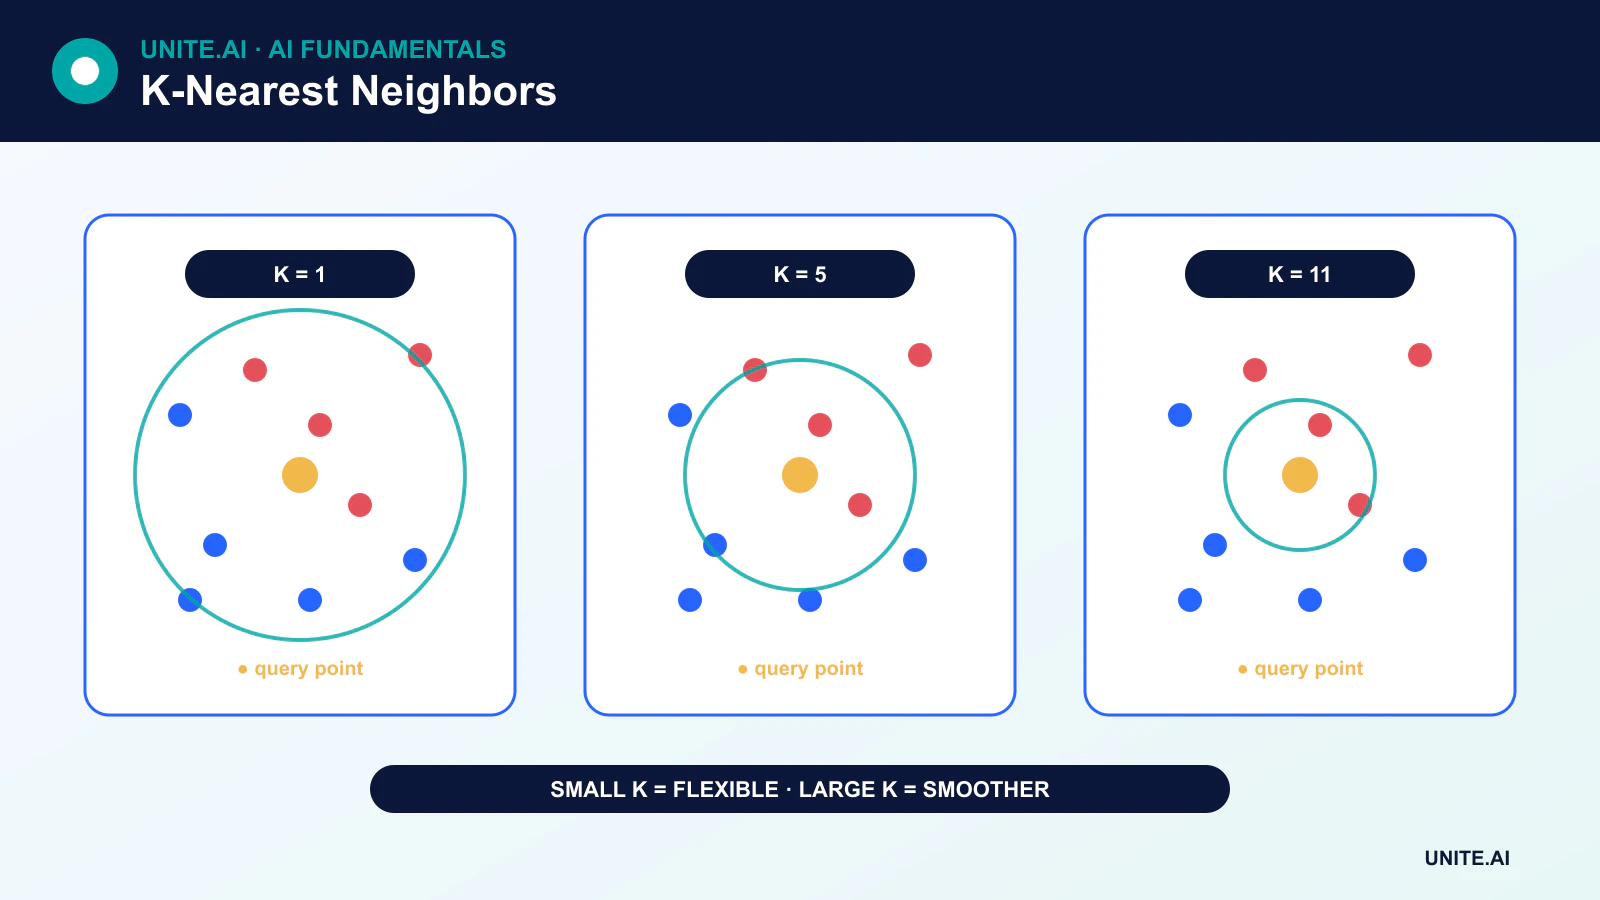
- Un k pequeño puede ser ruidoso, mientras que un k grande puede suavizar la estructura local.
- Altas dimensiones, características irrelevantes, desequilibrio de clases y búsqueda lenta pueden limitar el rendimiento.
Cómo funciona la clasificación KNN
- Representar la consulta y los ejemplos de entrenamiento en el mismo espacio de características.
- Calcular la distancia entre la consulta y los ejemplos de entrenamiento.
- Seleccionar los k ejemplos más cercanos.
- Predecir la clase mayoritaria o usar votación ponderada por distancia.
La votación ponderada otorga más influencia a los vecinos más cercanos. Los empates requieren una regla documentada, y los vecinos a la misma distancia con etiquetas diferentes pueden hacer que los resultados dependan del orden o de detalles de implementación.
Regresión KNN
Para regresión, la predicción suele ser la media de los objetivos vecinos. El ponderado por distancia puede reducir la influencia de observaciones más lejanas. La mediana o una agregación robusta pueden ser útiles cuando los objetivos locales contienen valores atípicos.
Métricas de distancia
La distancia euclidiana es común para características continuas, la distancia Manhattan suma diferencias absolutas y la distancia coseno se centra en la dirección más que en la magnitud. Otras métricas se aplican a datos binarios, categóricos, geográficos, de secuencias o de embeddings aprendidos.
Denominar a KNN como “no paramétrico” significa que no asume una forma funcional fija de dimensión finita para la frontera de decisión. Aún asume que la representación y la métrica seleccionadas hacen que los puntos cercanos sean relevantes entre sí.
Por qué el escalado es importante
Si una característica varía de 0 a 1 y otra de 0 a 100 000, la distancia euclidiana ordinaria será dominada por la segunda característica. La estandarización, normalización o transformaciones específicas del dominio deben ajustarse en la partición de entrenamiento y aplicarse a los datos de validación, prueba y producción.
Las características irrelevantes también distorsionan los vecindarios. La selección de características, la reducción de dimensionalidad o las representaciones aprendidas pueden ayudar, pero cada elección debe validarse sin fuga de datos.
Cómo elegir k
Con k = 1, el modelo puede seguir el ruido y los ejemplos mal etiquetados. A medida que k crece, las predicciones se vuelven más suaves y menos sensibles a un solo punto. Si k se vuelve demasiado grande, las clases o regiones distantes dominan y el modelo subajusta.
Elija k mediante validación cruzada en los datos de entrenamiento. Para clasificación binaria, un k impar reduce, pero no elimina, los empates. Los pesos de clase, particiones estratificadas, la elección del umbral y métricas apropiadas son importantes cuando las clases están desequilibradas.
La maldición de la dimensionalidad
En espacios de alta dimensión, las distancias pueden volverse menos informativas porque los ejemplos son escasos y las distancias más cercanas y más lejanas se vuelven relativamente similares. KNN puede requerir enormes cantidades de datos para mantener vecindarios locales significativos. Esto es la maldición de la dimensionalidad.
Reducción de dimensionalidad o embeddings específicos de la tarea pueden ayudar, pero la geometría del embedding debe validarse para la noción de similitud prevista.
Rendimiento de búsqueda
Una consulta de fuerza bruta compara el nuevo punto con cada ejemplo almacenado. Los árboles KD y los árboles de bolas aceleran algunas búsquedas exactas, aunque sus beneficios disminuyen en altas dimensiones. Los índices de vecinos aproximados intercambian una pequeña pérdida de recall por grandes ganancias de velocidad y memoria. Esta idea también sustenta la búsqueda de similitud vectorial.
Fortalezas y limitaciones
KNN es simple, admite fronteras de decisión irregulares y ofrece una explicación intuitiva basada en ejemplos. También puede requerir una memoria considerable, exponer ejemplos de entrenamiento sensibles, predecir lentamente y comportarse mal cuando la distancia no tiene sentido. Es una línea base útil, no un método que sea altamente preciso en la mayoría de los problemas por defecto.
Distancia, vecindarios y comportamiento de hiperparámetros
K-nearest neighbors almacena los ejemplos de entrenamiento y predice a partir de los k más cercanos bajo una distancia elegida. La clasificación usa una mayoría o voto ponderado por distancia; la regresión promedia los objetivos de los vecinos. El escalado es esencial porque una característica de gran rango puede dominar la distancia euclidiana. Los datos categóricos, dispersos, de secuencias o geográficos pueden requerir distancias Hamming, coseno, de edición, de gran círculo o aprendidas. La métrica es una suposición de modelado sobre la similitud y debe validarse contra el significado real de los casos cercanos.
Un k pequeño crea fronteras flexibles y de alta varianza y sensibilidad al ruido; un k grande suaviza las predicciones y puede borrar la estructura de minorías. Un k impar solo evita algunos empates binarios y no es una regla general. Elija k, distancia, ponderación, conjunto de características y preprocesamiento dentro de la validación cruzada. El desequilibrio de clases puede hacer que la votación mayoritaria local ignore resultados raros, por lo que se debe inspeccionar el recall por clase y la composición del vecindario. Las distancias en alta dimensión tienden a concentrarse, y las características irrelevantes degradan los vecindarios; la selección, reducción de dimensionalidad o embeddings aprendidos pueden ayudar.
Indexación, incertidumbre y operación en producción
La inferencia ingenua compara una consulta con cada punto de entrenamiento. Los árboles KD y los árboles de bolas ayudan en dimensiones bajas adecuadas; los índices de vecinos aproximados intercambian exactitud por velocidad y escala. Mida el recall de la búsqueda de vecinos por separado de la calidad predictiva. La memoria incluye características almacenadas, etiquetas y estructuras de índice. Las actualizaciones son conceptualmente simples pero pueden requerir reconstrucciones de índices, consistencia de versiones y propagación de eliminaciones. Proteja los ejemplos de entrenamiento sensibles porque devolver vecinos o distancias puede exponer registros.
KNN puede mostrar ejemplos que hacen la predicción comprensible, pero la proximidad no implica causalidad ni equidad. Proporcione la distancia, el margen de voto y una regla de abstención cuando los vecindarios sean escasos o conflictivos. Supervise la distancia de la consulta, las etiquetas de los vecinos, la deriva de características, la latencia y los resultados confirmados. Mantenga sincronizadas las versiones de preprocesamiento e índice, y pruebe los resultados exactos frente a los aproximados después de cambios. KNN es una línea base local eficaz y un método de recuperación cuando la distancia tiene sentido; tiene dificultades cuando la similitud no puede representarse con las características disponibles.
Ejemplo práctico: KNN para sustitución de productos
Un minorista representa los productos con atributos numéricos estandarizados, compatibilidad categórica y un embedding de texto aprendido, y luego define una distancia ponderada revisada por los encargados de mercancía. K y los pesos se seleccionan usando lanzamientos de productos posteriores, no filas de artículos aleatorios. La evaluación verifica el recall de sustitutos relevantes, recomendaciones incompatibles, distancia, cobertura de categorías y resultados para artículos raros. Una línea base de popularidad muestra si la similitud local aporta valor.
Un índice aproximado se compara con vecinos exactos para medir recall y latencia. Las consultas sin un artículo compatible cercano no devuelven sugerencia alguna en lugar de forzar un vecino. Las eliminaciones de productos y correcciones de atributos se propagan al índice mediante actualizaciones versionadas. La monitorización sigue las distribuciones de distancia, resultados vacíos, anulaciones y resultados comerciales sin confundir ventas con verdadera compatibilidad. Los términos sensibles de proveedores se excluyen de las explicaciones, y los ejemplos devueltos siguen siendo evidencia de similitud, no una afirmación de que los productos son equivalentes.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, responsable y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas mal formadas o ausentes, cambios de distribución, fallos de dependencias, uso indebido y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿KNN tiene una fase de entrenamiento?
Tiene poco ajuste de parámetros, pero aún cuenta con un proceso de desarrollo: el preprocesamiento se aprende a partir de los datos de entrenamiento, se puede construir un índice, y k, la métrica, los pesos y las características se seleccionan mediante validación.
¿KNN es lo mismo que K-means?
No. KNN es principalmente un método supervisado de predicción local. K-means es un algoritmo de agrupamiento no supervisado en el que K es el número de centros de clúster.
Referencias principales












