
Fundamentos de la IA
¿Qué es un árbol de decisión?

 Añade Unite.AI a tus fuentes preferidas en Google
Un árbol de decisión es un modelo de aprendizaje supervisado que realiza una predicción aplicando una secuencia de reglas si‑entonces. Cada nodo interno evalúa una característica, cada rama representa un resultado de esa prueba, y cada hoja produce una predicción de clase, una probabilidad o un valor numérico.
Los árboles de decisión se utilizan para clasificación y regresión. Su atractivo es práctico: pueden representar interacciones no lineales, requieren relativamente poco preprocesamiento y generan una ruta que una persona puede inspeccionar. Su debilidad es la inestabilidad: pequeños cambios en los datos de entrenamiento pueden crear un árbol diferente.
Conclusiones clave
- Un árbol particiona recursivamente el espacio de características; no tiene que aislar cada observación de entrenamiento.
- Las divisiones para clasificación suelen usar impureza de Gini o entropía, mientras que las divisiones para regresión reducen el error de predicción o la varianza.
- La profundidad, el tamaño mínimo de hoja y la poda controlan la complejidad y el sobreajuste.
- Los bosques aleatorios y los árboles de gradiente potenciado mejoran el poder predictivo combinando muchos árboles.
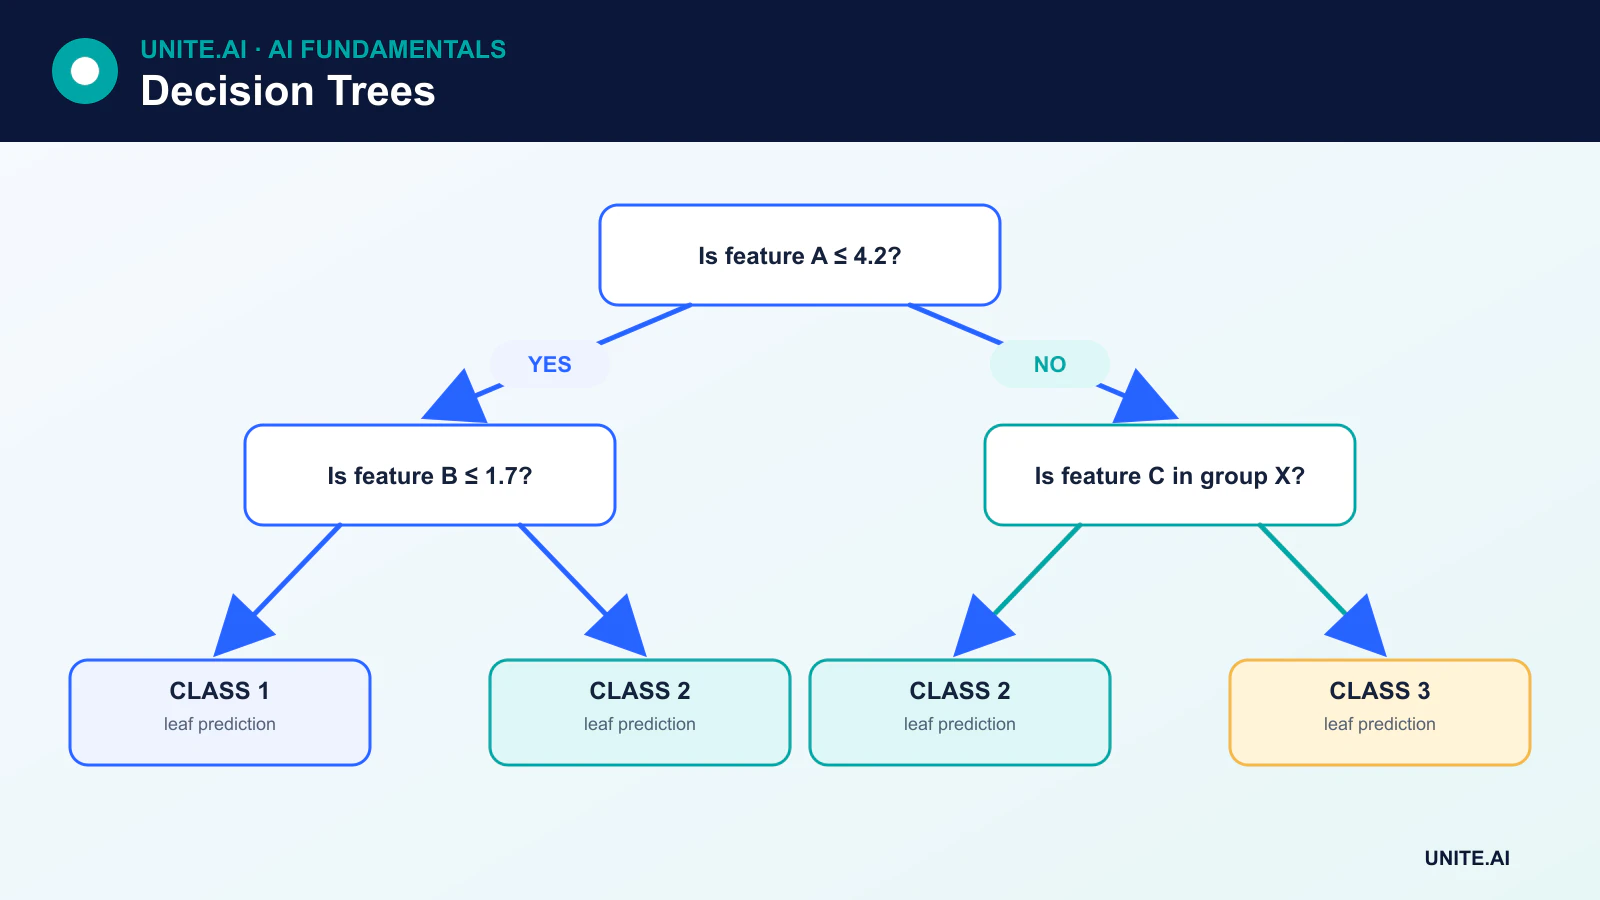
Cómo un árbol de decisión realiza una predicción
Supongamos que un modelo predice si una máquina es probable que falle. El nodo raíz podría preguntar si la vibración supera un umbral aprendido. Una rama podría entonces evaluar la temperatura de operación. La observación llega a una hoja que contiene la probabilidad estimada de falla entre los ejemplos de entrenamiento que siguieron la misma ruta.
Para regresión, la hoja puede devolver el valor medio del objetivo de las observaciones en esa región. Para clasificación, puede devolver la clase mayoritaria o una distribución de frecuencias de clases. Una hoja puede contener muchas observaciones; separar completamente los datos de entrenamiento suele ser indeseable porque puede producir un árbol sobreajustado.
Cómo un árbol elige una división
El entrenamiento considera características y umbrales candidatos, y luego selecciona la división que más mejora un objetivo definido. La mejora debe ponderarse por cuántas observaciones van a cada nodo hijo.
Impureza de Gini
Para clasificación, la impureza de Gini mide cuán mezcladas están las clases en un nodo:
Gini = 1 - Σ p(k)²
Un nodo que contiene solo una clase tiene impureza cero. Una división candidata es útil cuando la impureza ponderada de sus hijos es menor que la impureza del nodo padre.
Entropía y ganancia de información
La entropía es otra medida de la incertidumbre de clases:
Entropy = -Σ p(k) log₂ p(k)
La ganancia de información es la entropía del padre menos la entropía ponderada de los hijos. Gini y entropía a menudo producen árboles similares, aunque no siempre idénticos.
Pérdida de regresión
Los árboles de regresión suelen elegir divisiones que reducen el error cuadrático, el error absoluto u otro criterio de regresión. Cada hoja entonces predice un valor basado en los objetivos de entrenamiento dentro de esa región.
CART y otros algoritmos de árboles
CART, o Árboles de Clasificación y Regresión, usa divisiones binarias y subyace en implementaciones comunes como los árboles de decisión de scikit-learn. Otros algoritmos incluyen ID3, C4.5 y C5.0. Las implementaciones difieren en los tipos de división admitidos, el manejo de valores faltantes, la poda y los objetivos.
Las variables categóricas pueden requerir codificación, divisiones directas de subconjuntos o un manejo específico de la implementación. Los valores faltantes pueden imputarse o manejarse mediante direcciones predeterminadas aprendidas o divisiones sustitutas. Es importante comprender el comportamiento de la biblioteca específica en lugar de asumir que todas las implementaciones de árboles funcionan de la misma manera.
Control de la complejidad del árbol
Un árbol profundo puede memorizar ruido. Los controles comunes incluyen:
- Profundidad máxima: limita la longitud de una ruta de predicción.
- Mínimo de muestras por división o hoja: evita regiones diminutas.
- Disminución mínima de impureza: requiere que una división aporte suficiente beneficio.
- Número máximo de hojas: limita la complejidad total.
- Poda de coste-complejidad: elimina ramas cuya mejora no justifica la complejidad añadida.
La poda es un proceso de optimización estructurada, no una eliminación aleatoria. Los hiperparámetros deben elegirse con datos de validación o validación cruzada, mientras que el conjunto de prueba final permanece sin tocar.
Fortalezas y limitaciones
Los árboles de decisión pueden modelar interacciones y efectos de umbral sin escalar las características. Aceptan entradas numéricas y, según la implementación, categóricas. La predicción es rápida y un árbol pequeño es fácil de visualizar.
Sin embargo, un solo árbol puede tener alta varianza, crear cambios abruptos de predicción cerca de una división y favorecer características con muchos puntos de división posibles. Los árboles también extrapolan pobremente en regresión: fuera de las regiones observadas, una hoja sigue devolviendo un valor aprendido de sus muestras de entrenamiento. Un árbol grande puede no ser más comprensible que otro modelo complejo.
De un árbol a conjuntos
El aprendizaje en conjunto combina múltiples modelos. Un bosque aleatorio entrena muchos árboles sobre observaciones re‑muestreadas y subconjuntos de características, luego promedia sus predicciones. El gradient boosting construye árboles secuencialmente de modo que cada árbol nuevo aborda el error restante. Estos enfoques suelen superar a un solo árbol, pero sacrifican algo de interpretabilidad y añaden costo computacional.
La importancia de características de un árbol o conjunto debe interpretarse con cuidado. La importancia basada en impureza puede estar sesgada, y la importancia de una característica no prueba causalidad. La importancia por permutación, las herramientas de dependencia parcial y la revisión de dominio proporcionan contexto adicional.
Cómo un árbol aprende divisiones y predicciones
Un árbol de decisión particiona recursivamente el espacio de características. En cada nodo, un algoritmo de entrenamiento evalúa umbrales de características candidatos o particiones de categorías y selecciona la división que más reduce la impureza, como la impureza de Gini o la entropía para clasificación y el error cuadrático para regresión. Las hojas almacenan una distribución de clases o una predicción numérica basada en las observaciones de entrenamiento que las alcanzan. La división codiciosa es computacionalmente práctica pero no garantiza el árbol globalmente óptimo, y diferentes muestras o criterios de desempate pueden producir estructuras distintas.
Las características continuas, ordinales, categóricas y faltantes requieren un manejo explícito. La codificación one‑hot puede crear muchas divisiones candidatas; los métodos categóricos nativos pueden usar estadísticas ordenadas pero necesitan una implementación segura contra fugas. Los árboles no requieren escalado, aunque pueden favorecer variables de alta cardinalidad y aislar pequeños grupos. La profundidad, el tamaño mínimo de hoja, la disminución mínima de impureza y la poda de coste‑complejidad controlan la varianza. Selecciónelas con datos de validación y evalúe la calibración, porque una probabilidad de hoja basada en pocos casos puede ser extrema e inestable.
Interpretación, modos de falla y uso en producción
Una ruta desde la raíz hasta una hoja es una regla exacta para una predicción del modelo, pero no es automáticamente una explicación causal. Variables correlacionadas pueden sustituirse entre sí, pequeños cambios en los datos pueden alterar las divisiones superiores, y una ruta aparentemente simple puede depender de etiquetas sesgadas. La importancia global de características basada en impureza puede ser engañosa; la importancia por permutación, la dependencia parcial y las verificaciones contrafactuales añaden contexto pero también tienen supuestos. Informe la incertidumbre y pruebe si una regla supuesta se mantiene en datos independientes y subgrupos relevantes.
Los árboles individuales son útiles cuando la transparencia, baja latencia y una estructura no lineal moderada son importantes, pero los conjuntos suelen ofrecer un rendimiento predictivo más fuerte. Valide el comportamiento en los límites, categorías raras, valores faltantes y entradas fuera del rango de entrenamiento. Las reglas exportadas deben reproducir exactamente el preprocesamiento de entrenamiento y la comparación numérica. Monitoree la ocupación de hojas, la distribución de salida, el error y las categorías emergentes. Un árbol que dirige muchos casos nuevos a una región diminuta o previamente vacía debe activar una revisión incluso si la deriva agregada sigue siendo pequeña. Mantenga una alternativa para esquemas inválidos y documente cada decisión de poda o umbral.
Ejemplo práctico: un árbol de triaje de préstamos interpretable
Un prestamista utiliza un árbol solo para priorizar solicitudes incompletas para revisión manual, no para aprobar o negar crédito. El objetivo es un resultado de completitud documentado, y las características disponibles al ingreso excluyen decisiones posteriores. La validación temporal agrupada compara un árbol podado superficial con reglas y regresión logística. El tamaño mínimo de hoja evita reglas basadas en un puñado de solicitantes, mientras que la calibración y los errores específicos por clase se informan a través de canales y grupos protegidos relevantes.
Los revisores ven la ruta exacta y los valores de origen, pero pueden corregir datos erróneos y anular la asignación. La organización prueba proxies correlacionados y cambios contrafactuales, monitorea la ocupación de hojas y los valores faltantes, y trata el tráfico repentino a una hoja pequeña como un incidente de calidad de datos. Los cambios de política crean una nueva versión del modelo y validación, no una edición de división no documentada. Debido a que el uso afecta el acceso y la carga, los solicitantes reciben un canal humano y el árbol nunca se presenta como una explicación causal de la solvencia crediticia.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o faltantes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, conserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento fuera de línea persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Referencias principales












