
Fundamentos de la IA
¿Qué es una matriz de confusión?

 Añade Unite.AI a tus fuentes preferidas en Google
Una matriz de confusión es una tabla que cuenta cuántas veces las predicciones de un clasificador coinciden o difieren de las etiquetas conocidas. Revela qué clases se confunden y proporciona los recuentos utilizados para calcular métricas como precisión, exhaustividad, especificidad y F1. Es una de las herramientas diagnósticas fundamentales para los problemas de clasificación de aprendizaje supervisado.
La propia matriz no es una única puntuación de rendimiento. Es una vista estructurada de los resultados en un umbral de decisión, conjunto de datos y definición de clases específicos.
Conclusiones clave
- Para la clasificación binaria, los cuatro resultados son verdadero positivo, falso positivo, falso negativo y verdadero negativo.
- Siempre etiquete los ejes: las bibliotecas y publicaciones no siempre colocan las clases reales y predichas en la misma orientación.
- La exactitud puede ocultar errores graves cuando las clases están desbalanceadas.
- Cambiar el umbral de clasificación modifica la matriz de confusión y el compromiso entre precisión y exhaustividad.
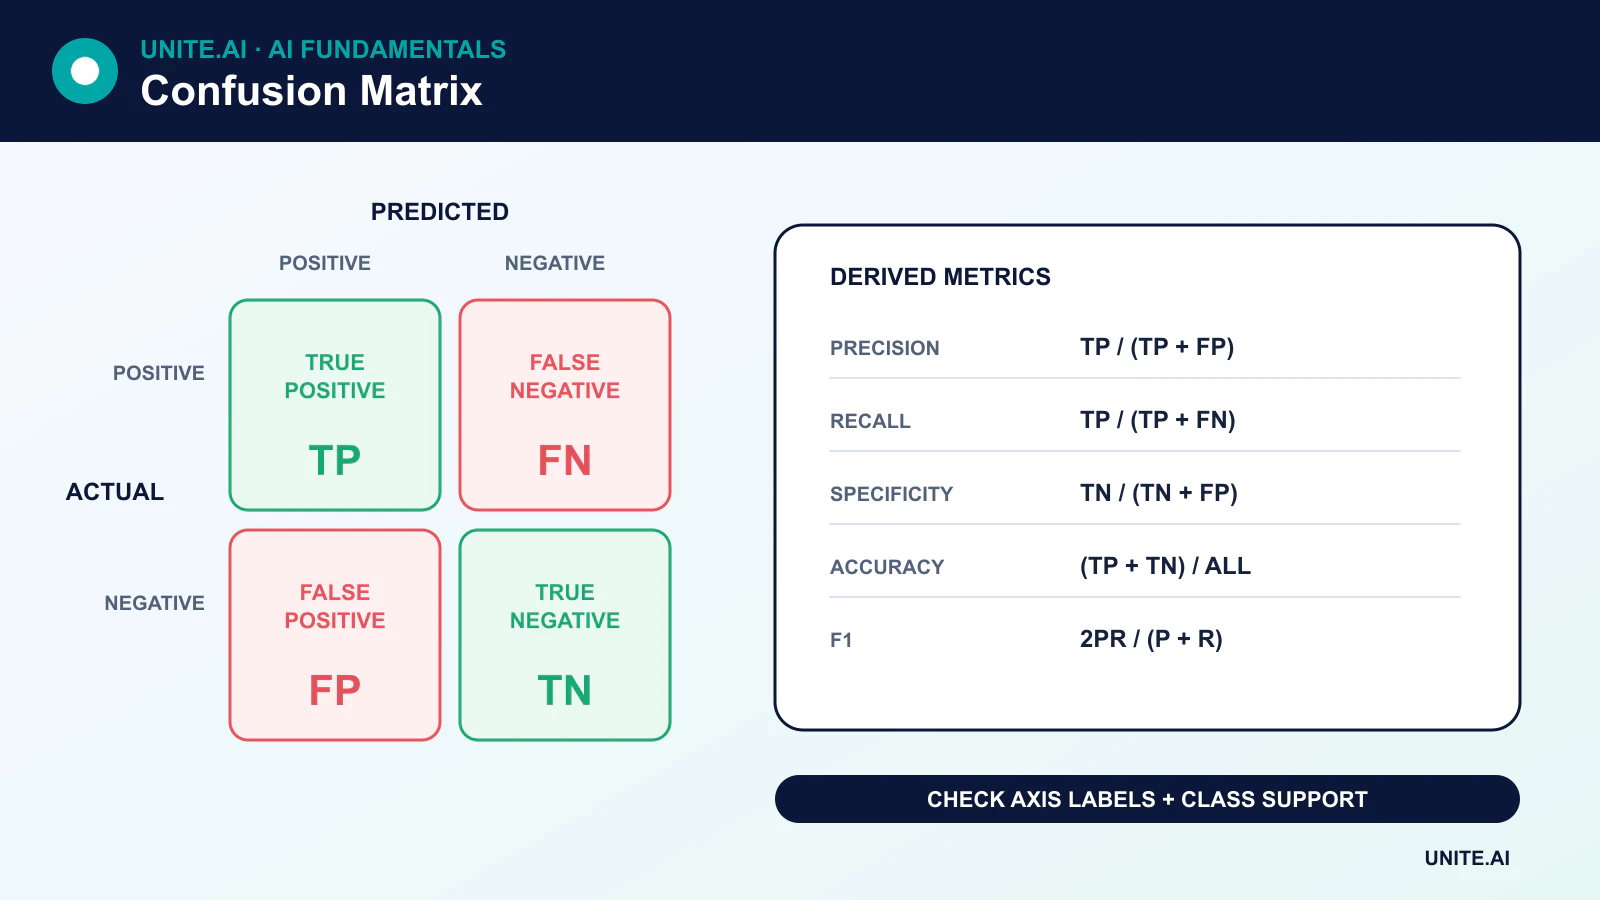
Los cuatro resultados de la clasificación binaria
- Verdadero positivo (TP): el ejemplo es positivo y el modelo predice positivo.
- Falso positivo (FP): el ejemplo es negativo pero el modelo predice positivo.
- Falso negativo (FN): el ejemplo es positivo pero el modelo predice negativo.
- Verdadero negativo (TN): el ejemplo es negativo y el modelo predice negativo.
Según la convención de scikit-learn, las filas representan las clases reales y las columnas las clases predichas. Otras visualizaciones pueden transponer esta disposición, por lo que las etiquetas —no las posiciones de las esquinas— deben guiar la interpretación.
Métricas derivadas de una matriz de confusión
Precisión
Precision = TP / (TP + FP)
La precisión responde: entre los ejemplos predichos como positivos, ¿qué proporción era realmente positiva?
Exhaustividad o sensibilidad
Recall = TP / (TP + FN)
La exhaustividad responde: entre todos los ejemplos realmente positivos, ¿qué proporción identificó el modelo? En la clasificación binaria, la exhaustividad de la clase positiva también se llama sensibilidad o tasa de verdaderos positivos.
Especificidad
Specificity = TN / (TN + FP)
La especificidad es la exhaustividad para la clase negativa: entre los negativos reales, ¿qué proporción rechazó correctamente el modelo?
Exactitud
Accuracy = (TP + TN) / (TP + TN + FP + FN)
La exactitud es útil cuando las clases y los costos de error están razonablemente equilibrados. Puede ser engañosa cuando una clase domina.
Puntuación F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
La puntuación F1 resume la precisión y la exhaustividad mediante una media armónica. Ignora los verdaderos negativos, por lo que no es el resumen adecuado para todas las tareas.
Ejemplo práctico
Supongamos que un conjunto de prueba contiene 1.000 transacciones. Cincuenta son fraudulentas. Un modelo detecta 40 de esas fraudes pero marca 30 transacciones legítimas:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
El modelo tiene un 96 % de exactitud, pero su precisión es de aproximadamente el 57 % y su exhaustividad del 80 %. La alta exactitud se debe en gran medida a la gran cantidad de transacciones legítimas. Si este modelo es aceptable depende del costo del fraude no detectado, la capacidad de investigación y de cuán calibrados estén sus puntajes de riesgo.
Los umbrales cambian la matriz
Muchos clasificadores generan una puntuación en lugar de una respuesta definitiva de sí/no. Reducir el umbral positivo generalmente incrementa la exhaustividad y los falsos positivos; aumentarlo generalmente incrementa la precisión o la especificidad mientras se pierden más positivos. El umbral debe elegirse usando datos de validación y costos reales de error, no fijarse automáticamente en 0,5.
Las curvas de precisión‑exhaustividad y ROC resumen el rendimiento a través de los umbrales. Las curvas de precisión‑exhaustividad suelen ser más informativas cuando la clase positiva es rara.
Matrices de confusión multiclase
Para K clases, la matriz es K × K. Las predicciones correctas se sitúan en la diagonal; las celdas fuera de la diagonal muestran qué pares de clases se confunden. Las métricas por clase pueden promediarse de diferentes maneras:
- Promedio macro: otorga a cada clase el mismo peso.
- Promedio ponderado: pondera cada clase según su número de ejemplos.
- Promedio micro: agrega los recuentos de resultados antes de calcular la métrica.
Informar solo un promedio puede ocultar un rendimiento deficiente en clases más pequeñas. Incluya los recuentos de soporte y los resultados por clase donde las diferencias sean relevantes.
Errores comunes
- Leer una matriz transpuesta sin verificar las etiquetas de los ejes.
- Calcular métricas a partir de datos de entrenamiento en lugar de un conjunto de validación adecuado.
- Ignorar la prevalencia de clases, la estrategia de muestreo o entidades duplicadas entre particiones.
- Comparar matrices generadas con diferentes umbrales sin señalar el cambio.
- Tratar todos los falsos positivos y falsos negativos como igualmente costosos.
Por lo tanto, una matriz de confusión es una herramienta diagnóstica, no una evaluación completa. La calibración, el análisis de subgrupos, la robustez y las consecuencias posteriores también forman parte de una revisión de clasificación.
Leer cada celda y derivar métricas útiles
Para la clasificación binaria, la matriz de confusión cuenta verdaderos positivos, falsos positivos, falsos negativos y verdaderos negativos para una clase positiva y umbral elegidos. La exactitud divide las predicciones correctas entre todos los casos; la precisión pregunta qué fracción de los positivos predichos fueron correctos; la exhaustividad pregunta qué fracción de los positivos reales se encontró; la especificidad mide los negativos reales rechazados correctamente. La F1 es la media armónica de precisión y exhaustividad. Ninguna es intrínsecamente la mejor: la detección de fraude, la triaje médica y el filtrado de spam asignan diferentes consecuencias a las mismas celdas.
En los problemas multiclase, las filas suelen representar las clases reales y las columnas las clases predichas, aunque las convenciones varían, por lo que las etiquetas deben ser explícitas. Los recuentos uno‑contra‑todos generan precisión y exhaustividad por clase. El promedio macro pondera a las clases por igual; el promedio micro agrega decisiones y favorece a las clases comunes; el promedio ponderado sigue el soporte de la clase. Las tareas multietiqueta permiten varias etiquetas por elemento y requieren definiciones por etiqueta o por muestra. Normalizar por fila para inspeccionar patrones de exhaustividad o por columna para inspeccionar la composición de predicciones, pero conservar los recuentos sin procesar para que los grupos raros no se exageren visualmente.
Umbrales, incertidumbre y decisiones operativas
Una matriz de confusión resume decisiones definitivas en un umbral. Utilice curvas de precisión‑exhaustividad o ROC para comparar umbrales, y luego seleccione un punto operativo según la capacidad, la prevalencia y el costo de error. La calibración pregunta si las probabilidades predichas coinciden con la frecuencia observada y es independiente del ranking. Cuando la prevalencia cambia, la precisión puede variar aun si la sensibilidad y la especificidad permanecen estables. Informe intervalos de confianza o variaciones por bootstrap, y evite extraer conclusiones de unos pocos errores en un subgrupo pequeño.
Audite las matrices por tiempo, ubicación, dispositivo, idioma y grupos afectados relevantes para encontrar errores concentrados. Compare el modelo con el proceso de decisión existente, incluida la revisión humana. Para cascadas, registre los errores en cada etapa: recuperación, clasificación, umbral y acción. Monitoree las etiquetas de resultados en vivo con su retraso y proceso de corrección. Un F1 aparentemente mejorado aún puede incrementar falsos negativos dañinos o superar la capacidad de revisión. La matriz de confusión es un libro de decisiones; conecte cada celda con quién experimenta el error y qué respuesta sigue.
Ejemplo práctico: selección de un umbral de cribado médico
Un modelo de cribado de aprendizaje automático genera una puntuación de riesgo para una condición de baja prevalencia. El equipo crea matrices de confusión a través de diferentes umbrales e informa sensibilidad, especificidad, precisión, derivaciones falsas y casos perdidos con intervalos de confianza. Dado que el valor predictivo positivo depende de la prevalencia, modela la población objetivo en lugar de citar la precisión de un solo conjunto de datos. Los resultados se segmentan por dispositivo, sitio, edad, sexo y otros grupos clínicamente justificados.
Los clínicos eligen un punto operativo que mantenga la sensibilidad requerida sin saturar las pruebas confirmatorias. La matriz se traduce a recuentos esperados por cada 10.000 personas cribadas para que las consecuencias sean comprensibles. Las puntuaciones fuera de condiciones validadas no generan una conclusión automatizada. El monitoreo compara predicciones con diagnósticos confirmados con retraso, rastrea la capacidad y la calibración, y desencadena una revisión cuando la prevalencia o la adquisición cambian. La matriz de confusión sigue vinculada al modelo exacto, al umbral y a la población.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, responsable y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, conserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Qué es una matriz de confusión normalizada?
La normalización divide los recuentos por el total de la clase real, el total de la clase predicha o todas las observaciones. Facilita la comparación de tasas entre clases, pero el informe también debe conservar los recuentos de soporte sin procesar para que los grupos pequeños no se confundan con otros de tamaño similar.
¿Puede una matriz de confusión evaluar regresión?
No directamente. Una matriz de confusión requiere clases discretas. Agrupar un objetivo continuo descarta información; la regresión normalmente debe usar análisis de residuos y métricas diseñadas para valores continuos, como MAE o RMSE.
Referencias principales












