
Fundamentos de la IA
¿Qué es el sobreajuste?

 Añade Unite.AI a tus fuentes preferidas en Google
sobreajuste ocurre cuando un modelo captura patrones o ruido que funcionan excepcionalmente bien en sus datos de entrenamiento pero no logran generalizar a nuevos ejemplos. Un modelo sobreajustado puede presentar un error de entrenamiento muy bajo mientras que el rendimiento en validación o en el mundo real es sustancialmente peor.
El problema opuesto es el subajuste: el modelo o proceso de entrenamiento no puede capturar suficiente señal incluso en el conjunto de entrenamiento. Un buen modelado equilibra el ajuste con la generalización en lugar de buscar un rendimiento de entrenamiento perfecto.
Conclusiones clave
- El rendimiento de entrenamiento por sí solo no puede diagnosticar la generalización.
- La detención temprana debe basarse en el comportamiento de validación, nunca en decisiones repetidas sobre el conjunto de prueba final.
- Más datos pueden ayudar, pero más características o mayor capacidad también pueden empeorar el sobreajuste.
- La regularización, el aumento de datos, la validación cruzada, la prevención de fugas y una evaluación adecuada abordan diferentes causas.
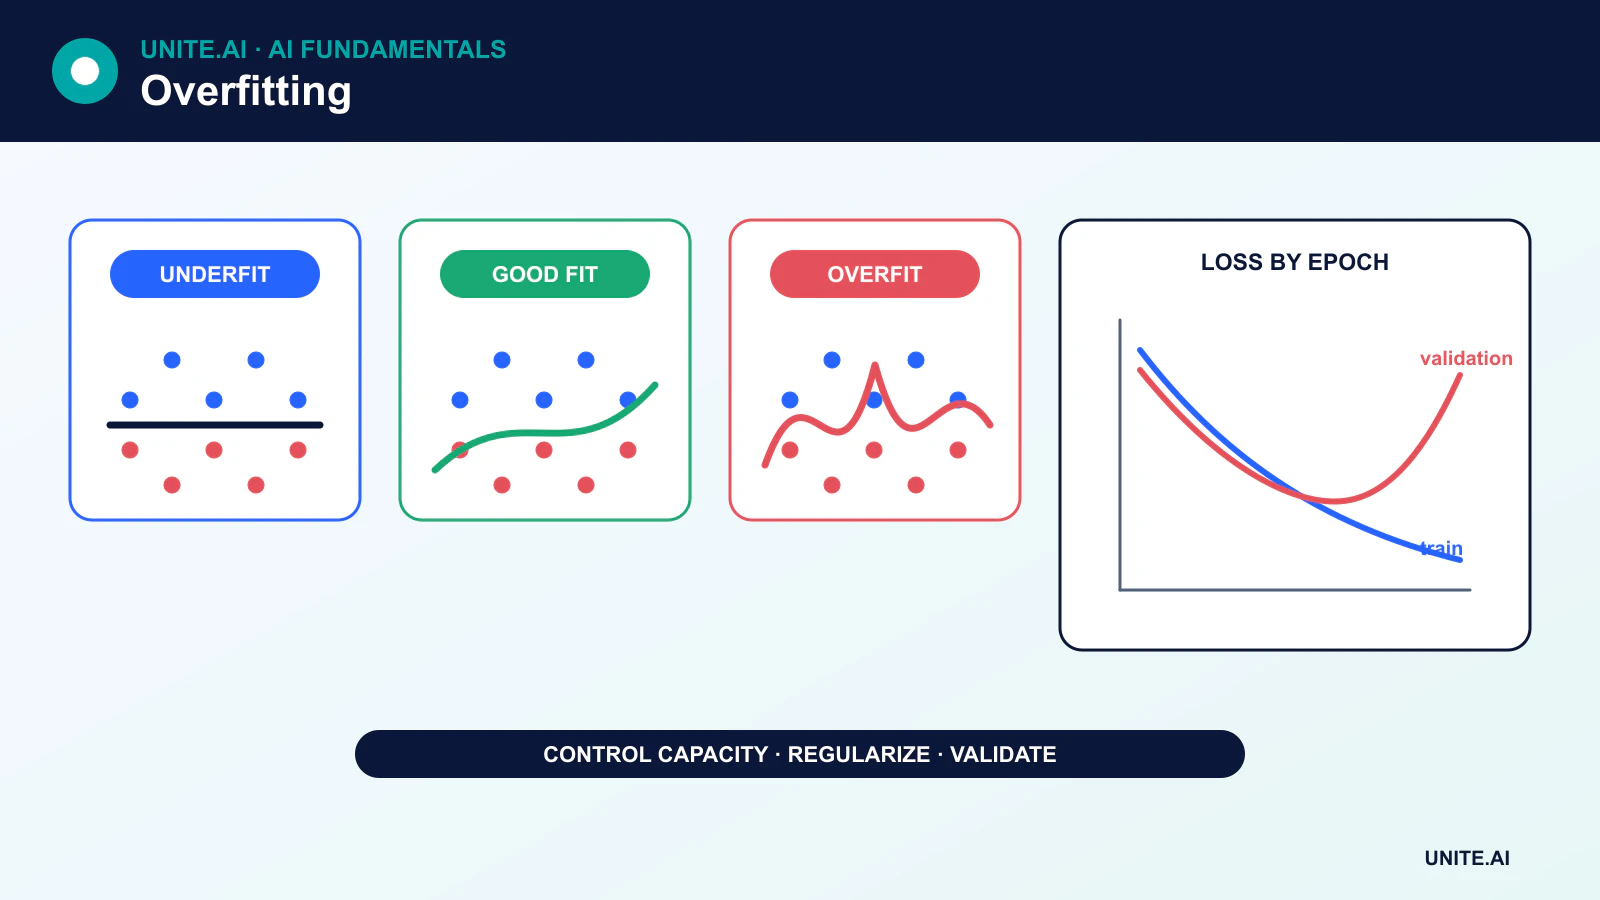
Ajuste, subajuste y sobreajuste
Un modelo subajusta cuando sus supuestos son demasiado restrictivos, sus características omiten señales importantes, la optimización es insuficiente o el entrenamiento es inadecuado. Añadir características relevantes o mayor capacidad puede ayudar, pero simplemente añadir características arbitrarias puede incrementar el ruido y el sobreajuste.
Un modelo sobreajusta cuando su capacidad efectiva es demasiado alta en relación con la información presente en los datos de entrenamiento. Ejemplos incluyen un árbol de decisión profundo que crea hojas diminutas, un polinomio que sigue fluctuaciones aleatorias o una red neuronal que memoriza los ejemplos.
El papel de los datos de entrenamiento, validación y prueba
- Datos de entrenamiento ajustan los parámetros del modelo.
- Datos de validación seleccionan la arquitectura, hiperparámetros, umbrales y el momento de detención.
- Datos de prueba proporcionan una estimación final después de que esas decisiones se completan.
Si el conjunto de prueba guía repetidamente las decisiones, pasa a formar parte del proceso de desarrollo y ya no brinda una estimación final imparcial. La validación cruzada puede hacer un uso más eficiente de datos limitados, pero todo el preprocesamiento y la selección de características deben realizarse dentro de cada pliegue de entrenamiento.
Detención temprana
Durante el entrenamiento, la pérdida de entrenamiento suele seguir disminuyendo. La pérdida de validación puede disminuir al principio y luego aumentar a medida que el modelo se especializa en el ruido del entrenamiento. La detención temprana guarda el punto de control con el mejor objetivo de validación o se detiene después de que la validación no mejore durante un período de paciencia definido.
El punto de control correcto no es el que tiene la pérdida de entrenamiento más baja. Un conjunto de prueba final separado se evalúa después de que la detención temprana y las decisiones de ajuste hayan finalizado.
Métodos de regularización
Penalizaciones de peso
La regularización L2 o decaimiento de peso desalienta valores de parámetros grandes. La regularización L1 puede fomentar coeficientes escasos. Sus efectos dependen del modelo y del optimizador; AdamW, por ejemplo, desacopla el decaimiento de peso de la actualización adaptativa.
Dropout y regularización estocástica
Dropout enmascara aleatoriamente activaciones durante el entrenamiento. Otros métodos eliminan rutas, perturban características o suavizan etiquetas. Estas técnicas modifican el objetivo de entrenamiento y deben desactivarse o gestionarse adecuadamente durante la inferencia.
Aumento de datos
El aumento de datos crea variaciones realistas —como recortes, rotaciones, ruido o paráfrasis— que deben preservar el objetivo. Transformaciones inválidas pueden cambiar la etiqueta y perjudicar el modelo. Para visión, herramientas como Albumentations ayudan a implementar canalizaciones controladas.
Control de capacidad
Árboles más superficiales, menos parámetros, selección de características, poda y clases de hipótesis más simples pueden reducir la varianza. La poda de árboles se basa en criterios, no en la eliminación aleatoria de detalle aprendido.
La fuga de datos puede parecer un rendimiento excepcional
La fuga de datos ocurre cuando información no disponible en el momento de la predicción ingresa al entrenamiento o a la evaluación. Ejemplos comunes incluyen ajustar la normalización en todo el conjunto de datos, dividir registros repetidos entre pliegues, usar datos futuros para predecir el pasado o incluir una característica derivada del objetivo.
La fuga no es un sobreajuste ordinario, pero crea la misma brecha engañosa entre los resultados offline y la implementación. La estrategia de división debe respetar el tiempo, la identidad, la ubicación y los procesos de generación de datos.
El desplazamiento de distribución es un problema separado
Un modelo puede generalizar a su distribución de prueba y aun así fallar cuando los datos de producción cambian. Nuevos dispositivos, políticas, poblaciones, estaciones o comportamientos adversarios pueden desplazar la relación entre entrada y objetivo. El monitoreo y la reevaluación periódica son necesarios incluso cuando el modelo original no estaba sobreajustado.
Diagnóstico del sobreajuste
Utilice curvas de aprendizaje, varianza de validación cruzada, métricas de subgrupos, calibración e inspección de errores. Si tanto el rendimiento de entrenamiento como el de validación son deficientes, concéntrese en el subajuste, las características, las etiquetas o la optimización. Si el entrenamiento es sólido y la validación es débil, investigue la capacidad, la fuga, la regularización y la representatividad antes de simplemente recopilar más datos.
Por qué ocurre el sobreajuste y cómo detectarlo
El sobreajuste ocurre cuando un modelo aprende patrones que reducen el error de entrenamiento pero no se generalizan a la población objetivo. Las causas incluyen capacidad excesiva en relación con los datos efectivos, ruido en las etiquetas, entidades repetidas, selección flexible de características, fuga de datos y ajuste contra el mismo conjunto de validación. Una brecha creciente entre el rendimiento de entrenamiento y validación es evidencia común, pero una brecha pequeña no descarta el sobreajuste si ambos conjuntos comparten contaminación o difieren de la implementación. Las curvas de aprendizaje en función del volumen de datos y la capacidad ayudan a distinguir varianza de sesgo.
La fuga es especialmente engañosa: información futura, duplicados, superposición de sujetos, preprocesamiento ajustado a todos los datos o etiquetas codificadas en metadatos pueden producir excelentes puntuaciones retenidas. Divida según la unidad que será nueva en la implementación —paciente, cliente, máquina, ubicación o tiempo— antes de ajustar transformaciones o aumentos. Mantenga un conjunto de prueba final sellado mientras elige características, arquitectura y umbrales. Si los equipos inspeccionan repetidamente los resultados de prueba, el conjunto de prueba se convierte en otro conjunto de validación y necesita ser reemplazado o corregido formalmente.
Regularización, selección de modelo y deriva en producción
Reduzca el sobreajuste con datos más representativos, menor capacidad, decaimiento de peso, dropout, detención temprana, aumento de datos, ensamblado o restricciones que reflejen la estructura del dominio. Cada método tiene compensaciones: el aumento puede distorsionar las etiquetas, dropout cambia la optimización y los ensamblados añaden costo de servicio. La validación cruzada estima la variabilidad de la selección, pero los pliegues agrupados o conscientes del tiempo deben preservar el límite de implementación. Compare con un modelo simple y reporte la incertidumbre a través de pliegues o semillas en lugar de seleccionar la ejecución más favorable.
La producción puede revelar una forma diferente de fallo de generalización cuando cambian las entradas, los usuarios, los incentivos o la medición. Monitoree las distribuciones de características y predicciones, la calibración, los resultados de subgrupos y la verdad de base retrasada. No reentrene automáticamente con retroalimentación no revisada; las decisiones del modelo pueden moldear las etiquetas que luego observa. Diagnose si el fallo proviene de deriva, canalizaciones de datos, cambios de política o un objetivo inválido. El sobreajuste se controla mediante el diseño experimental y la disciplina del ciclo de vida, no mediante una única configuración de regularización.
Ejemplo práctico: eliminar la fuga de datos en un modelo de fraude
Un clasificador de fraude inicial obtiene puntuaciones extremadamente altas porque eventos repetidos de tarjetas y comercios aparecen en filas aleatorias de entrenamiento y prueba, y la información de contracargos registrada semanas después se incluye como característica. El equipo reconstruye el momento de disponibilidad de cada característica, elimina los campos posteriores a la decisión, agrupa por cuenta y utiliza una división temporal hacia adelante. El rendimiento cae bruscamente, pero ahora estima la decisión real. Una línea base de reglas simples y curvas de aprendizaje guían la complejidad requerida del modelo.
La regularización y la detención temprana se ajustan solo dentro de los pliegues históricos. La evaluación final informa la precisión a la capacidad de revisión, el recall, la calibración y el costo por tipo de fraude y segmento de cliente. En producción, las etiquetas confirmadas llegan tarde y están sesgadas por las transacciones revisadas, por lo que el monitoreo separa la deriva de la puntuación de las estimaciones de resultados. El reentrenamiento utiliza casos adjudicados y reproducción contra la política actual. El proyecto prefiere una puntuación honesta más baja a una alta filtrada que no puede sobrevivir a la implementación.
Evidencia de implementación y preparación operativa
Una decisión de producción requiere más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes del ajuste. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, fallas de dependencias, uso indebido y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después de la implementación en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Puede un modelo simple sobreajustar?
Sí. La selección repetida de características, el ajuste de umbrales o la evaluación en el mismo conjunto de retención pueden sobreajustar el proceso de desarrollo incluso cuando el modelo final es simple.
¿Siempre más datos de entrenamiento resuelven el sobreajuste?
No. Más datos representativos y correctamente etiquetados pueden ayudar, pero los datos duplicados, sesgados, filtrados o fuera del dominio pueden no hacerlo. El objetivo de aprendizaje y el diseño de la evaluación siguen siendo importantes.
Referencias principales












