
Fundamentos de la IA
¿Qué es la IA explicable?

 Añade Unite.AI a tus fuentes preferidas en Google
IA explicable (XAI) comprende métodos y prácticas que ayudan a las personas a entender el comportamiento o la salida de un sistema de IA. Una explicación puede describir entradas influyentes, mostrar un ejemplo similar, presentar un cambio contrafactual, resumir una regla global o comunicar cuándo el sistema no sabe.
No existe una explicación que sea universalmente la mejor. Un desarrollador que depura un modelo, un auditor que verifica el cumplimiento de políticas y una persona afectada por una decisión necesitan evidencias diferentes. Por lo tanto, las explicaciones deben evaluarse por su exactitud, significado y uso previsto, no solo por su atractivo visual.
Conclusiones clave
- La transparencia describe la información disponible; la interpretabilidad se ocupa del significado; la explicación comunica evidencias o razones.
- Los métodos globales resumen un modelo, mientras que los métodos locales abordan una predicción o una pequeña región.
- Las explicaciones post-hoc pueden ser útiles, pero pueden ser inestables o no fieles al modelo subyacente.
- Una explicación no prueba la equidad, causalidad, robustez o corrección.
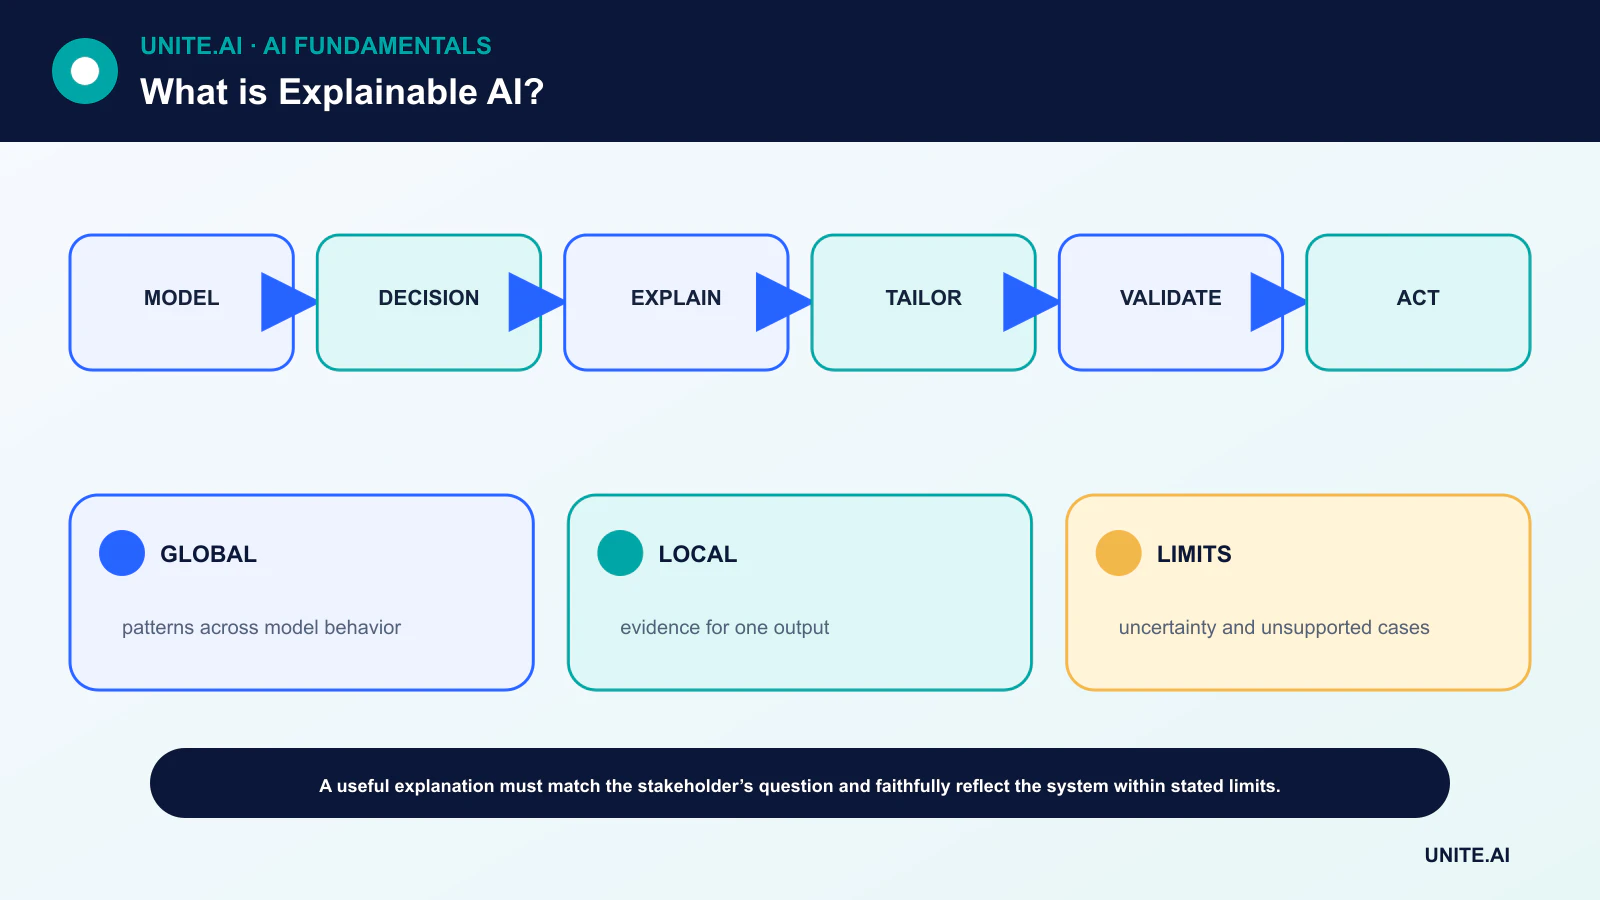
Cuatro principios para explicaciones útiles
NIST propone que un sistema proporcione una explicación, la haga significativa para su usuario previsto, garantice que refleje con precisión el proceso del sistema y comunique sus límites de conocimiento. Estos principios separan la existencia de una explicación de su calidad.
El significado es específico de la audiencia. Un código de razón conciso puede ayudar a un solicitante, mientras que un desarrollador de modelos puede necesitar distribuciones, comportamiento de características y grupos de fallos. Ambos deben estar vinculados al mismo sistema documentado y al contexto de decisión.
Métodos intrínsecos y post-hoc
Un modelo lineal escaso o un árbol de decisión restringido pueden ser directamente interpretables dentro de su ámbito válido. Un modelo complejo, en cambio, puede usar atribución de características post-hoc, un sustituto local, ejemplos, mapas de saliencia o contrafactuales.
La simplicidad intrínseca no es automáticamente fiel cuando las características están mal definidas o la cadena de procesamiento está oculta. La complejidad post-hoc no es automáticamente engañosa. El método debe probarse contra la pregunta que se pretende responder.
Atribución de características y entradas correlacionadas
Los métodos de atribución asignan porciones de una salida a características de entrada bajo supuestos explícitos. LIME ajusta un sustituto local simple alrededor de una predicción; los métodos relacionados con SHAP conectan atribuciones aditivas con conceptos de valores de Shapley.
Las características correlacionadas pueden compartir o intercambiar atribución, y una alta atribución no es un efecto causal. Cambiar una característica de forma aislada puede crear una persona, imagen o transacción imposible. Las explicaciones deben indicar sus supuestos de línea base, muestreo y dependencia.
Contrafactuales, ejemplos y comportamiento global
Un contrafactual pregunta qué cambio factible alteraría un resultado. Las restricciones son esenciales: una explicación accionable no debe recomendar cambios inmutables, ilegales o poco realistas. Los métodos basados en ejemplos muestran prototipos o casos de entrenamiento influyentes, pero pueden exponer datos privados.
El análisis global examina el rendimiento, la dependencia parcial, la monotonía, las interacciones y el comportamiento de subgrupos. Para conjuntos como gradient boosting, combine resúmenes con evidencia local y pruebas directas de las restricciones esperadas.
Validar la explicación y el sistema
Pruebe la fidelidad, la estabilidad bajo pequeñas perturbaciones, la consistencia entre entradas equivalentes, la comprensión del usuario y si la explicación respalda una decisión adecuada. Las pruebas adversarias deben verificar si una explicación persuasiva puede acompañar una salida errónea o manipulada.
La IA explicable forma parte de una evaluación más amplia: calidad retenida, calibración, equidad, privacidad, seguridad, monitoreo y mecanismos de apelación. Una explicación puede apoyar la rendición de cuentas, pero no puede sustituir una gobernanza responsable.
Objetivos de explicación y familias de métodos
La IA explicable debe comenzar con una pregunta y una audiencia: por qué ocurrió una decisión, cómo se comporta generalmente el modelo, qué evidencia lo influyó, qué cambiaría el resultado, o si se siguió una política. Las explicaciones locales abordan una predicción; las explicaciones globales resumen un comportamiento más amplio. Los modelos intrínsecamente interpretables exponen coeficientes, reglas o estructuras, mientras que los métodos post-hoc aproximan modelos complejos. Una explicación del comportamiento del modelo no es automáticamente una explicación causal del mundo ni una justificación de que una decisión sea justa.
Los métodos de atribución de características incluyen gradientes, gradientes integrados, valores estilo SHAP, permutación y modelos sustitutos locales. Las explicaciones basadas en ejemplos recuperan casos influyentes o similares; los contrafactuales proponen cambios asociados a una salida diferente; los métodos de concepto relacionan representaciones internas con categorías humanas. Cada uno tiene supuestos sobre líneas base, independencia de características, linealidad local o acceso al modelo. Variables correlacionadas, interacciones y preprocesamiento pueden hacer que las atribuciones sean inestables o engañosas. Compare los métodos y perturbe las entradas para probar si una explicación predice el comportamiento.
Evaluación y factores humanos
Evalúe la fidelidad —si la explicación coincide con el modelo— por separado de la plausibilidad para una persona. Pruebe la estabilidad, sensibilidad, exhaustividad, escasez y utilidad para una tarea definida, como depuración o apelación. Los estudios humanos necesitan participantes representativos y deben medir la calidad de la decisión, la detección de errores, la dependencia y el tiempo, no si los usuarios dicen que un gráfico se ve claro. Una explicación persuasiva puede aumentar la confianza en un modelo incorrecto, por lo que las interfaces deben mostrar incertidumbre, alternativas y limitaciones.
Los contrafactuales deben ser factibles, accionables y no recomendar cambiar rasgos protegidos o inmutables. Las explicaciones pueden filtrar información del modelo o personal y ayudar a los atacantes a invertir la ingeniería de decisiones. Aplique controles de acceso y minimización de salida. Para usos regulados o de alto impacto, conserve la procedencia de los datos, la versión del modelo, el umbral y la lógica de decisión real; un gráfico genérico de importancia de características no puede reemplazar una razón legalmente significativa o una revisión humana.
Usar explicaciones de manera responsable
Seleccione el modelo más simple que cumpla con el rendimiento y las necesidades operativas, pero no sacrifique la validez por una interpretabilidad superficial. Combine explicaciones con pruebas de subgrupos, verificaciones de robustez, análisis causal cuando sea pertinente y monitoreo de resultados. Documente la audiencia prevista y las inferencias inválidas. Si una explicación cambia después de una perturbación inofensiva, investigue antes del despliegue. La explicabilidad es evidencia sobre un sistema bajo un método; es valiosa para depuración, supervisión y comunicación, pero no certifica la verdad, la equidad, la seguridad o la comprensión.
Ejemplo práctico: explicando un modelo de riesgo crediticio
Un prestamista primero define la audiencia y la razón requerida: los solicitantes necesitan factores de decisión precisos y una vía de corrección, mientras que los desarrolladores necesitan diagnósticos. Una línea base interpretable calibrada se compara con un modelo potenciado. Las atribuciones locales, los contrafactuales y el análisis de error global se prueban para fidelidad, estabilidad, comportamiento de características correlacionadas y utilidad. Las explicaciones no pueden recomendar cambiar la edad, la discapacidad u otro rasgo inmutable, y no se presentan como efectos causales.
El registro de decisiones de producción conserva los datos de origen, la transformación de características, el modelo, el umbral, la política y la acción humana. Los solicitantes pueden impugnar datos incorrectos y recibir una revisión significativa. El monitoreo verifica la estabilidad del resultado y de la explicación entre grupos y actualizaciones del modelo. Si una explicación plausible cambia bajo una perturbación de características inofensiva o omite una regla de política decisiva, se detiene el despliegue. La explicabilidad complementa la validación y los derechos procesales; no excusa un objetivo inválido, resultados discriminatorios o la falta de autoridad humana responsable.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento fuera de línea persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Los mapas de atención son explicaciones?
Pueden ser señales diagnósticas, pero los pesos de atención por sí solos no garantizan representar fielmente las razones de la salida de un modelo.
¿La IA explicable requiere un modelo simple?
No siempre. Los modelos complejos pueden analizarse con métodos post-hoc, pero esas explicaciones necesitan validación independiente y límites claramente establecidos.
Referencias principales












