
Fundamentos de la IA
¿Qué es la interpretabilidad mecanicista? Cómo los investigadores analizan los modelos de IA

 Añade Unite.AI a tus fuentes preferidas en Google
La interpretabilidad mecanicista estudia cómo los componentes aprendidos dentro de una red neuronal generan conductas de manera causal. En lugar de limitarse a correlacionar entradas con salidas, los investigadores formulan hipótesis sobre características, cabezas de atención, neuronas y circuitos, y luego intervienen para probar esas hipótesis.
El campo ha generado explicaciones detalladas para comportamientos seleccionados en modelos pequeños y medianos, pero una descripción completa y fiel de un modelo de vanguardia sigue estando fuera de alcance. Las explicaciones automatizadas y las visualizaciones atractivas pueden ser puntos de partida útiles, pero no constituyen pruebas.
Ideas clave
- Las características son patrones representados; los circuitos son componentes interactivos propuestos para implementar un cálculo.
- El parcheo de activaciones, la ablación y el rastreo causal prueban si un componente modifica un comportamiento.
- La superposición significa que una neurona puede participar en muchas características; los autoencoders escasos intentan una base de características diferente.
- Los métodos de interpretabilidad necesitan una verdad de referencia, pruebas falsificables, cobertura y evaluación frente a explicaciones alternativas.
De la representación al mecanismo
El sondeo pregunta si la información puede decodificarse a partir de una activación. La atribución estima qué entradas o componentes son relevantes. El trabajo mecanicista va más allá al proponer un cálculo interno y verificar si las intervenciones modifican el comportamiento intermedio y final esperado.
Esto lo relaciona, pero lo hace más estrecho que la IA explicable. Una explicación posterior a la decisión para un caso no es necesariamente un algoritmo revertido dentro del modelo.
Circuitos e intervenciones causales
Los investigadores pueden identificar una cabeza de atención o característica asociada a una tarea, ablacionarla, parchear activaciones de otra ejecución o rastrear cómo la información se desplaza a través de capas. Una buena hipótesis predice el comportamiento en nuevos ejemplos y resiste los controles.
Las intervenciones pueden crear estados fuera de distribución, por lo que un cambio de comportamiento no revela automáticamente el cálculo natural. Utilice múltiples métodos, controles emparejados y efectos cuantitativos en lugar de un solo prompt ilustrativo.
Superposición y características escasas
Las redes neuronales pueden representar más características que dimensiones individuales mediante su superposición. Por lo tanto, una neurona puede activarse para varios patrones no relacionados, lo que hace que las etiquetas a nivel de neurona sean engañosas.
Los autoencoders escasos aprenden un diccionario más amplio de características a partir de las activaciones del modelo. Pueden hacer que los patrones sean más separables, pero la escasez elegida, los datos de entrenamiento, el error de reconstrucción y las etiquetas automatizadas influyen en lo que se recupera. Las características de redes neuronales aún requieren validación causal.
Seguridad, depuración y limitaciones
Las herramientas mecanicistas pueden ayudar a encontrar hechos memorizados, sesgos, estrategias engañosas o circuitos de falla y pueden apoyar la edición o el monitoreo. Las mismas herramientas pueden pasar por alto cálculos distribuidos, raros o dependientes del contexto.
Trate los hallazgos como evidencia delimitada: versión del modelo, tarea, conjunto de datos, capa, intervención, efecto e incertidumbre. Conecte la interpretación con evaluaciones conductuales, pruebas de adversarialidad y la gobernanza de IA responsable en lugar de usarla como un certificado de seguridad general.
Representaciones, circuitos y evidencia causal
La interpretabilidad mecanicista estudia cómo los cálculos internos generan el comportamiento del modelo. Los investigadores inspeccionan activaciones, pesos, atención y características intermedias, y luego forman hipótesis sobre representaciones y circuitos. Una representación no está necesariamente almacenada en una sola neurona; puede estar distribuida a través de direcciones, capas, tokens y combinaciones dependientes del contexto.
Los autoencoders escasos intentan descomponer activaciones densas en un conjunto mayor de características que se activan de forma selectiva. Las etiquetas de características son interpretaciones humanas de ejemplos observados, no una verdad de referencia. El error de reconstrucción, la escasez, la división de características, la absorción y las características muertas influyen en lo que la descomposición revela y lo que omite.
La correlación es insuficiente para una afirmación mecanicista. El parcheo de activaciones, la ablación, el rastreo causal, la dirección y las intervenciones dirigidas a pesos prueban si un componente cambia el comportamiento según lo predicho. Las intervenciones también pueden crear estados fuera de distribución, por lo que los resultados necesitan controles, análisis de dosis‑respuesta, explicaciones alternativas y replicación en distintos prompts y modelos.
Un flujo de trabajo riguroso de interpretabilidad
Comience con un comportamiento medido con precisión y un conjunto de datos que separe hipótesis competidoras. Localice capas, posiciones, componentes o características relevantes; inspeccione los mecanismos candidatos; intervenga; y pruebe si el circuito propuesto predice nuevos casos. Mantenga los ejemplos exploratorios separados de la evaluación confirmatoria para reducir el sesgo de selección.
Las herramientas automatizadas pueden clasificar neuronas, características, cabezas o rutas, mientras que los modelos de lenguaje pueden proponer descripciones. La automatización aumenta la cobertura pero puede fabricar historias plausibles. Evalúe las explicaciones en ejemplos de activaciones reservados y predicciones causales, registre la incertidumbre y haga que los artefactos sean reproducibles con la versión del modelo, el tokenizador, los prompts y el código.
Los mecanismos pueden ser polisémicos, redundantes, no lineales y distribuidos. Eliminar un componente puede ser compensado por otros, mientras que una característica puede participar en varios comportamientos. Los hallazgos negativos son informativos: un circuito aparente que falla fuera de los ejemplos curados debe ser restringido o rechazado en lugar de ser salvado con una explicación cada vez más vaga.
Aplicaciones, limitaciones y afirmaciones de seguridad
La interpretabilidad puede ayudar a depurar alucinaciones, sesgos, memorización, comportamientos de vulneración o generalizaciones inesperadas; comparar modelos; y generar hipótesis científicas. También puede identificar características para monitoreo o intervención. Estos usos requieren validación específica de la tarea, ya que una visualización de investigación útil no es automáticamente un control de producción fiable.
La ausencia de una característica detectada no prueba la ausencia de una capacidad o intención, y una característica legible no prueba que el modelo la utilice en una respuesta dada. Las herramientas observan una proyección del cálculo con cobertura limitada. Las afirmaciones de seguridad deben especificar la sensibilidad de detección, falsos positivos, distribución, adversario y puntos ciegos conocidos.
Utilice la interpretabilidad junto con evaluaciones conductuales, pruebas de adversarialidad, gobernanza de datos, controles de acceso, monitoreo y respuesta a incidentes. Publique métodos y contraejemplos cuando sea posible. El campo avanza rápidamente, pero las técnicas actuales no proporcionan una explicación completa y fiel del razonamiento de modelos de vanguardia ni una garantía general de alineación.
Ejemplo práctico: probando un circuito propuesto del modelo
Supongamos que un modelo parece usar un conjunto de cabezas de atención y características para resolver un objeto indirecto en una oración. Los investigadores definen un conjunto de datos controlado con nombres, posiciones, distractores y contraejemplos variados, y luego miden el comportamiento. La inspección de activaciones identifica componentes candidatos, pero la hipótesis se escribe antes de la intervención: qué información lleva cada componente, a dónde se desplaza y cómo su modificación debería alterar la salida.
El parcheo de activaciones y la ablación prueban la necesidad y suficiencia en ejemplos reservados. Una edición dirigida que cambia el token predicho en la dirección esperada respalda el mecanismo; un daño amplio al rendimiento no lo hace. Los controles parchean posiciones y componentes no relacionados, varían la magnitud de la intervención y comparan circuitos alternativos. El equipo publica casos negativos donde la explicación falla y evita asignar un propósito legible por humanos basándose solo en la correlación.
Para afirmar una aplicación de seguridad, el método debe detectar el comportamiento relevante con una sensibilidad conocida bajo prompts realistas y adaptación adversarial. Los monitores de características se evalúan por falsos positivos, evasión, actualizaciones del modelo y relevancia causal. La evidencia de interpretabilidad puede guiar la depuración y pruebas adicionales, pero la aplicación recae en controles externos y monitoreo conductual. Un diagrama de circuito convincente es una hipótesis científica con evidencia, no una explicación completa de un modelo ni una garantía sobre comportamientos no vistos.
Lista de verificación para la implementación práctica
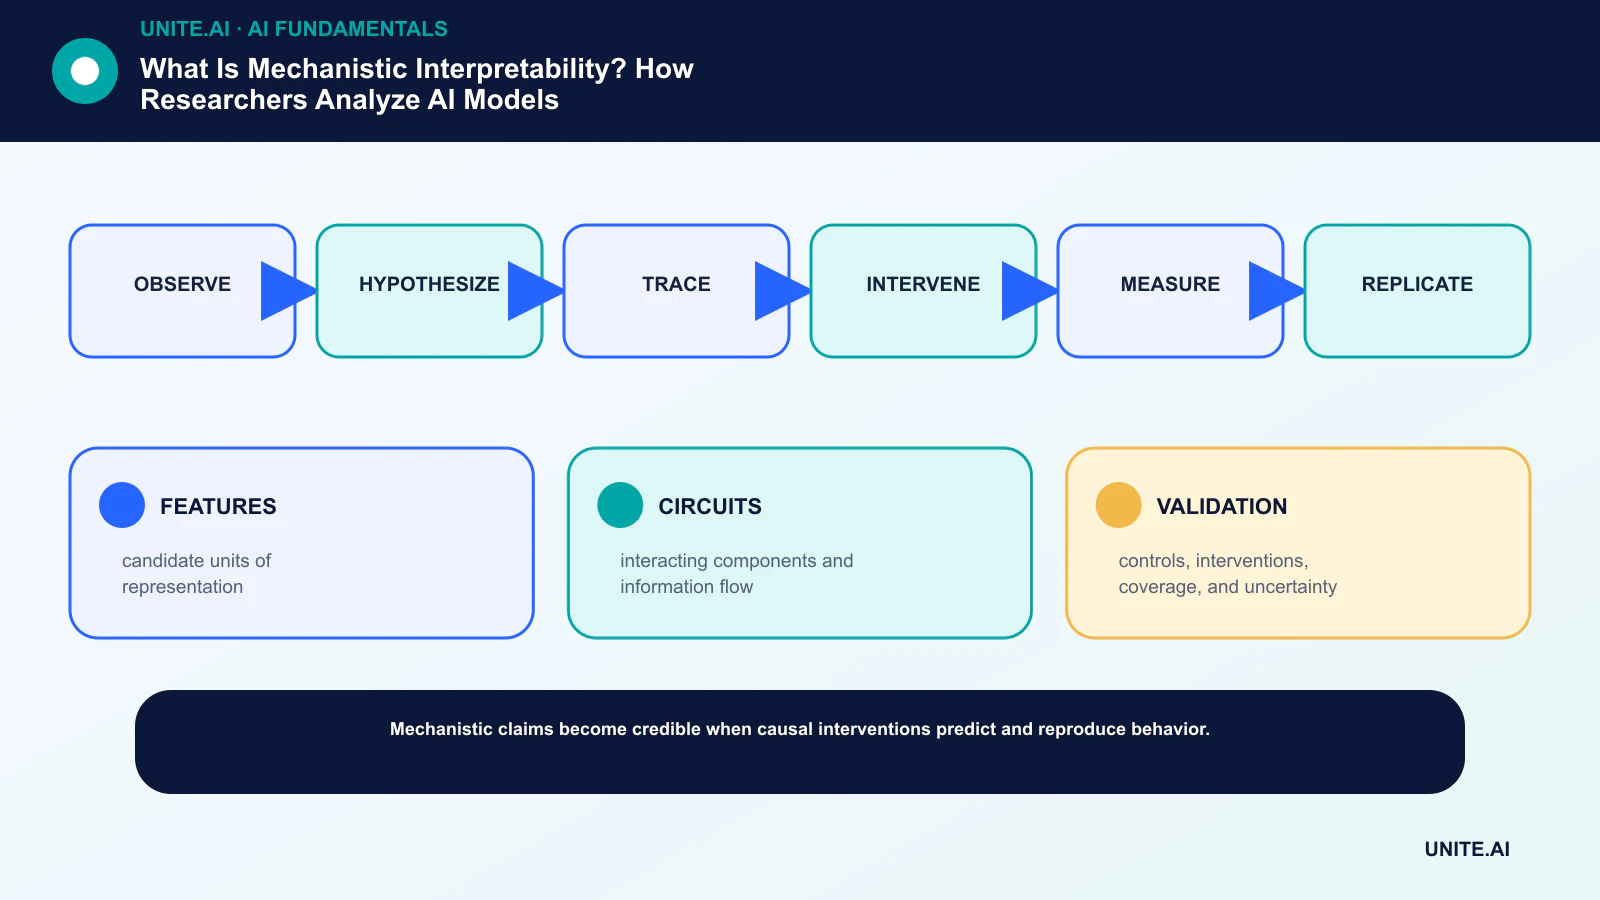
Convierta el concepto en un flujo de trabajo delimitado y verificable: observar → hipotetizar → rastrear → intervenir → medir → replicar. Asigne un responsable, documente los datos y dependencias, establezca una línea base sencilla, defina criterios de aceptación y de detención, pruebe fallas representativas y defina monitoreo, reversión y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y son afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; conserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, anular una salida o detener la operación. Revise la decisión una vez que lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- CARACTERÍSTICAS: unidades candidatas de representación.
- CIRCUITOS: componentes interactivos y flujo de información.
- VALIDACIÓN: controles, intervenciones, cobertura e incertidumbre.
Preguntas frecuentes
¿La interpretabilidad mecanicista es lo mismo que leer los pesos del modelo?
No. Los pesos crudos no se explican por sí mismos. Los investigadores analizan activaciones, características, componentes e intervenciones para construir y probar hipótesis causales.
¿Los autoencoders escasos pueden explicar completamente un LLM?
No. Ofrecen una base de características candidata y pueden apoyar el análisis de circuitos, pero la cobertura, la fidelidad, la reconstrucción, el etiquetado y la escalabilidad siguen siendo problemas abiertos.
Referencias principales












