
Fundamentos de la IA
¿Qué es el aprendizaje por refuerzo?

 Añade Unite.AI a tus fuentes preferidas en Google
Reinforcement learning (RL) es un marco de aprendizaje automático en el que un agente aprende a actuar interactuando con un entorno. Después de cada acción, el entorno cambia y puede devolver una recompensa. El objetivo del agente es aprender una política que maximice la recompensa acumulada esperada, no solo la recompensa de su próximo movimiento.
El aprendizaje por refuerzo se usa cuando las decisiones se desarrollan a lo largo del tiempo y una acción influye en lo que ocurre después. Es conceptualmente diferente del aprendizaje supervisado, donde un conjunto de datos proporciona una respuesta objetivo para cada ejemplo de entrenamiento.
Ideas clave
- Un problema de aprendizaje por refuerzo contiene un agente, un entorno, estados, acciones, recompensas y una política.
- El refuerzo positivo y negativo aumentan el comportamiento; el castigo lo disminuye.
- El agente debe equilibrar la exploración de acciones desconocidas con la explotación de acciones ya conocidas como efectivas.
- Los métodos basados en valores, basados en políticas, actor‑crítico, basados en modelos y fuera de línea resuelven diferentes entornos de aprendizaje por refuerzo.
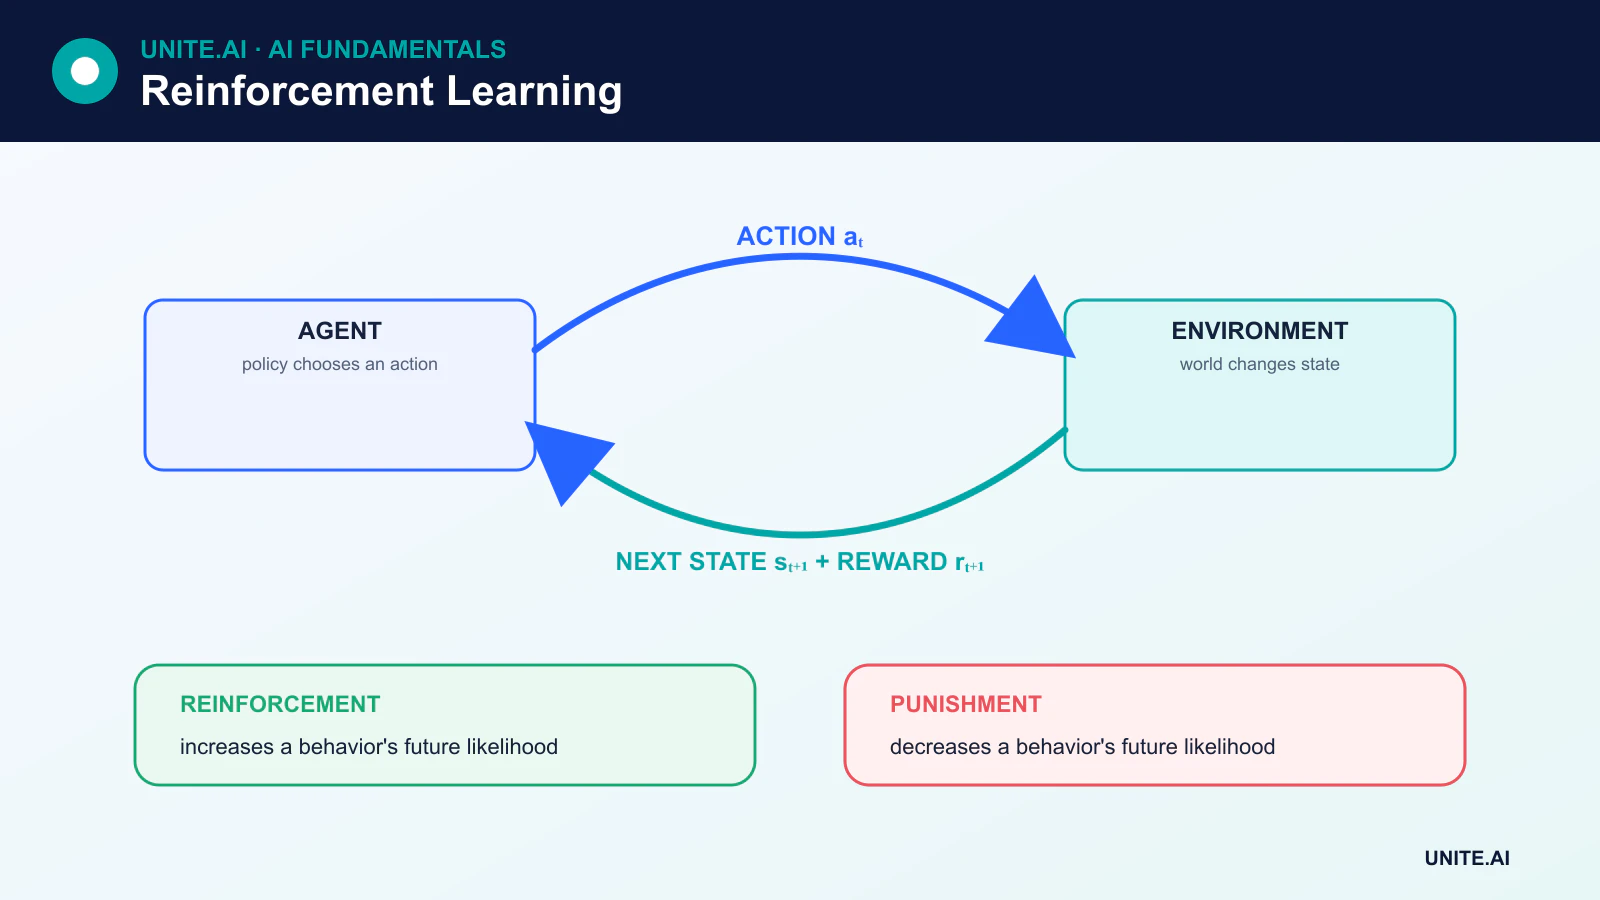
Los componentes del aprendizaje por refuerzo
Muchos problemas de aprendizaje por refuerzo se modelan como un proceso de decisión de Markov (MDP). Un MDP incluye:
- Estado: información que describe la situación actual.
- Acción: una opción disponible para el agente.
- Transición: cómo cambia el estado después de una acción.
- Recompensa: retroalimentación inmediata producida por una transición.
- Política: la estrategia del agente para seleccionar acciones.
- Factor de descuento: cuán fuertemente cuentan las recompensas futuras en relación con las recompensas inmediatas.
Un estado no tiene que exponer todo sobre el mundo. Cuando información importante está oculta, el problema puede ser parcialmente observable y el agente puede necesitar una memoria o un estado de creencia.
El refuerzo no es lo mismo que el castigo
La terminología proviene de la psicología conductual. El refuerzo positivo agrega una consecuencia que hace que un comportamiento sea más probable. El refuerzo negativo elimina una condición desagradable y también hace que un comportamiento sea más probable. Una penalización destinada a hacer que una acción sea menos probable es castigo, no refuerzo negativo.
En el aprendizaje automático, los profesionales suelen hablar directamente sobre recompensas positivas, recompensas negativas, costos y penalizaciones. La cuestión esencial es cómo esas señales moldean el retorno que el agente intenta maximizar.
Retorno, valor y asignación de crédito
Una recompensa describe una transición. El retorno combina recompensas a lo largo del tiempo, generalmente descontando las recompensas que llegan más lejos en el futuro. Una función de valor de estado estima el retorno esperado a partir de un estado, mientras que una función de valor de acción estima el retorno esperado después de tomar una acción particular en ese estado.
Esto genera el problema de asignación de crédito: si un resultado útil llega mucho después, ¿qué acciones anteriores merecen crédito? Los algoritmos de aprendizaje por refuerzo difieren en cómo estiman esta relación.
Aprendizaje Monte Carlo y de diferencia temporal
Los métodos Monte Carlo aprenden a partir de retornos muestreados completos, típicamente después de que termina un episodio. Los métodos de diferencia temporal (TD) actualizan una estimación antes del resultado final combinando la recompensa observada con una estimación de lo que viene a continuación. Por lo tanto, el aprendizaje TD se basa en sus estimaciones de valor actuales.
Ninguna de las dos familias es universalmente mejor. Los objetivos Monte Carlo son insesgados bajo la política muestreada, pero pueden tener alta varianza y requieren la finalización del episodio. Los métodos TD pueden aprender en línea y a partir de tareas continuas, pero sus objetivos basados en arranque introducen sesgo.
Exploración versus explotación
La exploración recopila información probando acciones cuyo valor es incierto. La explotación selecciona la acción que se cree que ofrece el mejor retorno. Un agente que nunca explora puede conformarse con una estrategia pobre; un agente que nunca explota no se beneficia de lo que ha aprendido.
Estrategias simples incluyen la selección de acciones epsilon‑greedy, la exploración basada en confianza, bonificaciones de entropía y métodos de recompensas intrínsecas. En entornos críticos de seguridad, la exploración sin restricciones puede ser inaceptable, por lo que la simulación, las restricciones, los datos fuera de línea o la supervisión humana se vuelven importantes.
Principales enfoques de aprendizaje por refuerzo
Métodos basados en valores
Q‑learning y algoritmos relacionados aprenden valores de acción y derivan una política seleccionando acciones de alto valor. El aprendizaje profundo por refuerzo utiliza redes neuronales para aproximar funciones de valor o políticas cuando los espacios de estado son demasiado grandes para una tabla.
Métodos de gradiente de política
Los métodos de gradiente de política ajustan directamente una política parametrizada para mejorar el retorno esperado. Son útiles para acciones continuas y políticas estocásticas, pero pueden tener estimaciones de gradiente de alta varianza.
Métodos actor‑crítico
Un actor elige acciones mientras un crítico estima el valor y proporciona una señal de aprendizaje. Esto combina la optimización directa de la política con la estimación de valores.
Aprendizaje por refuerzo basado en modelo y sin modelo
Los sistemas basados en modelo aprenden o usan un modelo de transiciones y recompensas para poder planificar. Los sistemas sin modelo aprenden valores o políticas sin modelar explícitamente el entorno. Los métodos basados en modelo pueden usar la experiencia de manera eficiente, pero los errores en el modelo aprendido pueden desorientar la planificación.
Aprendizaje por refuerzo fuera de línea
El aprendizaje por refuerzo fuera de línea aprende a partir de un conjunto de datos fijo en lugar de recopilar nuevas interacciones durante el entrenamiento. Puede reducir el costo o riesgo de la exploración, pero el agente debe evitar sobreestimar acciones poco representadas en los datos.
RLHF y preferencias humanas
El aprendizaje por refuerzo a partir de retroalimentación humana (RLHF) utiliza datos de preferencias para entrenar una señal de recompensa o optimizar directamente una política. Se ha usado para alinear el comportamiento de modelos de lenguaje con juicios humanos. La optimización de preferencias no garantiza la veracidad o seguridad: los resultados dependen de quién proporcionó la retroalimentación, qué se les pidió juzgar y cómo se diseñó el objetivo.
Limitaciones
El aprendizaje por refuerzo puede requerir un número enorme de interacciones, comportarse de forma inestable durante el entrenamiento y explotar atajos no intencionados en una función de recompensa. La evaluación es difícil porque los resultados pueden variar con semillas aleatorias y detalles del entorno. Las buenas prácticas incluyen múltiples ejecuciones, líneas base transparentes, objetivos restringidos, pruebas fuera de distribución y monitoreo para detectar manipulaciones de la recompensa.
Diseñando un problema de aprendizaje por refuerzo: estado, acción, recompensa y horizonte
El aprendizaje por refuerzo modela decisiones secuenciales. El entorno produce una observación, el agente selecciona una acción bajo una política, y una transición genera una recompensa y la siguiente observación. Un proceso de decisión de Markov asume que el estado contiene la información necesaria para predecir futuras transiciones y recompensas; la observabilidad parcial requiere memoria, estado de creencia o representaciones recurrentes. El descuento controla el peso de los resultados retrasados, mientras que las tareas episódicas y continuas requieren definiciones de retorno diferentes. Un diseño deficiente del estado o la acción puede hacer que un objetivo solucionable sea inaprensible.
El diseño de la recompensa especifica el comportamiento indirectamente y es una fuente importante de fallos. Un proxy puede ser explotado: un agente recompensado por velocidad puede ignorar la seguridad, mientras que uno recompensado solo al completar la tarea puede recibir una señal de aprendizaje insuficiente. Añada restricciones y reglas de terminación basadas en requisitos reales, pruebe la sensibilidad de la recompensa e inspeccione trayectorias en busca de estrategias no intencionadas. Los métodos de exploración equilibran la recopilación de información con la explotación del conocimiento actual. Los datos fuera de política pueden mejorar la eficiencia de muestreo, pero el desajuste entre la política de comportamiento y la objetivo requiere algoritmos diseñados para ello.
Evaluación, simulación y despliegue seguro
Los métodos basados en valores estiman el retorno esperado para estados o acciones; los métodos de gradiente de política optimizan una política parametrizada; los métodos actor‑crítico aprenden ambos. El aprendizaje por refuerzo basado en modelo aprende o utiliza la dinámica de transiciones para planificar. La familia apropiada depende del tipo de acción, datos, fidelidad del simulador, horizonte y requisitos de estabilidad. Compare con líneas base heurísticas, supervisadas y de teoría de control. Evalúe el retorno promedio y en el peor caso, violaciones de restricciones, eficiencia de muestreo, robustez a cambios del entorno y varianza entre semillas en lugar de seleccionar una ejecución con la mejor curva de aprendizaje.
La exploración en línea puede ser inaceptable en salud, finanzas, robótica e infraestructura. Entrene en simulación o con datos registrados cuando sea posible, cuantifique la brecha simulador‑realidad y use la evaluación fuera de política con cuidado porque las acciones no vistas carecen de soporte. El despliegue debe limitar acciones, tasa, recursos y zona de operación; incluir la aprobación humana para decisiones trascendentales; y proporcionar un controlador seguro o apagado. Supervise la recompensa junto con los resultados reales porque un agente puede mejorar su puntuación mientras perjudica el objetivo previsto. Revalide después de cambios en el entorno, la política o la recompensa.
Ejemplo práctico: control de energía con aprendizaje por refuerzo
Un operador de edificio modela la temperatura, ocupación, clima, estado del equipo y precio de la electricidad, con acciones limitadas a ajustes seguros de puntos de consigna. La recompensa combina confort, energía, cargos por demanda y restricciones del equipo, pero las violaciones reales de confort se evalúan por separado, de modo que la optimización de la recompensa no puede ocultar daño. El control histórico y el control predictivo basado en modelo proporcionan líneas base. El entrenamiento utiliza un simulador calibrado con clima aleatorio, ruido de sensores y eficiencia del equipo.
Antes de influir en el edificio, la política se ejecuta contra observaciones en tiempo real sin actuar. Los ingenieros inspeccionan trayectorias, márgenes de restricciones y el comportamiento durante festivos, olas de calor, cortes y sensores ausentes. El despliegue limita la tasa y rango de acciones y conserva el controlador de seguridad existente. Un humano puede anular en cualquier momento. El monitoreo compara energía y confort con periodos emparejados, registra intervenciones y revierte si las violaciones, ciclos inesperados o desajustes del modelo superan los umbrales definidos.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, responsable y la consecuencia de cada fallo importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones de borde, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos que probablemente queden desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Use un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de las entradas, el comportamiento de las salidas, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento fuera de línea persistirá. Reevalúe siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Referencias principales












