Grundlæggende AI
Hvad er Deep Learning?

 Føj Unite.AI til dine foretrukne kilder på Google
Deep learning er en familie af maskinlæringsmetoder, der bruger neurale netværk med flere behandlingslag til at lære nyttige repræsentationer af data. Disse modeller driver mange moderne systemer for sprog, billeder, lyd, anbefalinger, videnskabelig forudsigelse og generativ AI.
Ordet deep refererer til antallet af transformationer mellem input og output, ikke til at en maskine besidder dybere forståelse. En dyb model lærer numeriske relationer, der er nyttige for dens træningsmål, og dens ydeevne skal stadig testes på nye data.
Vigtige pointer
- Deep learning er en underkategori af maskinlæring.
- Lagene transformerer tensorer ved hjælp af lærte parametre, ikke-lineære aktiveringer, normalisering og andre operationer.
- Backpropagation beregner gradienter; en optimizer bruger disse gradienter til at opdatere trænbare parametre, inklusive vægte og bias.
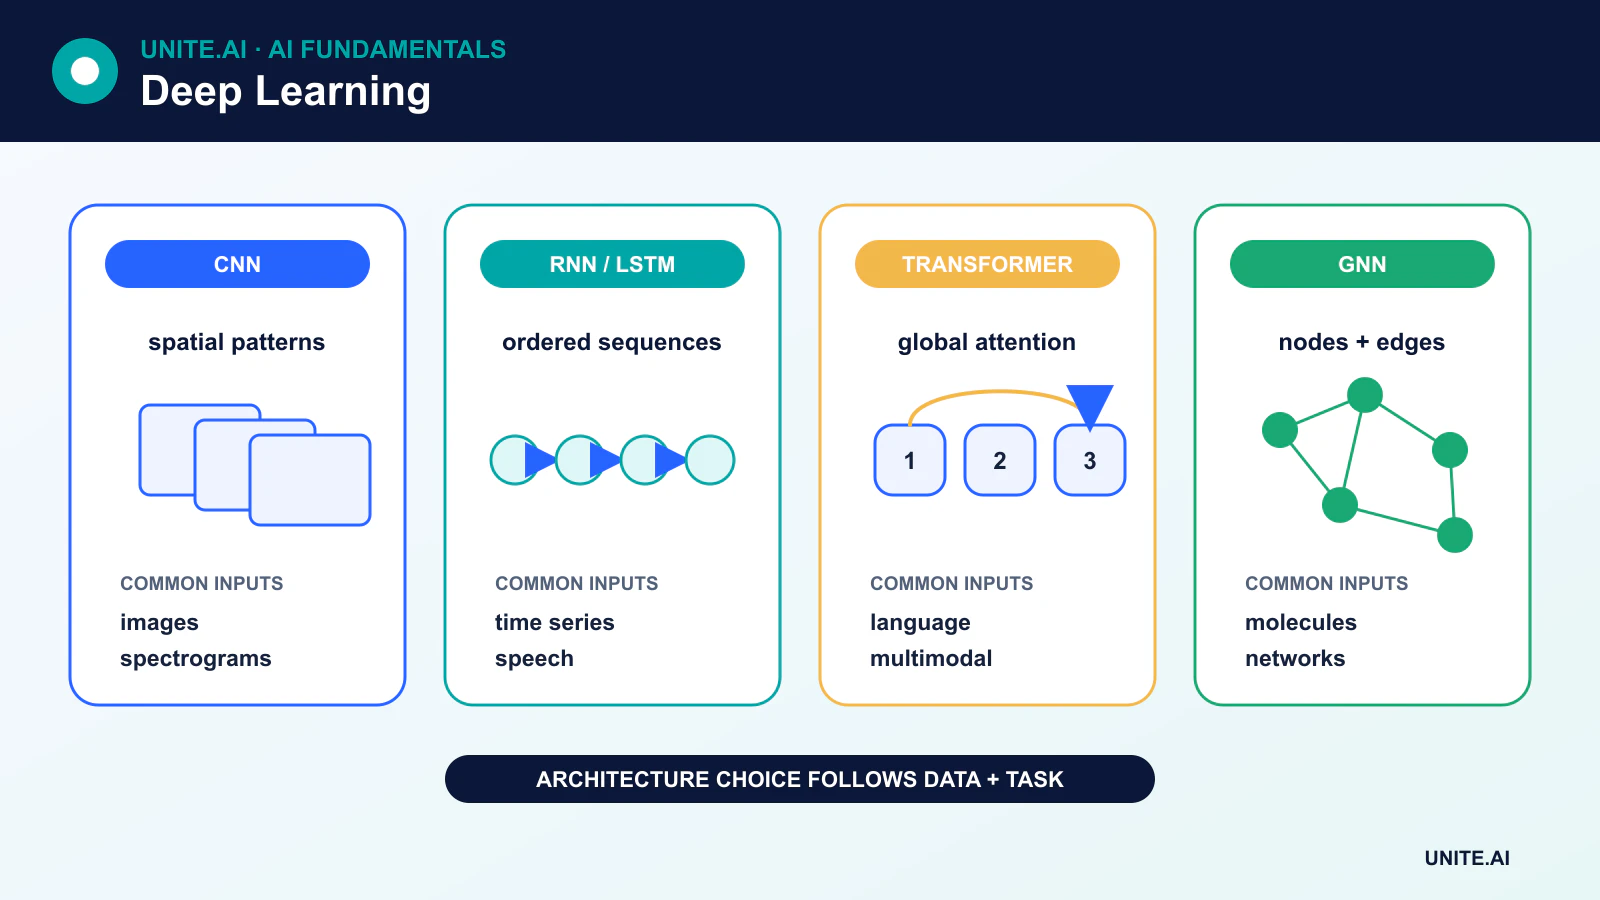
- CNN’er, rekurrente netværk, transformere, autoenkodere og diffusionsmodeller har forskellige strukturer og styrker.
Hvordan et dybt neuralt netværk lærer
Et neuralt netværk modtager data som tensors, eller multidimensionelle arrays af tal. En billedtensor kan kode pixelkanaler, mens en sprogmodel bruger vektorer, der repræsenterer tokens. Hvert lag udfører en differentiabel transformation og videregiver resultatet til det næste lag.
I et grundlæggende tæt lag beregner modellen en vægtet sum af sine input, tilføjer en trænbart bias, og anvender derefter en aktiveringsfunktion:
output = activation(Wx + b)
Aktiveringsfunktionen introducerer ikke‑linearitet. Uden den ville stablede almindelige lineære lag kun repræsentere en lineær transformation. ReLU og dets varianter er almindelige i skjulte lag, mens output‑aktiveringer afhænger af opgaven.
Træning følger typisk fire trin:
- Et forward pass producerer forudsigelser.
- En loss‑funktion måler, hvordan forudsigelserne afviger fra målet.
- Backpropagation anvender kæderegel til at beregne gradienten af loss‑funktionen med hensyn til hver trænbart parameter.
- En optimizer såsom stochastic gradient descent eller AdamW opdaterer parametrene.
Gentagelse af disse trin over mange batches kan forbedre modellen, men lavere trænings‑loss garanterer ikke pålidelig adfærd i den virkelige verden. Validering, regularisering, repræsentative data og overvågning forbliver essentielle.
Vigtige dyb‑læringsarkitekturer
Flere lag perceptroner
Et multilayer perceptron (MLP) bruger fuldt forbundne lag, hvor hver output‑enhed afhænger af alle input fra det foregående lag. MLP’er er nyttige til tabelbaserede funktioner og som komponenter i større systemer, men de bygger ikke ind antagelser om billedlokalitet eller sekvensorden.
Konvolutionelle neurale netværk
Convolutional neural networks (CNN’er) anvender lærte filtre på tværs af lokale regioner. Vægtdeling gør dem effektive for gitter som billeder og spektrogrammer. CNN’er forbliver vigtige for vision og edge‑deployment, selvom vision‑transformere og hybride modeller også er udbredte.
Rekurrente netværk, LSTM’er og GRU’er
Recurrent neural networks (RNN’er) opdaterer en skjult tilstand, mens en sekvens behandles. LSTM’er og gated recurrent units hjælper med at bevare information og reducere problemet med forsvindende gradienter, som får grundlæggende RNN’er til at kæmpe med lange afhængigheder. De eliminerer ikke alle begrænsninger ved lang kontekst, men de er stadig nyttige til streaming‑signaler, tidsseriedata og kompakte sekventielle modeller.
Transformere
Transformere bruger attention til at modellere relationer mellem elementer i en sekvens eller et sæt. Deres evne til at behandle mange positioner parallelt hjalp dem med at erstatte rekurrence i de fleste store sprog‑systemer, og transformer‑varianter behandler nu billeder, lyd, video, proteiner og multimodale data.
Autoenkodere og generative modeller
En autoencoder komprimerer et input til en repræsentation og rekonstruerer inputtet derfra. Dette skaber et selv‑superviseret rekonstruktionsmål; det konverterer ikke automatisk ulabelled data til labellede eksempler.
Generative adversarial networks træner en generator og en diskriminator i konkurrence. Diffusion models lærer at vende en gradvis støjprocess. Autoregressive transformere genererer én token eller enhed ad gangen. Disse tilgange har forskellige træningsdynamikker, kontrolmuligheder og beregningskrav.
Hvorfor dybde hjælper – og hvorfor arkitektur betyder noget
Flere lag giver en model mulighed for at sammensætte enklere transformationer til mere komplekse. I vision kan nogle lærte funktioner udvikle sig fra lokale teksturer til opgave‑specifikke mønstre. I sprog bygger attention‑lag kontekst‑afhængige token‑repræsentationer. Disse beskrivelser er nyttige intuitioner, ikke faste regler for, hvad hvert lag skal lære.
Moderne netværk afhænger også af residual‑forbindelser, normalisering, omhyggelig initialisering, regularisering og optimeret hardware. At tilføje lag eller parametre kan gøre en model sværere at træne, langsommere eller mere tilbøjelig til overfitting. Model‑skala hjælper kun, når data, mål, optimering og implementeringsmiljø understøtter det.
Træning vs. inferens
Træning justerer parametre og er typisk den beregningstunge fase. Inferens kører den trænede model for at producere et output. Inferens kan stadig være dyrt for store modeller, hvilket er grunden til, at teams bruger kvantisering, destillation, batching, caching, sparsitet og specialiseret hardware såsom neural processing units.
Begrænsninger og ansvarlig brug
Dybe modeller kan arve bias, memorere følsomme oplysninger, fejle under distributionsskift og producere overbevisende men forkerte output. De kan også være svære at fortolke og dyre at træne. Evaluering bør dække mere end et benchmark‑gennemsnit: teams har brug for klasse‑ eller undergruppe‑niveau ydeevne, robusthed, kalibrering, sikkerhed, latenstid, energiforbrug og konsekvenserne af fejl.
Repræsentationer, optimering og arkitekturvalg
Dybe netværk lærer successive repræsentationer gennem parametrelag. Lineære transformationer blander input; ikke‑lineære aktiveringer gør det muligt for netværket at approksimere komplekse funktioner; normalisering og residual‑forbindelser hjælper optimeringen; attention, convolution, rekurrence eller state‑space‑operationer indkoder forskellige strukturelle antagelser. Dybde øger antallet af transformationer, men garanterer ikke intelligens. Arkitekturen bør afspejle modaliteten, datamængden, latenstid, hukommelse og invarians for opgaven. En mindre konvolutionel model kan overgå en transformer, når data er begrænset og lokal rumlig struktur dominerer.
Træning beregner en loss, differentierer den med backpropagation og opdaterer parametre med en optimizer såsom stochastic gradient descent eller Adam. Batch‑størrelse, læringsrate, plan, initialisering, regularisering og numerisk præcision interagerer. Kurver for trænings‑ og validerings‑loss hjælper med at skelne under‑fitting, over‑fitting, ustabilitet og lækage, men de fastslår ikke nytte i den virkelige verden. Brug uafhængige evalueringsdata, gentagne kørsel hvor varians er vigtig, ablationer og sammenligning med enklere baselines. Store parameterantal øger også behovet for datastyring, beregningsplanlægning og reproducerbar konfiguration.
Sikker og effektiv betjening af dybe modeller
Implementering kan bruge en hosted endpoint, dedikeret accelerator, browser, telefon eller indlejret enhed. Eksport og kompilering kan flette operatorer, kvantisere vægte og aktiveringer eller ændre numerisk adfærd, så valider den implementerede artefakt i stedet for kun trænings‑checkpointet. Mål kold start, stabil latenstid, gennemløb, hukommelse, strømforbrug og kvalitet ved realistiske batch‑ og sekvensstørrelser. Komprimeringsmetoder — pruning, distillation, kvantisering og low‑rank adaptation — bytter størrelse eller hastighed mod nøjagtighed og ingeniørkompleksitet og skal vurderes på følsomme klasser og kant‑cases.
Dybe modeller kan fejle selvsikkert under distributionsskift, adversarial input, falske korrelationer og dårligt repræsenterede grupper. Overvåg input‑ og output‑distributioner, opgave‑resultater, kalibrering, ressourceforbrug og afhængighedsversioner. Brug adgangskontrol, signerede artefakter, beskyttede træningsdata, red‑teaming og rate‑limits passende til trusselsmodellen. Forklaringer såsom saliency‑maps eller attention‑visninger er diagnostisk bevis, ikke bevis på kausalitet. Kombinér dem med adfærdstests, kontrafaktiske analyser, menneskelig gennemgang, hændelsesrespons og eksplicitte begrænsninger på automatiserede beslutninger.
Praktisk eksempel: træning af en billeddefektdetektor
En fabrik indsamler produktbilleder fra forskellige kameraer, skift, materialer og kendte defektklasser og opdeler dem derefter efter produktionsbatch, så næsten‑duplikerede elementer ikke kan krydse partitioner. En lille konvolutionel baseline sammenlignes med et fortrænet dybt netværk. Augmentation gengiver valideret belysning og synsvinkelvariation uden at slette defekter. Evalueringen rapporterer per‑defekt recall, false‑reject‑rate, kalibrering, inferens‑latenstid og robusthed over for sløring, blænding, udskiftning af kamera og sjældne materialefarver.
Den eksporterede model og den præcise resize‑, farve‑ og normaliserings‑kode testes på linjens hardware for vedvarende gennemløb og termisk adfærd. Lav‑tillids‑sager sendes til inspektører; en uafhængig regel stopper linjen ved sikkerhedskritisk sensorfejl. Billeder gemmes kun som tilladt, og model‑artefakter er signerede. Overvågning forbinder forudsigelser med senere inspektionsresultater og produktionslotter. Et nyt kamera eller materiale udløser en kontrolleret revurdering i stedet for tavs online‑læring fra uanmeldte labels.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsebetingelser, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underbetjent. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis rollout, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret gendannelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Primære referencer