
Grundlæggende AI
Hvad er backpropagation?

 Føj Unite.AI til dine foretrukne kilder på Google
Backpropagation er algoritmen, der bruges til at beregne, hvordan et neural network’s loss changes with respect to its trainable parameters. Den anvender kædereglen i calculus baglæns gennem de operationer, der er registreret under en fremadpas.
Backpropagation beregner gradienter; den bestemmer ikke opdateringen alene. En optimizer såsom stochastic gradient descent eller AdamW bruger disse gradienter til at ændre vægte, bias og andre trænbare parametre.
Vigtige pointer
- Fremadpassagen opbygger mellemliggende værdier og producerer en forudsigelse.
- Tabsfunktionen omdanner forudsigelsen og målet til et skalar træningsmål.
- Backpropagation bruger lokale afledte og kædereglen til effektivt at beregne parametergraidenter.
- Moderne frameworks implementerer reverse-mode automatisk differentiering over en beregningsgraf.
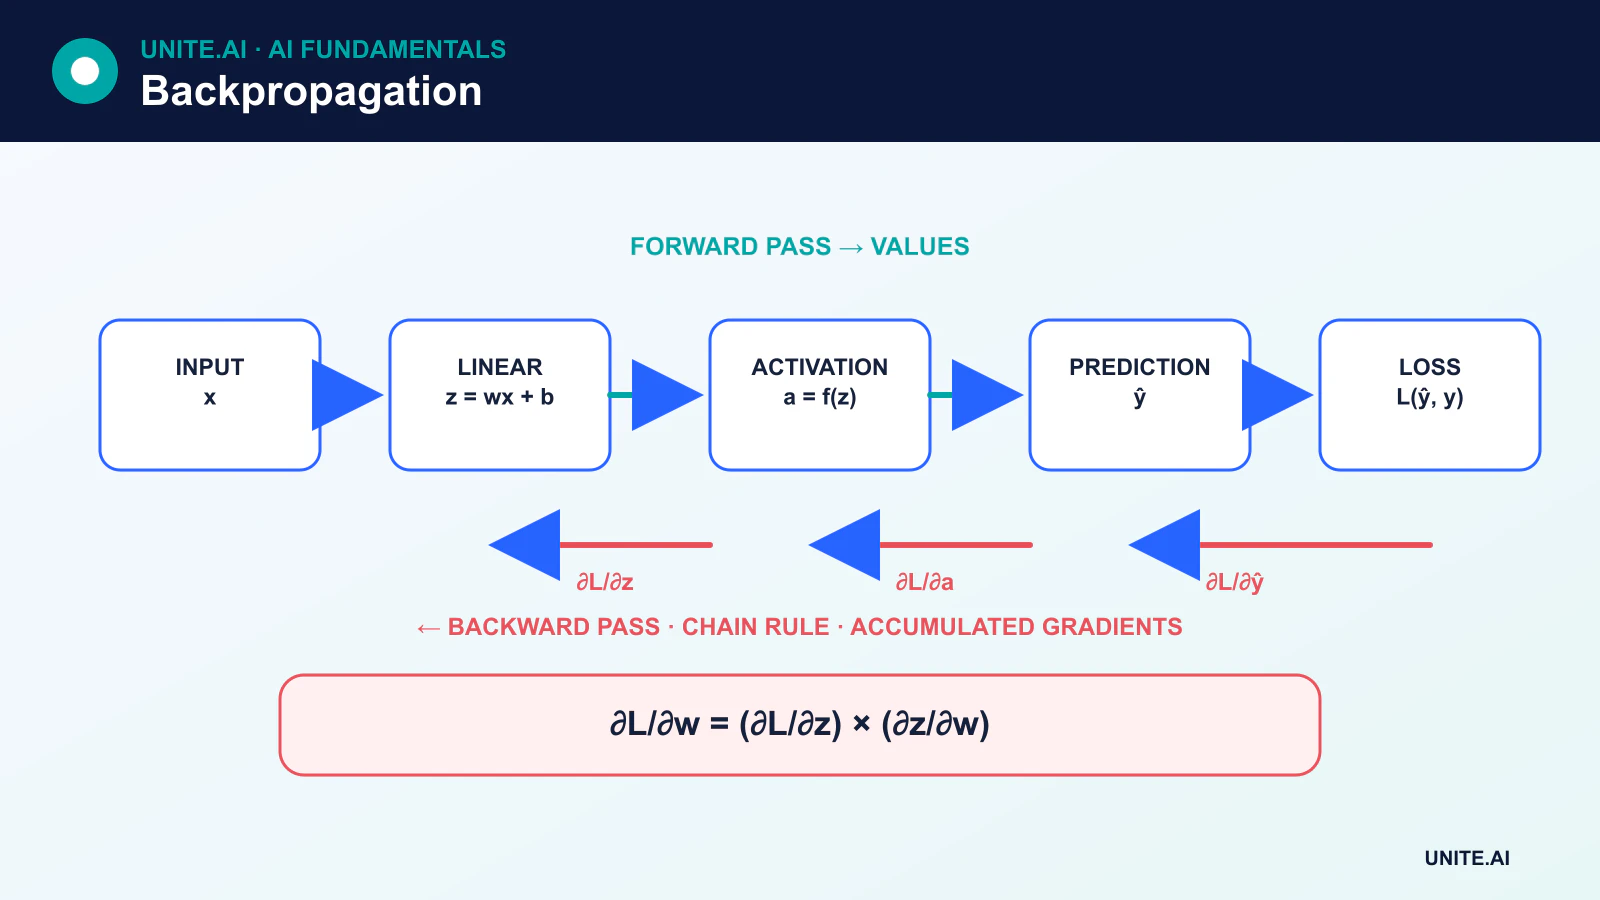
Fremadpassagen
Overvej en simpel enhed:
z = wx + bŷ = activation(z)
Inputtet er x, mens w og b er trænbare vægt- og bias‑parametre. Bias ændres normalt under træning på samme måde som vægte. Et netværk kombinerer mange sådanne operationer samt normalisering, attention, convolutioner, residualforbindelser eller andre differentiable blokke.
Fremadpassagen evaluerer disse operationer og producerer en forudsigelse. Et tab som kryds‑entropi eller middelkvadreret fejl måler målet. Det optimale tab afhænger af opgaven og output‑fortolkningen.
Kædereglen
Hvis tabet L afhænger af en mellemliggende værdi z, og z afhænger af parameteren w, giver kædereglen:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Et dybt netværk indeholder mange stier. Backpropagation traverserer beregningsgrafen i omvendt retning og akkumulerer bidrag, når en værdi påvirker tabet gennem mere end én sti. Resultatet er en gradient for hver trænbare parameter, der deltog i fremadpassagen.
Et lille numerisk eksempel
Antag ŷ = wx + b, med x = 2, w = 3 og b = 1. Forudsigelsen er 7. Hvis målet er 5 og tabet er L = ½(ŷ - y)², så:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Optimizeren kan derefter flytte w og b i den negative gradientretning. Denne formel er specifik for den valgte lineære enhed og kvadreret‑fejl‑tab; en universel backpropagation‑regel er kædereglen over den faktiske graf, ikke en fast “fejl”‑ligning.
Backpropagation versus gradient descent
Gradient descent er en optimeringsmetode. Backpropagation leverer de gradienter, den har brug for. Et træningstrin følger typisk:
- Ryd eller nulstil lagrede gradienter.
- Kør fremadpassagen.
- Beregn tabet.
- Kør bagudpassagen.
- Anvend optimizeren opdatering.
At adskille disse begreber gør det lettere at forstå momentum, AdamW, gradientakkumulering og mixed‑precision træning.
Automatisk differentiering
Frameworks såsom PyTorch registrerer operationer og bygger en graf under fremadpassagen. Reverse‑mode automatisk differentiering beregner derefter vektor‑Jacobian‑produkter effektivt fra output tilbage til parametre. Dette er mere generelt end manuelt at kode afledte for et fast netværk og er grundlæggende for moderne deep learning-frameworks.
Nogle operationer er ikke‑differentierbare eller har ustabile afledte. Frameworks definerer subgradienter eller dokumenterede konventioner i visse tilfælde, men praktikere skal stadig forstå frakoblede tensors, in‑place operationer og numerisk præcision.
Forsvindende og eksploderende gradienter
Gentagen multiplikation gennem mange lag eller tids‑trin kan gøre gradienter ekstremt små eller store. Forsvindende gradienter sænker læringen i de tidlige lag; eksploderende gradienter destabiliserer opdateringer. ReLU‑familie‑aktiveringer, omhyggelig initialisering, residualforbindelser, normalisering, gated rekurrence og gradientklipning hjælper, men ingen er en universel kur.
Kontrol af gradienter
Finite‑difference gradientkontrol sammenligner en analytisk eller automatisk gradient med en numerisk tilnærmelse. Den er langsom men nyttig til fejlsøgning af brugerdefinerede operationer. Overvågning af gradientnormer og detektion af NaN‑ eller uendelige værdier kan afsløre ustabilitet under træning.
Kædereglen gennem en beregningsgraf
Backpropagation beregner effektivt gradienter af et skalar‑tab i forhold til hver differentiable parameter. En fremadpas registrerer mellemliggende værdier i en beregningsgraf. Startende fra tabet anvender reverse‑mode automatisk differentiering kædereglen, multiplicerer lokale afledte og akkumulerer bidrag hvor stier mødes. For et lag y=f(x,w) kombinerer upstream‑sensitivitet til y med partielle afledte for at producere sensitivitet for x og w. Backpropagation beregner gradienter; optimizeren bestemmer hvordan parametrene ændres.
Et simpelt affint lag producerer y=Wx+b. Gradientet for W er det ydre produkt af upstream‑gradienten og inputtet, gradientet for b summerer upstream‑værdier, og input‑gradienten multipliceres med den transponerede vægtmatrix. Aktiveringer tilføjer elementvise afledte. Convolution, normalisering, attention og rekurrent genbrug følger samme grafprincip, men kræver korrekte tensor‑former, broadcasting, masking og parameter‑deling. Frameworks frigiver gemte aktiveringer efter bagudpas, medmindre de bevares, så hukommelsen vokser ofte med batch‑størrelse, dybde og sekvenslængde.
Gradientfejl, verifikation og ingeniørpraksis
Produkterne af mange afledte kan forsvinde eller eksplodere. ReLU‑lignende aktiveringer, omhyggelig initialisering, normalisering, residualforbindelser, gating og gradientklipning adresserer forskellige mekanismer. Mættede aktiveringer og ikke‑differentierbare operationer kan blokere nyttige signaler; afkortet backpropagation begrænser sekvenshistorik; mixed‑precision kan underflowe uden loss‑scaling. Eksploderende gradienter er et symptom, så klipning bør ledsages af undersøgelse af læringsrate, data, arkitektur og numeriske fejl i stedet for at skjule dem.
Verificer brugerdefinerede operationer med finite‑difference gradientkontrol på små double‑precision input, undgå ikke‑differentierbare punkter. Inspicer gradientnormer, NaN‑værdier, inaktive parametre, og om gradienterne når de forventede moduler. Ryd akkumulerede gradienter bevidst og skeln mellem træning og evalueringsadfærd for dropout og normalisering. Checkpointing genberegner aktiveringer for at spare hukommelse; distribueret træning skal aggregere gradienter konsistent. Et faldende træningstab viser, at en optimeringsvej eksisterer, ikke at gradienterne er konceptuelt korrekte, data er lækagefri, eller modellen generaliserer.
Eksempel: verifikation af et brugerdefineret neuralt lag
En ingeniør implementerer et differentiabelt spektrallag til et audio‑netværk. En lille double‑precision test sammenligner automatiske gradienter med centrale finite‑differences over input og parametre, ekskluderende punkter hvor operationen bevidst er ikke‑differentierbar. Form, broadcasting, padding og kompleks‑til‑real konvertering får separate tilfælde. Testen verificerer akkumulerede gradienter når en parameter genbruges og bekræfter at maskerede audio‑rammer ikke producerer gradient.
Under træning sporer dashboards gradient‑ og aktiveringsnormer, NaN‑værdier, inaktive parametre og loss‑scaling. En bevidst korrumperet batch bekræfter at validering fanger ikke‑finite output før en optimizeren opdatering. Mixed‑precision og eksporterede implementeringer sammenlignes med referencen. Checkpoint‑genoptagelses‑tests inkluderer optimizeren‑tilstand og tilfældig rækkefølge. Laget accepteres ikke blot fordi det samlede tab falder; enhedsgradienter, numerisk stabilitet og downstream‑generalisation skal alle give konsistent evidens.
Implementeringsbevis og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug, og de grupper eller miljøer der sandsynligvis er underbetjent. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre inputkvalitet, output‑adfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter virkelige beviser efter implementering i stedet for at antage at offline‑præstationen vil bestå. Revurder når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret gendannelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer, og et klart tidspunkt hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Opdaterer backpropagation vægtene?
Backpropagation beregner gradienter. Optimizeren anvender en opdatering ved hjælp af disse gradienter, dens læringsrate og eventuelt tilstand som momentum eller adaptive moments.
Er backpropagation biologisk realistisk?
Standard backpropagation er en ingeniøralgoritme og accepteres ikke som en detaljeret model for læring i biologiske hjerner. Den historiske neurale analogi bør ikke betragtes som biologisk ækvivalens.
Primære referencer












