
Grundlæggende AI
Hvad er maskinlæring?

 Føj Unite.AI til dine foretrukne kilder på Google
Maskinlæring (ML) er en gren af kunstig intelligens, hvor et system lærer mønstre fra data, så det kan foretage forudsigelser, klassifikationer, anbefalinger eller beslutninger uden at en udvikler skal skrive en separat regel for hver tænkelig situation. Resultatet er ikke en maskine, der “tænker” som et menneske. Det er en statistisk model, der kortlægger input til nyttige output og kan evalueres på data, den ikke har set under træning.
Maskinlæring er en del af det bredere AI‑område, mens dyb læring er en familie af maskinlæringsmetoder bygget omkring flerlagede neurale netværk. Denne sondring er vigtig: ikke alle AI‑systemer bruger ML, og ikke alle ML‑problemer kræver et neuralt netværk.
Vigtige pointer
- ML lærer en relation ud fra eksempler i stedet for kun at stole på håndskrevne regler.
- En brugbar model skal kunne generalisere til nye data, ikke blot memorere sit træningssæt.
- Supervised, unsupervised, semi-supervised, self-supervised og reinforcement learning løser forskellige typer af problemer.
- Datakvalitet, evalueringsdesign og overvågning er lige så vigtige som algoritmen.
Hvordan maskinlæring fungerer
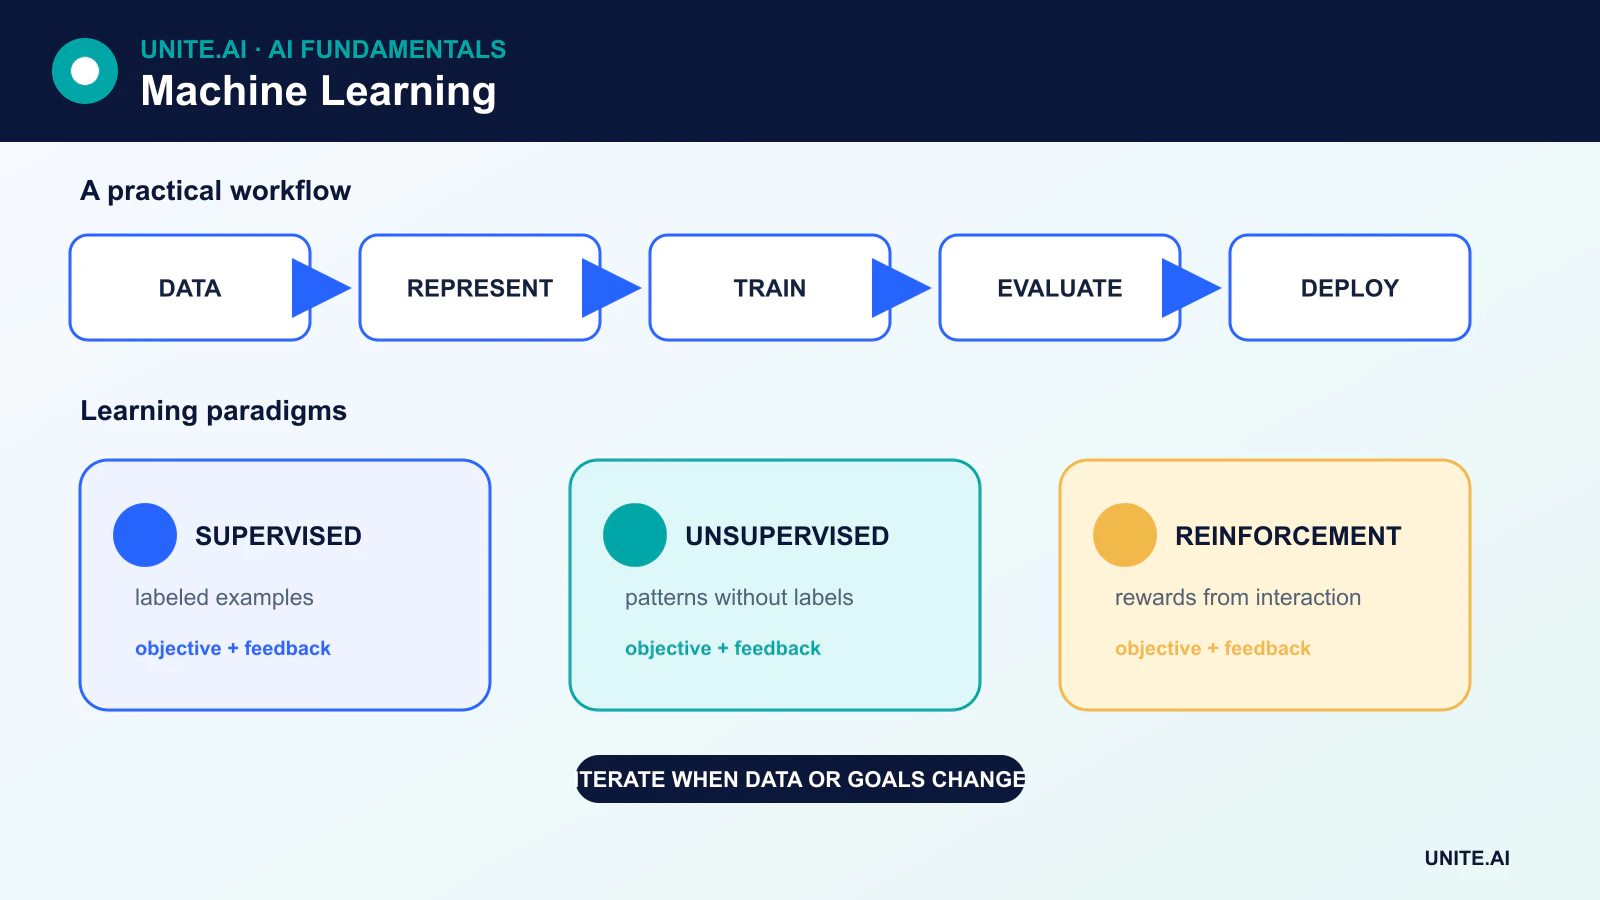
De fleste ML‑projekter kan forstås som en sekvens af seks trin:
- Definér opgaven. Beslut, hvad systemet skal forudsige eller opdage, og hvad succes betyder i den reelle anvendelse.
- Indsaml og forbered data. Rens poster, håndter manglende værdier, skab nyttige funktioner, og dokumentér hvor dataene kommer fra.
- Opdel dataene. Et træningssæt bruges til at tilpasse modellen, et valideringssæt hjælper med at vælge indstillinger, og et testsæt giver et endeligt estimat på ubrugte data.
- Træn modellen. En algoritme justerer modelparametre for at reducere en tabsfunktion eller opfylde et andet læringsmål.
- Evaluer generalisering. Metrikker skal afspejle opgaven, klassebalance, fejlkostnader og den population, som modellen skal operere på.
- Implementér og overvåg. Virkelige data kan ændre sig, så teams holder øje med drift, ydeevnedekadence, bias og driftsfejl.
Variablerne, der leveres til en model, kaldes almindeligvis features. I supervised learning kaldes det ønskede svar for label eller target. En models indlærte parametre indkoder en relation mellem features og output; de er ikke en database af eksplicitte regler.
De vigtigste læringsparadigmer
Overvåget læring
I overvåget læring indeholder eksempler både input og kendte mål. En klassifikationsmodel forudsiger kategorier, f.eks. om en transaktion er svigagtig. En regressionsmodel forudsiger en kontinuerlig værdi, f.eks. forventet energiefterspørgsel.
Almindelige overvågede algoritmer inkluderer decision trees, support vector machines, K-nearest neighbors, lineær og logistisk regression, gradient‑boostede træer og neural networks. En klassifikationsgrænse som 0.5 er en beslutning, der vælges efter at en model har produceret en score eller sandsynlighed; den er ikke en uforanderlig egenskab ved logistisk regression.
Uovervåget læring
Uovervåget læring arbejder med data, der ikke indeholder mål‑labels. Målet kan være at finde klynger, opdage usædvanlige observationer, estimere en fordeling eller skabe en lavere‑dimensional repræsentation. En klynge er en gruppe foreslået af en lighedsregel; den er ikke automatisk en meningsfuld klasse i den virkelige verden.
Eksempler inkluderer K-means clustering, principal component analysis, tæthetsestimering og nogle former for autoencoders. En autoencoder lærer at rekonstruere sit input gennem en komprimeret repræsentation. Den skaber ikke automatisk sand‑grund‑labels.
Semi‑overvåget og selv‑overvåget læring
Semi‑overvåget læring kombinerer et lille mærket datasæt med et større umærket datasæt. Selv‑overvåget læring skaber et træningssignal fra selve dataene — for eksempel ved at forudsige maskeret ord eller matche to transformerede visninger af det samme billede. Selv‑overvågning er central i mange moderne transformer– og grundlæggende model‑pipelines, fordi den kan bruge store samlinger af tekst, billeder, lyd eller video uden at en person mærker hvert eksempel.
Forstærkningslæring
I forstærkningslæring udfører en agent handlinger i et miljø og modtager belønninger eller omkostninger. Målet er at lære en politik, der maksimerer forventet kumulativ belønning. Dette adskiller sig fra overvåget læring, fordi den korrekte handling ikke leveres for hver tilstand, og en handling kan påvirke, hvilke data agenten møder næste gang.
Træning, validering og generalisering
En model, der klarer sig godt på sine træningseksempler, kan stadig fejle på nye data. Denne fejl kaldes overfitting. Teams reducerer den gennem passende modelkapacitet, regularisering, kryds‑validering, data‑augmentation, forebyggelse af lækage og et ægte uafhængigt testsæt.
Der findes ingen enkelt metrik for enhver ML‑opgave. Klassifikation kan kræve præcision, recall, F1, kalibrering eller en omkostnings‑vægtet måling i stedet for rå nøjagtighed. Regression kan anvende gennemsnitlig absolut fejl, rodfirkantet middel‑kvadreret fejl eller et domænespecifikt tab. Klyngedannelse kræver forskellige former for intern eller eksternt valideret evaluering. Metrikken bør afspejle, hvad en fejl betyder for brugeren eller organisationen.
Maskinlæringsalgoritmer er værktøjer, ikke garantier
En algoritme medfører antagelser. Lineære modeller antager en bestemt form for relation. K-nearest neighbors antager, at den valgte afstand repræsenterer meningsfuld lighed. Naive Bayes antager, at features er betinget uafhængige givet klassen. Decision trees opdeler feature‑rummet ved hjælp af indlærte split‑regler; deres blade indeholder forudsigelser baseret på grupper af træningsobservationer snarere end nødvendigvis én observation hver.
Modelvalget afhænger derfor af datastørrelse, feature‑typer, latenst krav, behov for fortolkelighed og omkostninger ved fejl. En enklere model kan overgå en større model, når data er begrænsede, eller driftsmæssige begrænsninger favoriserer hastighed og gennemsigtighed.
Hvor maskinlæring anvendes
ML understøtter søgerangering, anbefalinger, prognoser, anomalidetektion, oversættelse, talegenkendelse, computer vision, forudsigende vedligeholdelse, svindeldetektion og videnskabelig analyse. De samme teknikker kan også forstærke historisk bias, afsløre følsomme oplysninger eller opføre sig uforudsigeligt under fordelingsskift. Ansvarlig implementering kræver dokumentation, menneskelig tilsyn hvor det er relevant, sikkerhedstest og løbende overvågning.
Fra problemdefinition til et gyldigt maskinlærings‑eksperiment
Et maskinlæringsprojekt bør starte med en beslutning og et målbare resultat, ikke en algoritme. Definér forudsigelses‑enheden, målet, observations‑tiden, beslutnings‑tiden, tilgængelige features og omkostningen ved hver fejl. For en churn‑model, for eksempel, ville brug af hændelser registreret efter annullering lække svaret. Etablér en simpel regel eller statistisk baseline, og del derefter data efter tid, kunde, lokation eller en anden grænse, der afspejler implementeringen. Tilfældige række‑opdelinger kan placere næsten identiske observationer i trænings‑ og testsæt og give en misvisende score.
Feature engineering konverterer rå poster til repræsentationer, som modellen kan bruge, men hver feature kræver oprindelse og en tilgængelighedsgaranti. Tilpas normalisering, ordforråd, imputering og dimensionsreduktion kun på træningsdata, og anvend derefter den indlærte transformation på validerings‑ og testdata. Kryds‑validering estimerer variation på tværs af prøver; et endeligt ubehandlet testsæt understøtter frigivelsesbeslutningen. Vælg metrikker ud fra konsekvenser: præcision og recall for ulige klassifikationsfejl, kalibrering når sandsynligheder driver handling, og omkostnings‑ eller nytte‑vægtede målinger når fejl har forskellige driftsmæssige virkninger.
Implementering, overvågning og ansvarlig drift
Produktions‑inference gentager den komplette træningstidstransformation og returnerer en forudsigelse under latenst, gennemløb og tilgængelighedskrav. Pak forbehandling med modellen, valider input‑skemaer, versionér artefakter og sammenlign resultater mellem offline‑ og serving‑implementeringer. Vælg en tærskel ud fra driftskapacitet og fejl‑afvejning i stedet for at standardisere til 0.5. Rul ud gennem shadow‑evaluering, en begrænset kohorte eller et eksperiment med sikkerheds‑metrikker. Bevar en deterministisk fallback og en rollback‑sti for afhængigheds‑fejl eller uacceptabel adfærd.
Overvåg input‑kvalitet, feature‑drift, forudsigelses‑fordeling, kalibrering, undergruppe‑resultater, latenst, omkostninger og bekræftede labels, når de endelig ankommer. Drift er et signal til at undersøge, ikke et automatisk bevis på, at gen‑træning vil hjælpe. Gen‑træning kræver gennemgåede data, gentagelige tests, godkendelse og sammenligning med den nuværende champion. Dokumentér tilsigtet og ugyldig brug, data‑rettigheder, privatliv, sikkerhed, menneskelig overstyring og appel, hvor personer påvirkes. Maskinlæring er et vedligeholdt beslutningssystem; model‑filen er kun en udskiftelig komponent.
Eksempel: forudsigelse af udstyrsfejl
En producent definerer én forudsigelse pr. maskin‑dag: om en verificeret fejl vil indtræffe inden for syv dage ved kun at bruge telemetri tilgængelig ved starten af dagen. Den opdeler efter maskine og tid, sammenligner med alders‑ og tærskel‑baserede regler, tilpasser forbehandling på træningsdata og evaluerer hændelses‑recall, falske alarmer, advarsels‑lead‑tid, kalibrering og vedligeholdelses‑kapacitet. Sensor‑udskiftning og planlagte nedlukninger modelleres som driftskontekst snarere end som almindelige observationer.
Modellen kører først i shadow‑tilstand. Alarmer viser bidragende telemetri og usikkerhed, men vedligeholdere beslutter, om de skal inspicere. Fund og bekræftede årsager bliver styrende labels; fraværet af en arbejdsordre antages ikke at betyde ingen fejl. En trinvis udrulning bruger alarm‑grænser og en manuel fallback, mens overvågning sporer sensor‑sundhed, input‑drift, gennemgået præcision, nedetid og unødvendig vedligeholdelse. Gen‑træning sker kun efter at data‑ og tærskel‑gennemgang viser en sandsynlig forbedring i forhold til det nuværende implementerede system.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, randbetingelser, fejl‑ eller manglende input, fordeling‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenst, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for frigivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart punkt, hvor det skal deaktiveres eller udskiftes.
Primære referencer












