Grundlæggende AI
Hvad er dimensionsreduktion?

 Føj Unite.AI til dine foretrukne kilder på Google
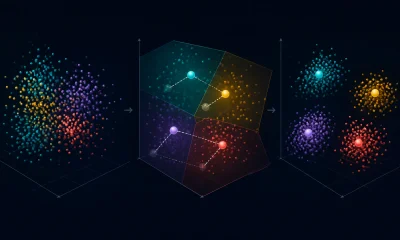
Dimensionsreduktion repræsenterer data med færre variable, samtidig med at den bevarer information, der er nyttig for en opgave. Den kan reducere lagerplads og støj, forbedre visualisering, mindske redundante funktioner og gøre efterfølgende modeller lettere at træne.
Ingen metode bevarer alle relationer. En nyttig reduktion begynder med at angive, hvad der skal bevares: varians, klasseseparation, lokale naboskaber, global geometri, rekonstruktionskvalitet eller fortolkelighed.
Vigtige pointer
- Feature selection bevarer de oprindelige variable; feature extraction skaber nye lavdimensionelle koordinater.
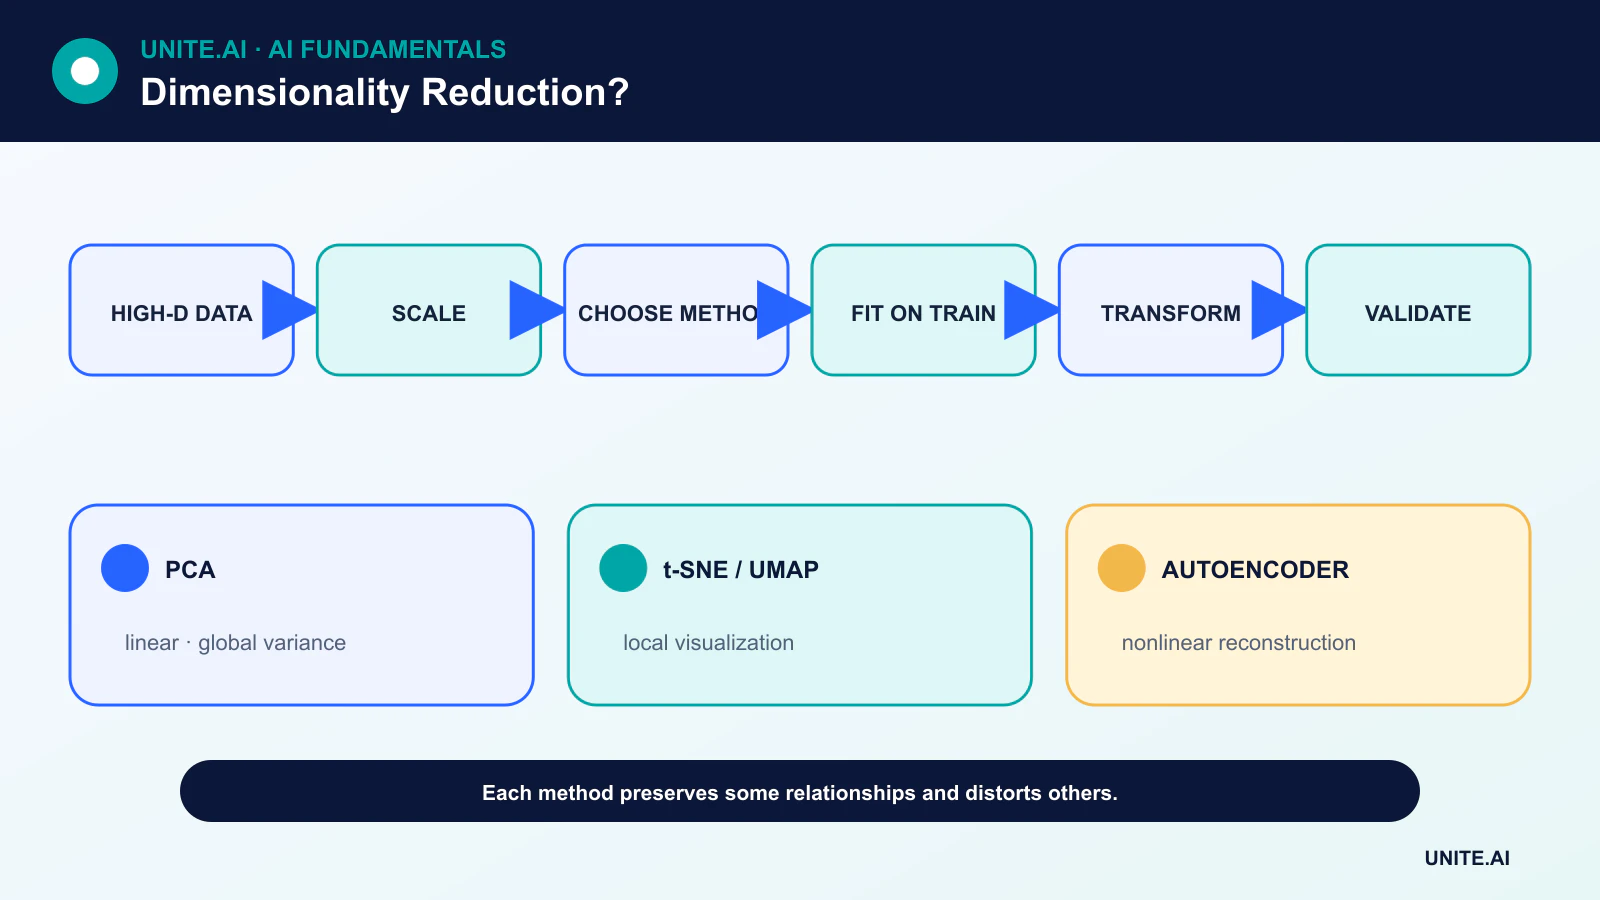
- PCA er lineær og variansorienteret; t‑SNE og UMAP fremhæver nabostruktur for visualisering.
- Visualiserings‑indlejringer kan forvride afstande, klyngestørrelser og global separation.
- Træn reduktionen kun på træningsdata, og anvend derefter den lærte transformation på validerings‑ og testdata.
Feature selection versus projektion
Feature selection fjerner variable ved hjælp af domæneregler, manglende værdier, redundans, forudsigelsestests eller regularisering. Den bevarer de oprindelige betydninger, hvilket kan hjælpe styring og forklaring.
Projektionsteknikker kombinerer variable til nye koordinater. De kan indfange distribueret struktur, men kan gøre hver koordinat sværere at fortolke. En autoencoder lærer en ikke‑lineær projektion gennem rekonstruktion.
PCA og SVD
Principal component analysis identificerer ortogonale retninger med faldende varians efter centrering af dataene. Singular value decomposition giver en almindelig numerisk metode. Skalering er vigtigt: en måleenhed med høj varians kan dominere komponenterne.
PCA er deterministisk op til fortegn og gentagne egenværdier, understøtter out‑of‑sample‑transformation og giver forklarende varians‑opsummeringer. Høj varians er ikke altid opgave‑relevant, og lineære komponenter kan ikke udfolde enhver krum manifold.
t‑SNE og UMAP
t‑SNE konstruerer sandsynlighedsfordelinger over naboer og optimerer et lavdimensionelt kort, der fremhæver lokal lighed. UMAP bygger en vægtet nabograf og optimerer en lavdimensionel repræsentation med relaterede mål for lokal struktur.
Begge er kraftfulde udforskende værktøjer, men er følsomme over for forbehandling, afstandsmetrik og hyperparametre. Tomt rum, klyngeområde og afstand mellem klynger i et 2D‑plot bør ikke automatisk tillægges en virkelighedsfortolkning.
Supervised metoder og opgavebevidste repræsentationer
Lineær diskriminantanalyse bruger klasselabels til at søge separation, hvilket gør den forskellig fra den usupervised PCA. Neurale repræsentationslæringer kan optimere forudsigelse eller kontrastive mål i stedet for rekonstruktion.
Hvis label‑erne styrer reduktionen, skal al tilpasning og tuning forblive inden for træningsprocessen. Ellers kan information fra test‑sættet lække ind i modeludvælgelsen og skabe et optimistisk resultat.
Valg og validering af en metode
Start med forbehandling og en simpel baseline. For kompression, mål rekonstruktion eller efterfølgende præstation på tværs af dimensioner. For visualisering, test stabilitet på tværs af frø og hyperparametre og sammenlign nabopreservation med domæneviden.
For produktion, spørg om metoden kan transformere nye poster, hvordan den håndterer manglende værdier, om den ændrer sig ved gen‑træning, og om brugerne har brug for forklaringer på de oprindelige funktioner. Overfitting kan forekomme i reduktions‑trinnet ligesom i den endelige model.
Lineære og ikke‑lineære reduktionsmetoder
Dimensionsreduktion kortlægger højdimensionelle data til færre koordinater, samtidig med at udvalgt struktur bevares. Principal component analysis finder ortogonale retninger med maksimal varians efter centrering; skalering er nødvendig, når enheder skal bidrage på tilsvarende måde. Singular value decomposition beregner relateret lav‑rang struktur og understøtter sparsomme matricer. Lineær diskriminantanalyse bruger label‑erne til at finde klasseseparerende retninger. Disse metoder giver eksplicitte transformationer, men varians eller klasseseparation bevarer måske ikke den information, der kræves for en efterfølgende opgave.
Manifold‑metoder såsom t‑SNE og UMAP konstruerer naboskaber og optimerer et lavdimensionelt layout. De er kraftfulde til udforskning, men forvrænger global afstand, tæthed, klynge‑størrelse og undertiden separation. Resultater afhænger af forbehandling, metrik, naboer eller perplexitet, initialisering og frø. En tiltalende klynge i to dimensioner kan opstå selv uden diskrete grupper. Brug flere indstillinger, farv kun efter metadata, der ikke er brugt i tilpasning, og valider den tilsyneladende struktur i det oprindelige rum eller med uafhængige label‑er.
Feature selection, indlejringer og evaluering
Feature selection bevarer de oprindelige variable gennem filtre, wrappers eller model‑baseret vigtighed; repræsentationslæring skaber nye latente funktioner ved brug af autoencodere eller supervised modeller. Random projections bevarer afstande omtrentligt under visse betingelser og giver effektive baselines. Vælg metode baseret på kompression, visualisering, støjreduktion, hastighed, lagerplads eller modelpræstation. Træn reduceren kun på træningsdata, og transformér derefter validerings‑ og test‑sæt. Supervised reduktion skal indlejres i kryds‑validering for at undgå label‑lækage.
Evaluer forklarende varians eller rekonstruktion for lineær kompression, pålidelighed og nabopreservation for visualisering, samt efterfølgende nøjagtighed, kalibrering, latenstid og robusthed for forudsigelse. Mål stabilitet på tværs af prøver og frø. Undersøg om sjældne klasser eller følsomme grupper er sammenklappet, og om invers mapping er mulig. Reducerede koordinater kan stadig indeholde private oplysninger; et todimensionelt plot er ikke anonymisering. Dokumentér transformationen, skaleringen, feature‑rækkefølgen og begrænsningerne.
Produktionsbrug
Betjening kræver den præcise tilpassede transformation og input‑skema. Overvåg manglende funktioner, række‑skift, komponent‑score‑fordeling, rekonstruktionsfejl og efterfølgende resultater. Hvis nye kategorier eller sensorer dukker op, så gen‑træn og versionér hele pipeline’en i stedet for stiltiende at tilføje kolonner. Reduktion kan forbedre beregning og fjerne støj fra en model, men kan også kassere svage signaler, der er vigtige for sjældne hændelser. Betragt det som et lært målesteg, hvis beholdte og tabte information skal testes mod beslutningen.
Arbejdseksempel: reduktion af kunde‑adfærd‑funktioner
En analytiker standardiserer 200 adfærdsmålinger og tilpasser PCA kun på træningskunder. Kryds‑validering vælger antallet af komponenter ud fra efterfølgende churn‑præstation og stabilitet, ikke et todimensionelt scatter‑plot. Loadings inspiceres for dominerende kilder og manglende værdier. PCA, feature selection, random projection og en u‑reduceret regulariseret model sammenlignes på kalibrering, latenstid og resultater for sjældne kundesegmenter. Gentagne prøver tester også, om de førende komponenter og efterfølgende konklusioner forbliver stabile.
Den implementerede pipeline fastsætter feature‑rækkefølgen, skalereren og komponenterne og afviser manglende skema‑versioner. Overvågning sporer komponentfordelinger, rekonstruktionsfejl og efterfølgende resultater. En visualisering med tilsyneladende klynger bruges til at generere spørgsmål, ikke til at tildele kunde‑personas. Da latente komponenter stadig koder adfærd, forbliver adgang og fastholdelse kontrolleret. Hvis kilde‑definitionerne ændres, genopbygges og valideres den fulde transformation og model i stedet for at projicere inkompatible data ind i gamle komponenter.
Implementeringsbeviser og driftsberedskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt inden justering. Test almindelige tilfælde, grænsetilstande, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå virkelige beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret gendannelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller erstattes.
Ofte stillede spørgsmål
Forbedrer dimensionsreduktion altid en model?
Nej. Den kan kassere forudsigelsesinformation eller komplicere fortolkning. Sammenlign med en baseline uden reduktion på hold‑out‑data.
Beviser adskilte t‑SNE‑klynger, at reelle klasser findes?
Nej. Kortet er en optimeret visualisering af naborelationer og kan skabe tilsyneladende separation. Valider klynger med uafhængige beviser.
Primære referencer