Grundlæggende AI
Hvad er Few-Shot Learning?

 Føj Unite.AI til dine foretrukne kilder på Google
Few-shot learning undersøger, hvordan en model kan tilpasse sig en ny opgave eller klasse ud fra kun et lille antal mærkede eksempler. I klassiske benchmarks leverer et episode et support‑sæt — f.eks. fem klasser med én eller fem eksempler pr. klasse — og beder modellen klassificere usete forespørgsler.
Udtrykket bruges også om in‑context learning, hvor en forudtrænet sprogmodel får nogle få demonstrationer i sin prompt uden at opdatere parametre. Disse opsætninger deler målet om få eksempler, men anvender forskellige tilpasningsmekanismer og kræver forskellige evalueringsdesign.
Vigtige pointer
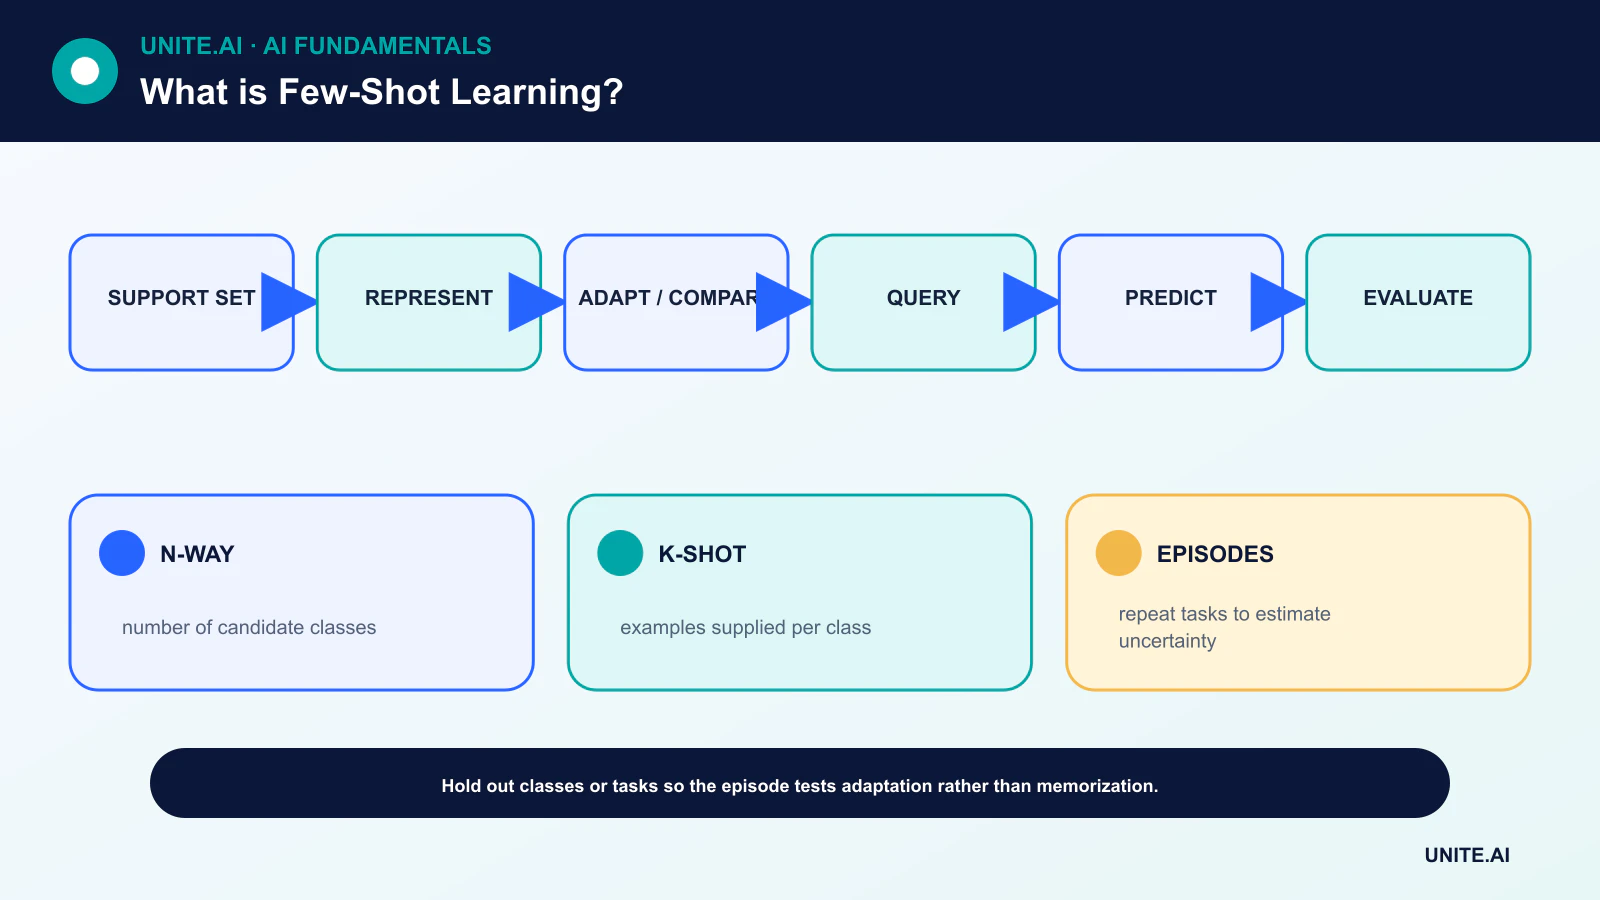
- N‑way K‑shot beskriver N klasser og K mærkede support‑eksempler pr. klasse.
- Metric‑learning‑metoder sammenligner forespørgsler med indlærte repræsentationer af support‑eksempler.
- Meta‑learning optimerer på tværs af mange opgaver, så en ny opgave kan læres hurtigt.
- Få eksempler forstørrer mærkningsfejl, lækage, klasse‑uklarhed og usikkerhed, så baselines og rapportering af tillid er vigtige.
Episoder, support‑sæt og forespørgsels‑sæt
Et few‑shot‑episode adskiller et lille mærket support‑sæt fra et forespørgsels‑sæt, der bruges til evaluering. Under meta‑træning ser modellen mange sådanne episoder. En solid evaluering holder hele klasser, opgaver eller domæner ude, så test‑episoden måler tilpasning frem for memorering.
Rapporter nøjagtighedsfordelinger over mange episoder i stedet for én enkelt prøve. Sammenlign med simple nearest‑neighbor‑ og lineære baselines; en sofistikeret metode, der ikke kan overgå en veltrænet repræsentation plus en basal klassifikator, kan have svært ved at retfærdiggøre sin kompleksitet.
Metric‑learning og prototyper
Matching‑netværk og beslægtede metoder indlejrer support‑ og forespørgselseksempler i et rum, hvor nærliggende vektorer bør dele samme mærke. Prototypiske netværk gennemsnitliggør support‑indlejringerne for hver klasse og klassificerer en forespørgsel ud fra afstanden til disse klasse‑prototyper.
Dette forbinder few‑shot‑learning med repræsentationskvalitet. En forudtrænet deep‑learning-model kan allerede organisere relevante funktioner godt, mens en mismatchede repræsentation kan gøre hver afstand vildledende.
Optimeringsbaseret meta‑learning
Model‑Agnostic Meta‑Learning søger efter parametre, der kan tilpasse sig med et lille antal gradient‑trin. Andre metoder lærer en optimizer, en initialisering eller en regel for parameteropdatering. Den ydre løkke evaluerer ydeevnen efter tilpasning på tværs af opgaver.
Meta‑learning antager, at nyttig struktur deles mellem trænings‑ og mål‑opgaver. Når mål‑fordelingen afviger kraftigt, kan hurtig tilpasning fejle. Validering bør variere antal shots, klasser, domæner og opgave‑sværhedsgrad i stedet for at betragte én benchmark som universel.
Transfer learning og datastrategier
Transfer learning er ofte det stærkeste praktiske udgangspunkt: frys en forudtrænet encoder, træn et lille hoved, og finjuster derefter selektivt, hvis der findes nok data. Data‑augmentation kan introducere invarians, men urealistiske syntetiske eksempler kan forstærke bias eller skabe genveje.
Active learning kan prioritere, hvilke eksempler der skal mærkes, mens semi‑supervised learning kan bruge yderligere umærkede data. Disse er komplementære strategier, ikke synonymer for few‑shot‑learning.
Few‑shot‑prompting er anderledes
En transformer kan udlede et mønster ud fra demonstrationer placeret i dens kontekst. Ingen vedvarende parameteropdatering er påkrævet. Orden, formulering og mærkebalance kan væsentligt ændre output, og eksempler kan optage en stor del af kontekst‑vinduet.
Brug et repræsentativt evalueringssæt, versionér hver prompt og demonstration, og test zero‑shot, few‑shot og finjusterede alternativer. Et lille support‑sæt understøtter ikke stærke påstande på befolkningsniveau, især ikke for sjældne eller sikkerhedskritiske tilfælde.
Few‑shot‑learning‑paradigmer og opgavekonstruktion
Few‑shot‑learning har til formål at udføre en opgave ud fra meget få mærkede eksempler. I metric‑baserede metoder kortlægger en encoder eksempler til et rum, hvor nærmeste prototyper eller naboer repræsenterer klasser. Optimeringsbaseret meta‑learning træner en initialisering eller opdateringsregel for hurtig tilpasning. Transfer learning finjusterer en forudtrænet model på et lille mål‑sæt. In‑context learning leverer eksempler i en prompt uden at opdatere vægte. Disse mekanismer adskiller sig, så påstande bør specificere, om parametre ændres, hvilken forudgående træning der fandt sted, og hvordan eksempler vælges.
Evaluering bør adskille trænings‑ og testklasser, opgaver, emner eller domæner i overensstemmelse med den påståede generalisering. Et N‑way K‑shot‑episode indeholder N klasser og K support‑eksempler pr. klasse samt forespørgselseksempler til scoring. Gentagne episoder estimerer varians fra support‑udvælgelse. For prompting kan eksempels rækkefølge, mærkeformulering, format og demonstrations‑lignendehed væsentligt påvirke resultaterne. Sammenlign med zero‑shot, nearest‑neighbor, linear‑probe og almindelige finjusterings‑baselines ved brug af samme repræsentation og databudget.
Datakvalitet, usikkerhed og negativ transfer
Med få eksempler har fejlagtigt mærkede eller atypiske tilfælde en uforholdsmæssig stor indflydelse. Definér annoteringsregler, inspicér hvert support‑element, og bevar et ukendt eller afholdende udfald. Data‑augmentation og syntetiske eksempler kan kun hjælpe, når de bevarer opgaven og tilføjer realistisk variation. En forudtrænet model kan overføre genveje eller bias fra sin kilde‑domæne. Test out‑of‑domain‑tilfælde, sjældne grupper og følsomhed over for fjernelse af ét support‑eksempel. Rapporter konfidensintervaller på tværs af opgaver og tilfældige frø, ikke én favorabel prompt.
Active learning kan anmode om mærkninger på informative tilfælde, mens semi‑supervised metoder bruger umærkede data under yderligere antagelser. Retrieval kan dynamisk vælge relevante demonstrationer, men skal undgå lækage af test‑mærkninger. Tilpasning kan overfit hurtigt, så begræns opdateringer, brug regularisering, og valider på separate eksempler. For højt‑risikopgaver retfærdiggør få mærkninger sjældent autonome beslutninger; brug modellen til at prioritere eller assistere gennemgang, indtil tilstrækkelig bevis for udfald foreligger.
Produktionsdrift
Versionér den grundlæggende model, indlejrings‑ eller prompt‑skabelon, demonstrationer, mærkeschema og tilpasningsparametre. Beskyt eksempler, da prompts eller gradienter kan afsløre følsomme poster. Overvåg ydeevne, efterhånden som klasser og sprog ændrer sig, og opdater support‑eksempler gennem styreret gennemgang i stedet for automatisk selv‑mærkning. Few‑shot‑learning reducerer kravet på mærkede mål ved at udnytte tidligere struktur; det eliminerer ikke behovet for repræsentativ evaluering, omhyggelig opgave‑definition, domæneekspertise eller en sikker fallback, når den nye opgave ligger uden for den forudgående viden.
Praktisk eksempel: few‑shot‑klassificering for et nyt produkt
Et supportteam har brug for routing‑mærkater til et produkt med kun fem gennemgåede eksempler pr. problem. Det sammenligner nærmeste prototyper i en forudtrænet indlejring, et lineært hoved, parameter‑effektiv finjustering og in‑context prompting. Produktfamilier, kunder og senere beskeder holdes uden for meta‑træning og modeludvælgelse. Gentagen support‑sæt‑sampling rapporterer klasserecall, kalibrering, varians og følsomhed over for én fejlagtigt mærket demonstration.
Med lav tillid og uden support sendes beskeder til generel support, og gennemgangere korrigerer mærkater via en styreret kø. Eksempler er anonymiserede, versionerede og vælges aldrig fra det endelige test‑sæt. Overvågning sporer nyt ordforråd, klassesatser, korrektioner og uenighed. Når der er samlet nok mærkater, sammenlignes few‑shot‑systemet med almindelig superviseret træning. Hurtig opsætning er nyttig, men retfærdiggør ikke automatisering, hvis ydeevnen forbliver ustabil, eller hvis det nye produkt afviger væsentligt fra tidligere opgave‑familier.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver væsentlig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlbehæftede eller manglende input, fordeling‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er one‑shot learning det samme som few‑shot learning?
One‑shot learning er den særlige case med ét mærket support‑eksempel pr. klasse eller opgave. Zero‑shot learning bruger ingen mærkede mål‑eksempler.
Eliminerer few‑shot learning behovet for data?
Nej. Det flytter afhængigheden mod forudtræningsdata, relaterede opgaver, repræsentationer og antagelser. Mål‑mærkaterne er få; den samlede læringshistorik er som regel stor.
Primære referencer