Grundlæggende AI
Hvad er Transfer Learning?

 Føj Unite.AI til dine foretrukne kilder på Google
Transfer learning genbruger viden, der er lært for et problem, til at forbedre læringen på et relateret problem. I stedet for at initialisere hver parameter tilfældigt, starter en praktikere fra en foruddannet model eller repræsentation og tilpasser den til en målopgave.
Denne tilgang er især nyttig, når mål‑datasættet er lille, mærkning er dyr, eller forudtræning kræver mere beregning, end målteamet kan retfærdiggøre. At træne en model fra bunden er alternativet til transfer learning – ikke en type af transfer learning.
Vigtige pointer
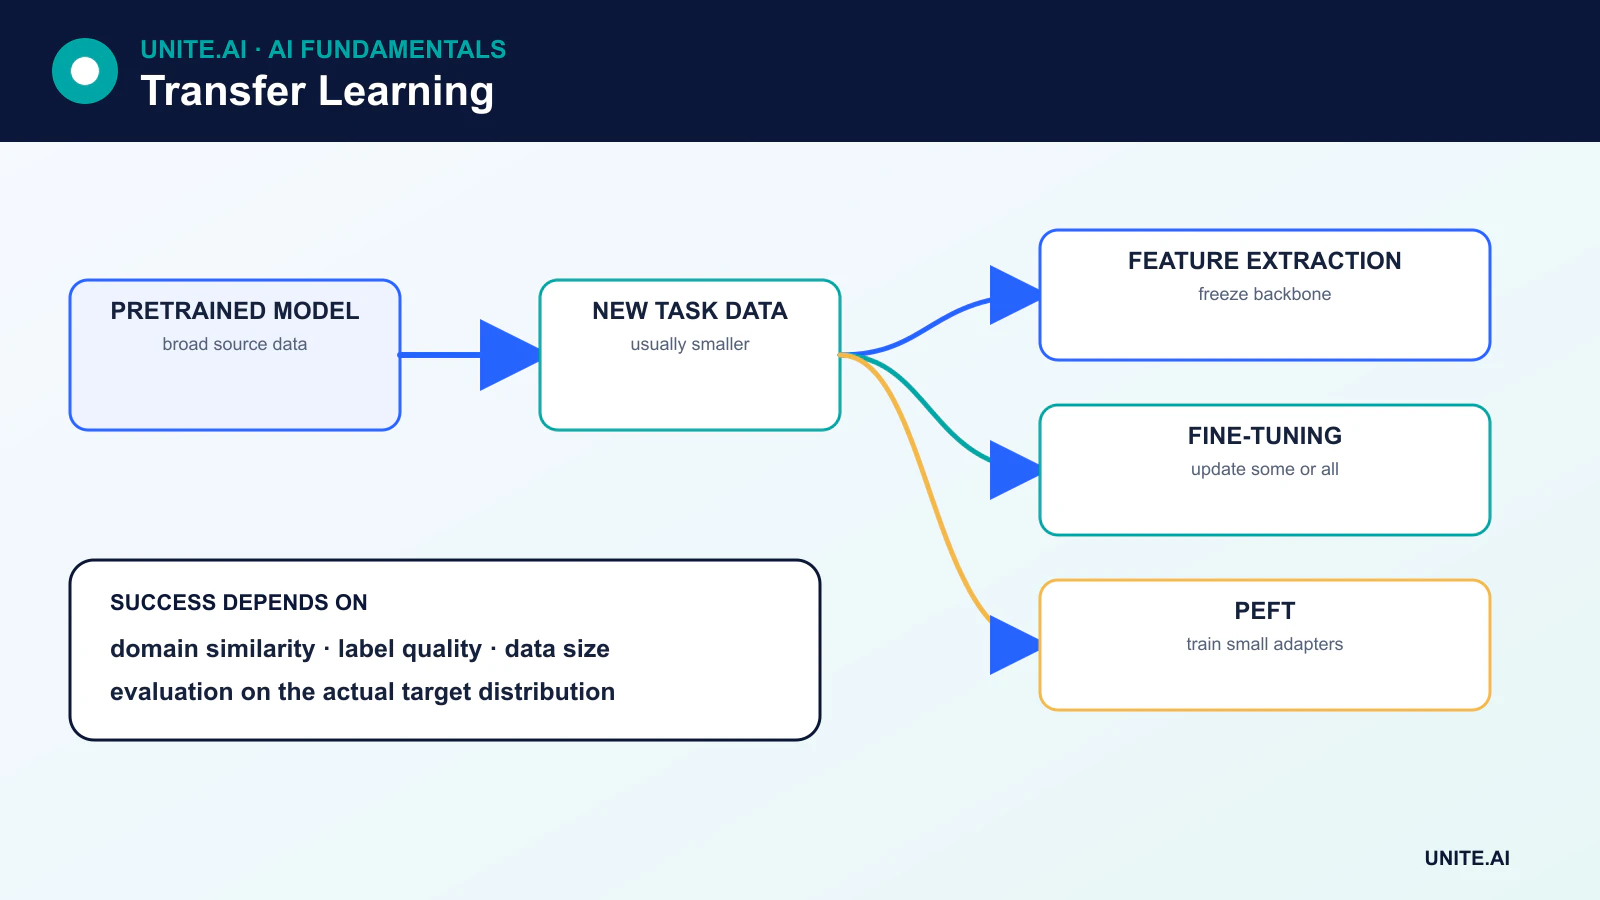
- Feature extraction holder en foruddannet base frosset og træner et nyt opgave‑specifikt hoved.
- Fine-tuning opdaterer nogle eller alle foruddannede parametre ved hjælp af mål‑domænedata.
- Parameter‑effektive metoder såsom adapters og LoRA opdaterer en lille del af modellen.
- Transfer kan fejle, når kilde‑ og mål‑domæner adskiller sig, licenser konflikterer, eller kilde‑modellen bærer upassende bias.
Hvorfor transfer learning virker
Modeller lærer ofte repræsentationer, der er nyttige ud over de præcise data, de er trænet på. Tidlige lag i en billedmodel kan fange genanvendelige lokale mønstre; en sprogmodel kan lære syntaks, semantik og brede associationer fra selv‑overvåget forudsigelse. En mål‑opgave kan bygge på disse repræsentationer i stedet for at genlære alt fra begrænsede eksempler.
Fordelen afhænger af ligheden mellem kilde‑ og mål‑opgaver, skalaen og kvaliteten af forudtræning, samt hvordan modellen tilpasses. Genbrug er ikke garanteret: overførte funktioner kan være irrelevante eller aktivt skadelige.
Feature extraction
Ved feature extraction fryses den foruddannede base, så dens parametre ikke ændres. Dens output bliver input til en ny klassifikator, regressormodel eller andet opgave‑specifikt hoved. Kun det nye hoved trænes.
Dette er hurtigt og data‑effektivt, og det mindsker risikoen for at ødelægge nyttige foruddannede repræsentationer. Det kan også under‑fitte, når mål‑domænet afviger væsentligt fra forudtræningen. Lag som batch‑normalisering kræver særlig opmærksomhed, fordi deres gemte statistik og træningsadfærd kan påvirke tilpasningen, selv når de fleste vægte er frosset.
Fine-tuning
Fine-tuning opdaterer foruddannede parametre på mål‑data. En almindelig arbejdsgang er:
- Indlæs den foruddannede model og erstat eller tilføj output‑hovedet.
- Frys basen og træn det nye hoved.
- Optø udvalgte lag – eller hele modellen – og fortsæt med en lavere læringsrate.
- Valider for over‑fitting, glemsel og mål‑domæne‑præstation.
Der findes ingen universel regel om, at kun de sidste lag skal finjusteres. Det bedste valg afhænger af arkitektur, mål‑datasætstørrelse, domænelighed, normaliseringslag, hukommelse og beregningsressourcer. Full fine-tuning kan give mere kapacitet, men kræver flere ressourcer og kan forårsage katastrofal glemsel.
Parameter‑effektiv fine-tuning
Store transformers gør full fine-tuning dyrt. Parameter‑effektiv fine-tuning (PEFT) modificerer eller tilføjer et lille sæt parametre, mens størstedelen af basismodellen forbliver frosset.
- Adapters indsætter små trænbare moduler i netværket.
- LoRA repræsenterer vægt‑opdateringer med lav‑rang‑matricer, hvilket reducerer trænbare parametre og optimerings‑hukommelse.
- Prompt‑ og prefix‑tuning lærer kontinuerlige opgave‑specifikke input eller interne præfikser.
PEFT kan gemme mange opgave‑tilpasninger omkring én base‑model, selvom inferens‑serving, adapter‑kompatibilitet og håndtering af fusionerede vægte stadig kræver omhyggelig engineering.
Transfer learning på tværs af datatyper
Billedklassifikatorer starter ofte fra modeller, der er foruddannet på store billeddatasæt. Sprog‑systemer starter fra en grundmodel og tilpasses gennem superviseret fine-tuning, præference‑optimering, genfinding eller værktøjs‑brug. Tale-, lyd‑, protein‑ og multimodale modeller følger lignende mønstre.
Transfer kan også forekomme uden at ændre den oprindelige model. En frossen model kan producere indlejringer til en efterfølgende klassifikator, et vector similarity search-system eller en genfindings‑pipeline.
Domain shift og negativ transfer
Domain shift opstår, når mål‑input adskiller sig fra kilde‑data. En medicinsk billedmodel kan for eksempel møde udstyr, populationer eller indfangnings‑protokoller, der ikke var til stede under forudtræning. Negativ transfer betyder, at genbrug gør mål‑præstationen dårligere end en passende fra‑bunden‑baseline.
Teams bør sammenligne tilpasningsstrategier, evaluere meningsfulde undergrupper og holde et mål‑domæne‑test‑sæt. Hvis kilde‑opgaven er dårligt matchet, kan en mindre domænespecifik model overgå en større generel model.
Licenser, oprindelse og sikkerhed
En download‑bar model er ikke automatisk sikker at implementere. Gennemgå licens, tilladte anvendelser, afsløringer af trænings‑data, model‑card‑begrænsninger og afhængighedskæde. Modeller kan reproducere bias, memorere følsomme data eller indeholde ondsindet serialiseret kode. Brug betroede formater, scan artefakter, og indlæs ubetroede vægte i et isoleret miljø.
Hvornår man skal bruge transfer learning
Transfer learning er et stærkt standardvalg, når en relevant foruddannet model findes, og mål‑data er begrænsede. Træning fra bunden kan være foretrukket, når domænet er stærkt specialiseret, licenser er uforenelige, modelstørrelsen overstiger deployments‑grænser, eller en simpel opgave ikke drager fordel af en stor foruddannet repræsentation. Beslutningen bør valideres empirisk frem for at antages ud fra model‑skala.
Hvad der overføres, og hvordan man tilpasser det
Transfer learning genbruger repræsentationer, der er lært på en kilde‑opgave eller datasæt, til en mål‑opgave. I vision fanger tidlige funktioner ofte kanter og teksturer; i sprog kodificerer foruddannede modeller statistiske mønstre på tværs af tokens og kontekster. Transfer virker, når kilde‑repræsentationerne indeholder information, der er relevant for målet, men domæne‑, label‑, modalitets‑ og indfangnings‑forskelle kan producere negativ transfer. Start med en foruddannet baseline, inspicer dens træningslicens og dokumentation, og sammenlign med at træne en lille mål‑specifik model fra bunden.
Feature extraction fryser rygsøjlen og træner et nyt hoved; delvis fine-tuning optøer udvalgte lag; fuld fine-tuning opdaterer hele modellen. Parameter‑effektive metoder tilføjer adapters eller lav‑rang‑opdateringer, hvilket reducerer trænbare parametre men ikke nødvendigvis inferens‑hukommelse. Brug en lavere læringsrate for foruddannede vægte, bevar normaliserings‑adfærd, og undgå katastrofal glemsel med tidsplaner, regularisering, genpraksis eller begrænsede opdateringer hvor nødvendigt. Vælg checkpoints på mål‑valideringsdata og test flere frø, da små mål‑datasæt giver høj varians.
Data, evaluering og deployments‑afvejninger
Mål‑data bør afspejle deployments‑forhold og vigtige undergrupper, ikke blot være et praktisk mærket udsnit. Del efter emne, kilde, tid eller lokation for at forhindre relaterede eksempler i at krydse partitioner. Test både i‑domæne og i skiftende betingelser. Sammenlign frosne, delvist tune‑de og fuldt tune‑de varianter på kvalitet, kalibrering, træningsomkostning, latenstid og robusthed. En forbedring i gennemsnitlig score kan skjule tab på sjældne klasser, som stammer fra kilde‑bias. Gennemgå fejle‑eksempler for kilde‑specifikke genveje, ordforråds‑huller eller sensors‑forskelle.
Spore basis‑model, vægte, tokenizer eller forbehandling, adapter, data og licens som én afhængighedsgraf. Hosted basis‑modeller kan ændre adfærd; åbne vægte kan introducere forsyningskæde‑ og patch‑ansvar. Valider det fusionerede eller eksporterede artefakt og scan model‑filer fra ubetroede kilder. I produktion, monitorer mål‑drift og præstation, og bevar evnen til at rulle både tilpasning og basis‑version tilbage. Transfer reducerer nødvendigt mål‑data; det eliminerer ikke mærkning, evaluering, privatliv eller domæne‑ekspertise.
Eksempel: Tilpasning af en vision‑model til en ny klinik
En klinik tilpasser en foruddannet billed‑encoder til at klassificere billedkvalitet før diagnostisk gennemgang. Den verificerer kilde‑modellens licens og tilsigtede modalitet, indsamler lokale enheder og indfangnings‑betingelser, og deler efter patient. Frosne‑feature, adapter, delvis og fuld fine‑tuning varianter sammenlignes med en lille lokal baseline. Metrikker omfatter klasserecall, kalibrering, undergruppe‑adfærd, beregning og følsomhed over for enhed, sted og sjældne artefakter.
Den tilpassede model kan ikke stille en diagnose og dirigerer lav‑tillids‑ eller ikke‑understøttede billeder til teknikere. Eksport‑validering bekræfter lokal forbehandling og numerisk ækvivalens. Model‑, adapter‑, enheds‑ og datasæt‑versioner linkes i registreringen. Overvågning opdager nye scannere, protokol‑ændringer og output‑drift, mens periodisk gennemgåede prøver estimerer reel præstation. En opgradering af kilde‑modellen betragtes som en ny afhængighed, der kræver validering; transfer learning retfærdiggør ikke automatisk genbrug af gammel evidens.
Implementerings‑beviser og operationel beredskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænse‑betingelser, fejl‑ eller manglende input, distributions‑shift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgave‑kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressource‑omkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér monitorering med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, gennemgå derefter real‑world‑evidens efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Primære referencer