Grundlæggende AI
Hvad er CNN’er (Convolutional Neural Networks)?

 Føj Unite.AI til dine foretrukne kilder på Google
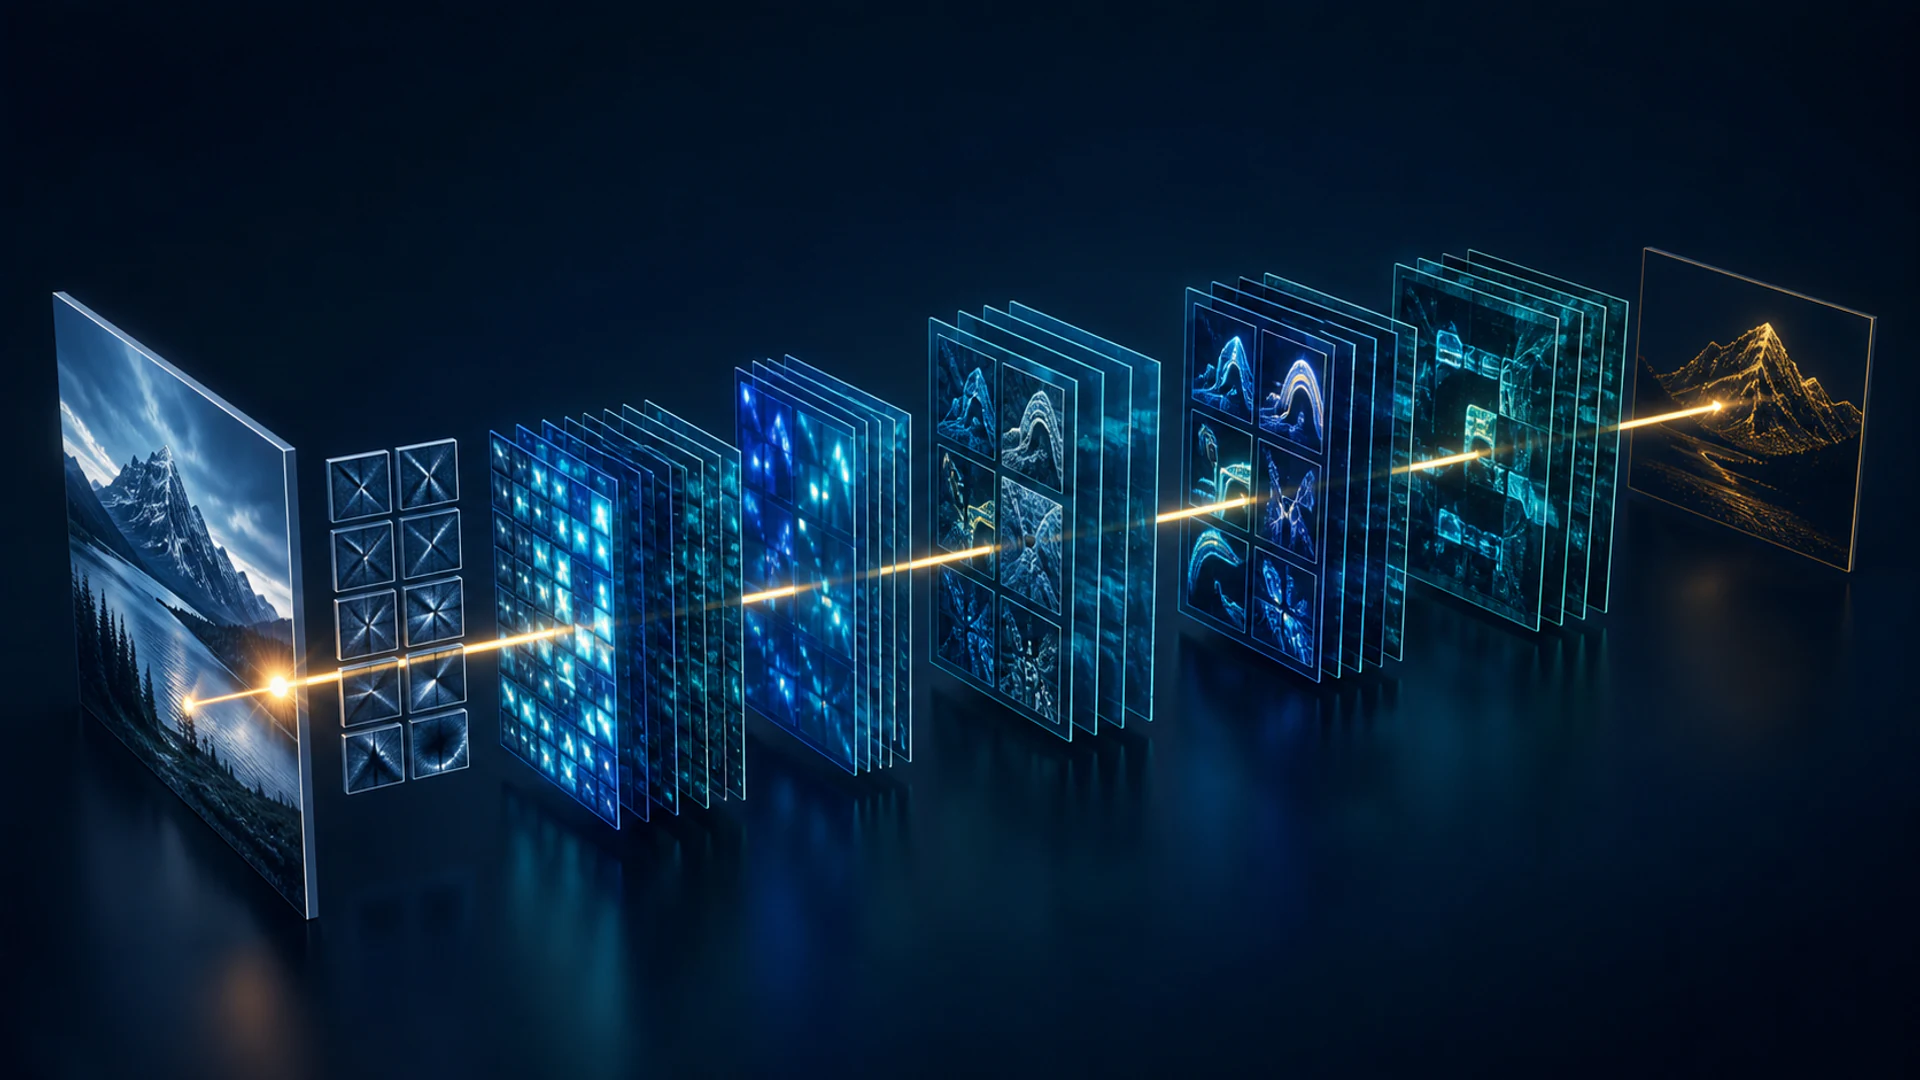
Et konvolutionelt neuralt netværk (CNN) er en neuralnetværksarkitektur, der bruger lærte filtre over lokale regioner af en input. CNN’er blev grundlæggende for moderne computer vision, fordi de kan opdage mønstre uanset hvor mønstrene forekommer og genbruge de samme parametre på tværs af et billede.
Et CNN konverterer ikke et billede fra ikke‑numerisk til numerisk form – billedet ankommer allerede som en tensor af pixelværdier. Formålet er at omdanne den tensor til feature‑kort, der er nyttige til klassificering, detektion, segmentering eller en anden opgave.
Vigtige pointer
- En konvolution kombinerer lokale inputværdier med en lært kerne for at producere et feature‑kort.
- Stride, padding, dilation og pooling styrer den spatiale opløsning og receptive field.
- Vægtdeling gør CNN’er mere parameter‑effektive end et fuldt forbundet netværk over rå pixels.
- Vision transformers tilbyder et alternativ, men CNN’er forbliver stærke for effektive og databegrænsede systemer.
Hvordan konvolution fungerer
En kerne er et lille gitter af trænbare vægte. På hver position multiplicerer CNN kerneværdierne med de tilsvarende inputværdier, summerer resultaterne og tilføjer typisk en bias. Når dette gentages over hele inputtet, produceres et feature‑kort.
For et farvebillede dækker en kerne alle inputkanaler. Et lag bruger flere kerner til at skabe flere outputkanaler. Under træning beregner backpropagation gradienterne for disse kernevægte; konvolutionsoperationen fremstiller ikke et nyt fast sæt vægte fra hvert billede.
Stride, padding og dilation
- Stride styrer, hvor langt kernen bevæger sig. En stride større end én reducerer den spatiale opløsning.
- Padding tilføjer værdier omkring et input, så kantinformation kan behandles, og outputstørrelsen kan kontrolleres.
- Dilation spreder kerneelementerne, udvider receptive field uden at øge antallet af parametre proportionelt.
Receptive field er det område af det oprindelige input, der kan påvirke en enhed. Stabling af konvolutioner udvider det, så senere funktioner kan kombinere information fra bredere områder.
Aktivering, normalisering og pooling
Konvolutionelle lag efterfølges typisk af ikke‑lineære aktiveringer og normalisering. Pooling opsummerer lokale regioner ved hjælp af en operation såsom maksimum eller gennemsnit. Lærte strided‑konvolutioner kan også nedprøve.
Pooling er ikke obligatorisk. Mange moderne netværk bruger global gennemsnits‑pooling nær output i stedet for at flade et stort feature‑kort ud til en fuldt forbundet stak. Dette reducerer antallet af parametre og lader netværket aggregere spatiale beviser.
En moderne CNN‑arkitektur
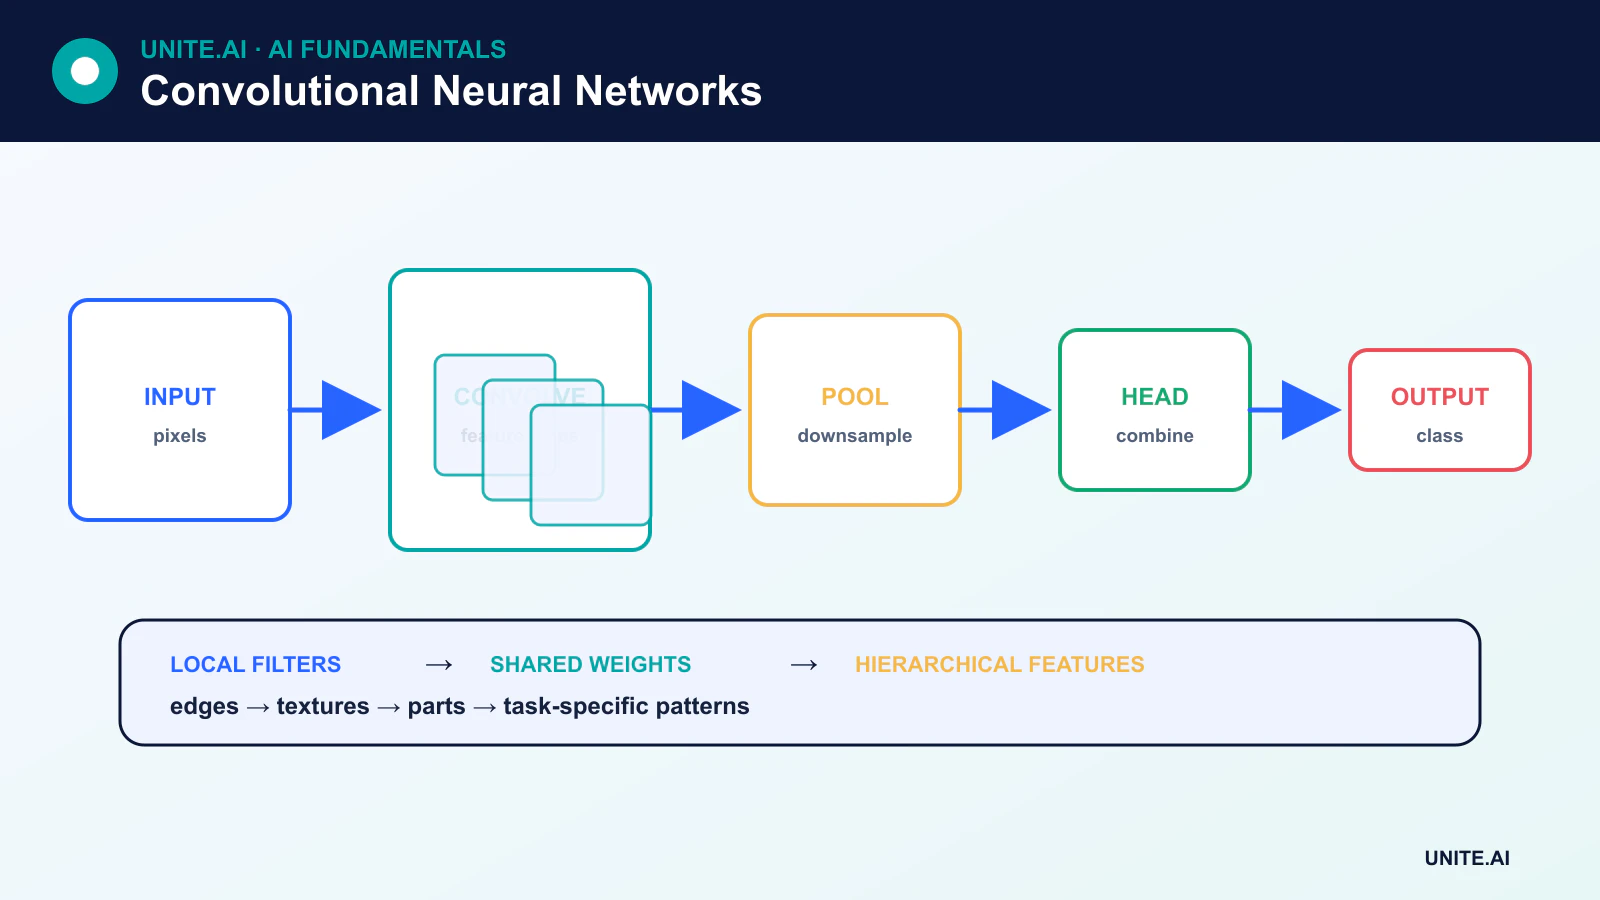
En typisk vision‑model indeholder en stem, en sekvens af feature‑blokke, nedprøjningsstadier og et task‑head. Residual‑forbindelser lader en blok lære en modificering af sit input og giver en direkte vej for information og gradienter. Succesen med residual‑netværk gjorde det praktisk at træne meget dybere CNN’er.
Klassifikations‑heads producerer klassescores. Detektions‑heads forudsiger kategorier og bokse. Segmenteringsarkitekturer tilføjer dekoder‑stier, der genopretter spatial detalje. Den samme CNN‑backbone kan genbruges via transfer learning.
Hvad CNN‑lag lærer
Det er almindeligt at visualisere tidlige filtre, der reagerer på kanter eller teksturer, og senere repræsentationer, der korrelerer med dele eller objekter. Dette er en nyttig intuition, men det er ikke en fast regel. Funktionerne afhænger af opgaven, arkitekturen, data, mål og træningsprocessen, og nogle enheder kombinerer information, der ikke let kan kortlægges til et menneskeligt koncept.
CNN’er versus vision transformers
Vision transformers opdeler billeder i patches og bruger attention til at modellere relationerne mellem dem. De kan skaleres effektivt med store pre‑training datasæt. CNN’er bygger lokalitet og translations‑relaterede antagelser direkte ind i arkitekturen, hvilket kan gøre dem mere effektive og data‑effektive i mindre opsætninger.
Mange praktiske systemer kombinerer konvolution og attention. Den rette arkitektur afhænger af nøjagtighed, latency, hukommelse, træningsdata, hardware og implementering – ikke af hvilken familie der er nyest.
Begrænsninger og praktiske overvejelser
CNN’er kan være følsomme over for distributionsskift, adversarielle forstyrrelser, baggrunds‑shortcuts og biased træningsdata. De er ikke fuldstændig invariante over for position, rotation, skala eller synsvinkel. Augmentation og arkitekturvalg kan forbedre robustheden, men garanterer den ikke.
Ved implementering skal man måle end‑to‑end latency, hukommelse, gennemløb og subgruppeadfærd. Kvantisering og pruning kan reducere omkostninger, især for edge AI, men komprimerede modeller skal revalideres.
Konvolution, receptive fields og moderne CNN‑blokke
Et konvolutionelt lag glider lærte kerner over et gitter og deler vægte på tværs af positioner. Kernel‑størrelse, stride, dilation og padding bestemmer output‑formen og receptive field. Tidlige lag reagerer ofte på lokale kanter eller teksturer; dybere lag kombinerer information over større regioner, selvom lærte repræsentationer ikke nødvendigvis kortlægges tydeligt til menneskelige begreber. Pooling eller strided‑konvolution reducerer den spatiale opløsning. Kanaler bærer feature‑kort, mens grupperet og depthwise‑separerbar konvolution udveksler kryds‑kanalmixning for lavere beregning. Residual‑forbindelser gør meget dybe netværk lettere at optimere.
For en input‑højde og -bredde styrer padding grænsens behandling, og stride styrer sampling. Aggressiv nedprøjning kan slette små objekter; zero‑padding kan skabe kantartefakter; dilation udvider kontekst uden samme parametervækst, men kan forårsage griddning. Batch‑normalisering afhænger af træningsstatistikker, mens alternativer kan fungere bedre ved små batch‑størrelser. Moderne arkitekturer kombinerer bottlenecks, multi‑scale‑funktioner, attention eller inverterede residuals. Vælg arkitektur ud fra opgavens opløsning, hukommelsesbåndbredde, latency og mål‑hardware frem for kun billedklassificerings‑nøjagtighed.
Træning, fortolkning og implementering
Brug augmentationer, der bevarer etiketter og afspejler reel variation, og del efter subjekt eller scene før augmentation. Transfer learning er almindeligt: udskift task‑head, træn den, og frigør derefter forsigtigt backbonen. Evaluer klasse‑specifik ydeevne, kalibrering, robusthed over for sløring, komprimering, belysning, skala, beskæring og adversarielle forstyrrelser. Visualiseringsmetoder såsom feature‑kort og saliency kan afsløre shortcuts, men de er følsomme over for metode og baseline. Bekræft mistænkt afhængighed med kontrafaktiske billeder, occlusion‑tests eller ændringer i datasættet.
Eksporterede CNN’er kan flettes, kvantiseres eller kompileres til GPU, NPU, browser eller mikrokontroller. Valider det implementerede graf, inklusive for‑ og efterbehandling, på de præcise enheder. Mål end‑to‑end latency, hukommelse, energi og termisk adfærd; input‑dekodning kan dominere i en lille model. Overvåg kamera‑ og billedstatistikker, output‑distribution og bekræftede fejl. Signerede model‑artefakter, beskyttede opdateringskanaler og en yndefuld sensorsvigt er en del af produktionsdesignet. CNN’er indkoder en nyttig lokalitetsbias, men de forstår ikke automatisk objekter eller kausale scener.
Eksempel: implementering af et CNN på et inspektionskamera
Et CNN klassificerer overfladefejl fra højopløselige line‑scan‑billeder. Ingeniører fliser billeder med overlap, så små fejl overlever nedprøjning, bevarer koordinater til gennemgang og validerer augmentationer mod reel optisk variation. Et residual‑CNN og en lettere depthwise‑model sammenlignes ved ens recall. Testene inkluderer kant‑defekter, blænding, komprimering, bevægelse, materialebatcher og kameraudskiftninger, med uafhængige produktionspartier reserveret til den endelige evaluering.
Kompilering fletter og kvantiserer modellen til en edge‑accelerator, men den implementerede graf sammenlignes med referencen på følsomme defekt‑sager. Dekodning, flisering, inferens og sammensmeltning af latency måles end‑to‑end. Systemet markerer døde pixels og eksponerings‑drift separat fra produktdefekter. Operatører kan inspicere kilde‑fliser og tilsidesætte resultater. Model‑ og kameraændringer rulles ud gradvist, og linjen bevarer en sikker manuel inspektionsprocedure, når vision‑pipelines er utilgængelige.
Implementeringsbeviser og operationel beredskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latency, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed til udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetry bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overrides og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret gendannelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Skal et CNN altid have pooling?
Nej. Et CNN kan nedprøje med strided‑konvolution og kan bevare opløsning for tæt forudsigelse. Pooling er et designværktøj snarere end et definerende krav.
Er CNN‑filtre hånddesignede?
I et trænet CNN læres kerneværdier normalt fra data. Dette adskiller sig fra klassiske vision‑filtre, hvis koefficienter vælges på forhånd til operationer såsom kantdetektion.
Primære referencer