
Grundlæggende AI
Hvad er neurale netværk?

 Føj Unite.AI til dine foretrukne kilder på Google
Et kunstig neuralt netværk er en parameteriseret matematisk model bestående af lag af forbundne operationer. Under træning justerer netværket sine parametre, så input kortlægges til nyttige output. Neurale netværk kan tilnærme komplekse ikke-lineære sammenhænge og lære repræsentationer direkte fra tekst, billeder, lyd, tidsserier og andre data.
Navnet er historisk inspireret af biologiske neuroner, men moderne netværk er ingeniørsystemer snarere end realistiske simulationer af hjernen. Udtryk som “neuron” og “læring” er praktiske forkortelser og bør ikke forveksles med beviser på menneskelig lignende kognition.
Vigtige pointer
- En neuron beregner en vægtet sum, tilføjer en træningsbar bias og anvender en aktiveringsfunktion.
- Et fremadrettet pass genererer forudsigelser; et tab måler fejl; backpropagation beregner gradienter; en optimizer opdaterer parametre.
- MLP’er, CNN’er, RNN’er og transformere organiserer forbindelser på forskellige måder.
- Flere lag eller parametre giver ikke automatisk en bedre eller mere pålidelig model.
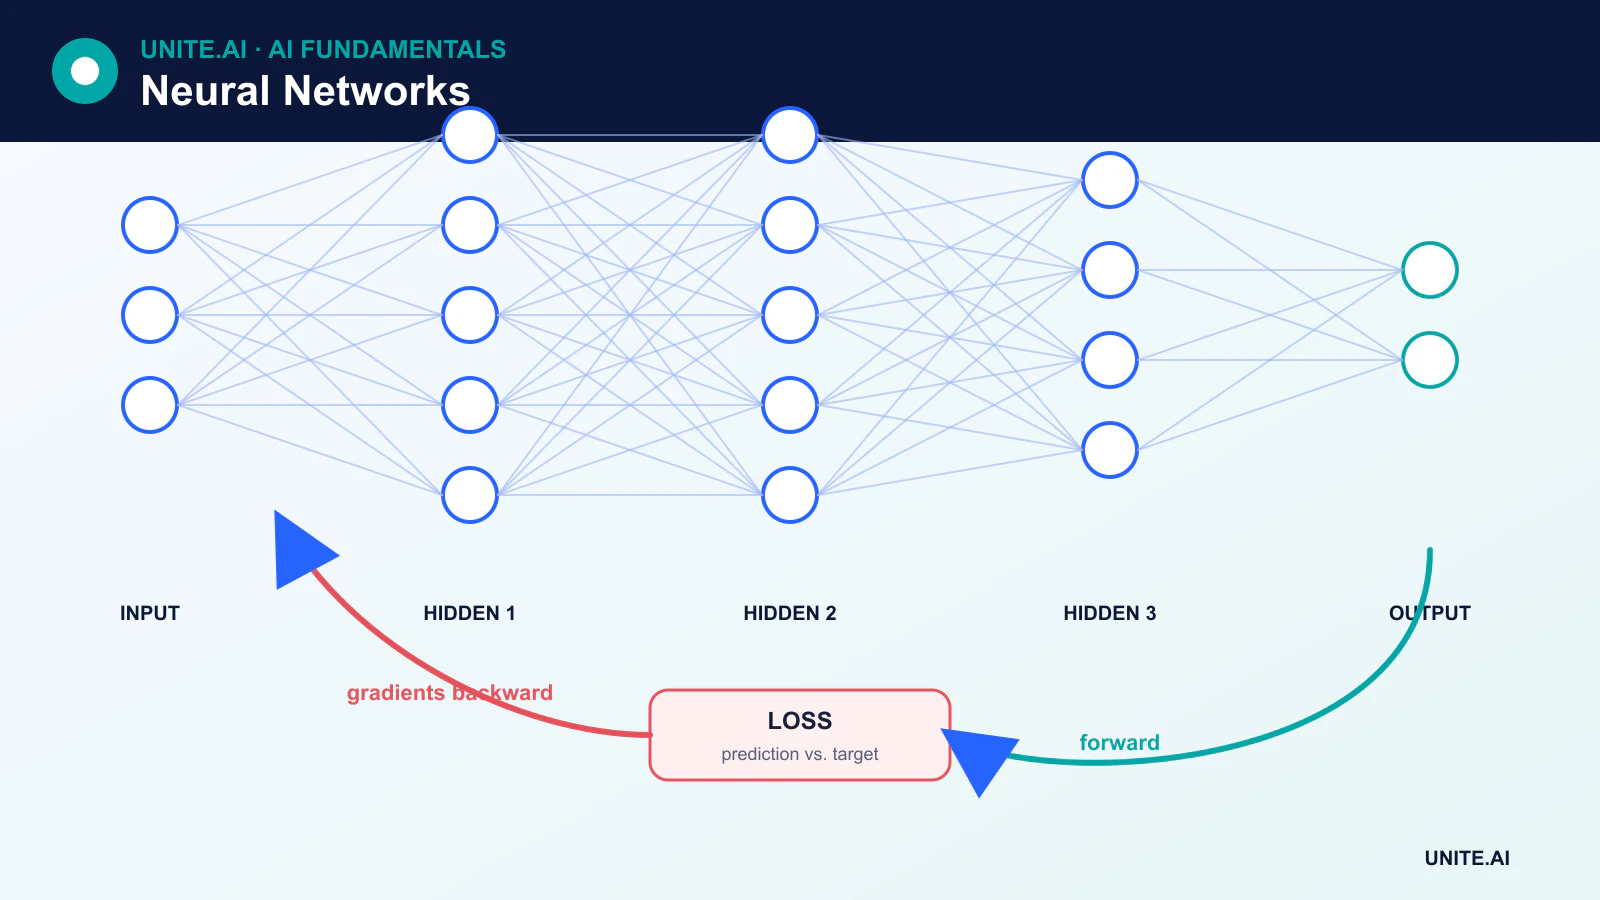
Fra en enkelt kunstig neuron til et netværk
For en inputvektor x beregner en grundlæggende enhed:
z = Wx + boutput = activation(z)
W indeholder træningsbare vægte, og b er en træningsbar bias. Aktiveringsfunktionen introducerer ikke-linearitet. Vægtene “går ikke igennem” aktiveringen alene; aktiveringen anvendes på den vægtede sum og bias.
Et multilayer perceptron (MLP) stabler tætte lag. Inputlaget repræsenterer funktionerne, de skjulte lag transformer dem, og outputlaget er designet til opgaven – for eksempel klasselogits eller en regressionsværdi.
Hvordan neurale netværk lærer
- Modellen initialiserer træningsbare parametre.
- Et fremadrettet pass behandler en batch og producerer forudsigelser.
- En tabsfunktion sammenligner forudsigelser med træningsmålet.
- Backpropagation bruger kæderegeln til at beregne gradienter.
- En optimizer såsom stochastic gradient descent eller AdamW opdaterer vægte og bias.
Backpropagation blev centralt for træning af neurale netværk gennem arbejde, der blev udviklet og populært over flere årtier; den blev ikke først skabt i den nyere deep‑learning æra. Moderne rammer implementerer automatisk differentiering i omvendt tilstand, så praktikere ikke behøver at udlede hver gradient manuelt.
Hvorfor aktiveringsfunktioner er vigtige
Uden ikke-lineære aktiveringer kollapser flere almindelige lineære lag til én lineær transformation. ReLU er udbredt, fordi den er enkel og effektiv. GELU og SiLU er almindelige i moderne arkitekturer. Sigmoid og softmax forbliver nyttige for specifikke outputfortolkninger, men sigmoid kan blive mættet i skjulte lag og bidrage til forsvindende gradienter.
Vigtige neurale netværksarkitekturer
Konvolutionelle neurale netværk
CNN’er anvender lærte filtre på tværs af lokale nabolag og deler parametre på tværs af positioner. Disse egenskaber gør dem effektive for billeder og andre gitterlignende signaler.
Rekurrente netværk
RNN’er, LSTM’er og GRU’er opdaterer en skjult tilstand over en sekvens. De er fortsat nyttige for streaming og tidsserietasks, selvom rekurrence begrænser parallel behandling og kan have problemer med lange afhængigheder.
Transformere
Transformere bruger attention til at skabe kontekstafhængige repræsentationer. Residualforbindelser, normalisering, positionsinformation og feed‑forward‑blokke er kerneelementer i arkitekturen. Transformere udgør nu grundlaget for mange store sprog‑ og multimodale modeller.
Autoenkodere og generative netværk
Autoenkodere lærer repræsentationer gennem rekonstruktion. GAN’er, diffusionsmodeller og autoregressive netværk genererer nye prøver ved hjælp af forskellige mål og træningsprocedurer.
Komponenter der gør dybe netværk trænbare
Moderne systemer bruger mere end lag og aktiveringer. Residual‑forbindelser lader information og gradienter omgå blokke. Normalisering stabiliserer aktiveringer. Regularisering, data‑augmentation, dropout og vægt‑decay kan reducere overfitting. Embedding‑lag kortlægger diskrete elementer som token til vektorer. Attention gør, at en repræsentation dynamisk kan afhænge af andre elementer.
Styrker og begrænsninger
Neurale netværk kan lære funktioner fra høj-dimensionelle rådata og skaleres med data og beregning. De kan også kræve store datasæt, specialiseret hardware og omhyggelig finjustering. Deres forudsigelser kan være dårligt kalibrerede, skrøbelige under fordelingsskift, sårbare over for adversarial manipulation eller vanskelige at forklare.
Arkitekturen bør følge opgavens og implementeringsbegrænsningerne. For mange tabelbaserede problemer kan en træ‑ensemble eller en lineær model være hurtigere og lettere at validere. For højt risikable anvendelser skal modelpræstation evalueres efter undergrupper og fejlsituationer, ikke kun efter et samlet benchmark.
Lag, aktiveringer og informationsflow
Et neuralt netværk sammensætter parameteriserede funktioner. Hver enhed danner en vægtet kombination af input, tilføjer en bias og sender resultatet gennem en aktivering såsom ReLU, sigmoid, tanh eller GELU. Stabling af lag muliggør hierarkiske funktioner og ikke-lineære beslutningsgrænser. Bredde styrer antallet af enheder pr. lag; dybde styrer på hinanden følgende transformationer; forbindelser og vægt‑deling kodificerer arkitekturen. Netværkets output afhænger af forbehandling, parametre, normalisering og inferencetilstand i kombination. En neuron er en matematisk operation, ikke en bogstavelig biologisk neuron eller et selvstændigt meningsfuldt begreb.
Fremadrettet propagation beregner forudsigelser; et tab kvantificerer fejl; backpropagation anvender kæderegeln på gradienterne; en optimizer opdaterer parametre. Initialisering, læringsrate, batch‑statistik, residual‑stier og normalisering påvirker, om gradienter forsvinder, eksploderer eller forbliver brugbare. Regularisering omfatter vægt‑decay, dropout, augmentation, tidlig stopning og arkitektoniske begrænsninger. Plot trænings‑ og valideringsadfærd, inspicer gradient‑ og aktiveringsstatistik, og sammenlign gentagne kørsel. Et stort netværk kan memorere træningsdata, mens et lille kan under‑fitte eller mangle nødvendig struktur.
Valg af arkitektur, evaluering og implementering
Multilayer perceptrons behandler faste vektorer; konvolutionelle netværk udnytter lokal struktur; rekurrente og state‑space‑modeller behandler sekvenser; transformere bruger attention; graf‑netværk udveksler information langs kanter. Hybrid‑modeller er almindelige. Vælg ud fra induktiv bias, data, sekvens‑ eller billedstørrelse, latenstid, hukommelse, fortolkelighed og tilgængelig hardware. Evaluer mod en lineær eller træ‑baseline og udfør ablationer for at lære, hvilken kompleksitet der betyder noget. Antallet af parametre alene forudsiger ikke kvalitet, inferencetid eller datakrav.
Implementering kræver frosset forbehandling, en eksporteret eller kompileret graf, numerisk validering og ressource‑tests under realistisk belastning. Kvantisering og beskæring kan reducere størrelse, men kan ændre adfærd for sjældne klasser. Overvåg input, output, kalibrering, latenstid og bekræftede resultater; test adversarial og skiftet data. Beskyt modeller, afhængigheder og data via signerede artefakter, adgangskontrol og leverandørkæde‑gennemgang. Forklaringer fra individuelle aktiveringer eller saliency kræver kausal og adfærdsmæssig verifikation. Neurale netværk er fleksible funktionsapproksimationer, ikke garantier for forståelse, sandhed eller robusthed.
Eksempel: en neural efterspørgselsprognostiker
En forhandler forudsiger ugentlig vareefterspørgsel ud fra salg, kampagner, pris, helligdage, tilgængelighed og vejr. Netværket sammenlignes med sæson‑naive, lineære og træ‑baselines ved brug af rullende tids‑splits. Fremtidige kampagner inkluderes kun, når de reelt er kendt på prognosetidspunktet, mens lagerudsolgt modelleres, fordi observeret salg kan undervurdere efterspørgslen. Evalueringen bruger vægtet absolut fejl, bias, intervaldækning og resultater efter vare‑hastighed og butik.
Implementerings‑pipeline‑versionerne indeholder funktionstilgængelighed, model og horisont og afviser en prognose, når nødvendige input er forældede. Planlæggere ser intervaller og kan tilsidesætte med registrerede årsager. Overvågning opdager manglende feeds, ændrende fejl, bias og usædvanlige prognoser; forretningsresultater adskilles fra prognosenøjagtighed, da bestillingspolitikken også påvirker lager. En modelopdatering skygger flere cyklusser, og den tidligere prognostiker forbliver tilgængelig for rollback under sæson‑ eller leverandør‑forstyrrelser.
Implementeringsbeviser og operationel klarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlagtigt eller manglende input, fordeling‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal ansvar for udgivelse, undtagelser, ændringer, rollback og pensionering tildeles. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overrides og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er hvert neuralt netværk dyb læring?
Nej. Et lille netværk med ét skjult lag er et neuralt netværk, mens dyb læring generelt refererer til arkitekturer med flere lærte behandlingsstadier. Grænsen er konventionel snarere end en streng videnskabelig tærskel.
Gemmer neurale netværk deres træningsdata?
De gemmer de lærte parametre, ikke en almindelig søgbar kopi af datasættet. Ikke desto mindre kan store modeller memorere og reproducere individuelle træningseksempler, hvilket skaber privatlivs‑ og ophavsretsrisici, der skal testes.
Primære referencer












