
Grundlæggende AI
Hvad er generativ AI?

 Føj Unite.AI til dine foretrukne kilder på Google
Generative AI refererer til modeller, der lærer mønstre i data og producerer ny tekst, billeder, lyd, video, kode eller andre repræsentationer, når de betinges af instruktioner eller eksempler. Outputtet syntetiseres ud fra en sandsynlighedsmodel; det hentes ikke intakt fra en database, selvom genvindingsværktøjer kan levere ekstern evidens.
Forskellige modelfamilier genererer på forskellige måder. Autoregressive transformere forudsiger en sekvens token for token, diffusionsmodeller fjerner støj fra et prøvegradvist, og generative adversarielle netværk lærer gennem en konkurrence mellem en generator og en diskriminator.
Vigtige pointer
- Generering er betinget sampling fra en lært fordeling, ikke garanteret faktuel genkaldelse.
- Transformere, diffusionsmodeller, GAN’er og variationale autoencodere har forskellige afvejninger.
- Genfinding og værktøjer kan forankre et system, men deres output og tilladelser kræver stadig validering.
- Risikostyring dækker data, model, grænseflade, implementering, overvågning og indholdsoprindelse.
Hvordan generative modeller lærer
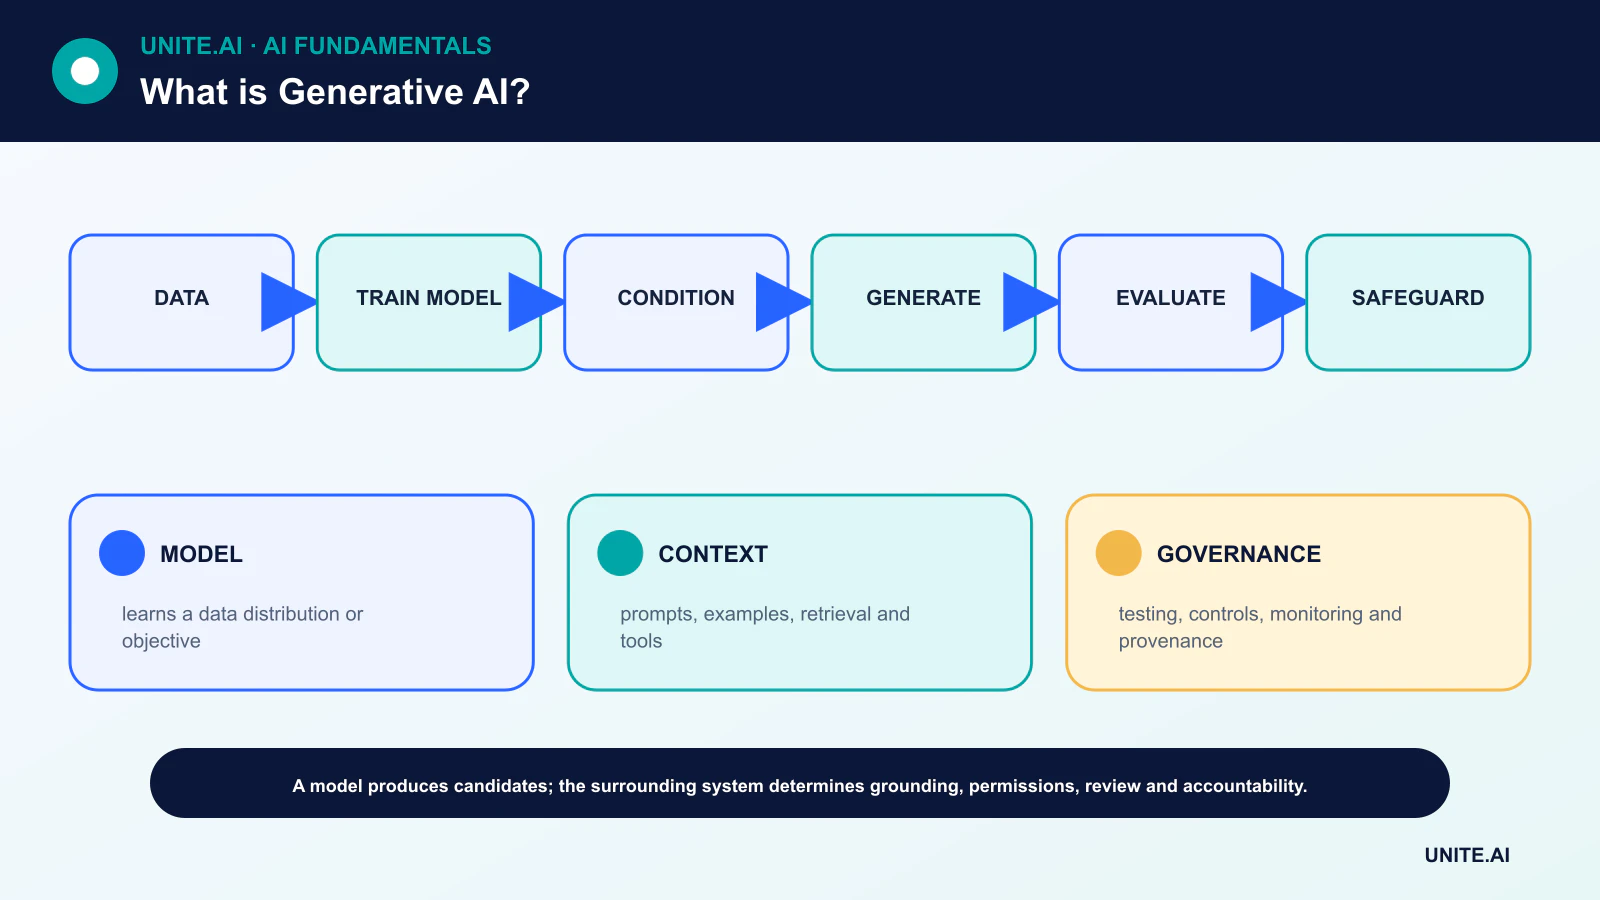
Træningsmål belønner en model for at forudsige eller rekonstruere mønstre i eksempler. En sprogmodel estimerer den næste token; en diffusionsmodel lærer at vende en støjproces; en variational autoencoder lærer en struktureret latent fordeling og dekoder.
Denne træning skaber statistisk generalisering, men kan også reproducere bias, memorere sjældne sekvenser eller fejle uden for datadistributionen. Dokumentation af datasæt, deduplikering, privatlivskontroller og hold‑out‑evaluering er derfor vigtige inden implementering.
Store arkitekturfamilier
Autoregressive transformere dominerer tekst og understøtter multimodale sekvenser. Diffusionsmodeller anvendes bredt til høj‑fidelitets billed‑ og lydgenerering. GAN’er kan skabe skarpe prøver og kontrollerbare billedsystemer, men kan være svære at træne.
Variationale autoencodere leverer latent‑variabel modellering og effektive repræsentationer, nogle gange som del af større generative pipelines. Reelle produkter kombinerer ofte flere modeller med genfinding, filtre, værktøjer og deterministisk kode.
Betingelse, sampling og kontrol
En prompt, klasseetiket, billede, lydklip eller struktureret post kan betinge generering. Sampling‑parametre ændrer diversitet og determinisme. En lavere temperatur kan koncentrere token‑sandsynligheder, men gør ikke et forkert svar sandt.
Kontrol forbedres, når systemet bruger eksplicitte skemaer, begrænset dekodning, reference‑materiale og validering. Prompt‑engineering ændrer kontekst; finjustering ændrer parametre; genfinding leverer ekstern information. Hver adresserer en forskellig fejltilstand.
Evaluering er applikationsspecifik
Tekstsystemer kan have brug for faktualitet, opgavefuldførelse, citationsstøtte, toksicitet og kalibreringstests. Billed‑ eller lydsystemer kan have brug for fidelitet, semantisk tilpasning, diversitet, identitetssikkerhed og perceptuel gennemgang. Kombinér automatiserede målinger med repræsentativ menneskelig evaluering.
Opbyg et versioneret evalueringssæt, der inkluderer almindelige, sjældne, adversarielle og politikrelevante tilfælde. Spor latenstid, omkostninger og afvisningsadfærd såvel som outputkvalitet. En demo udvalgt af sin skaber er ikke bevis på pålidelighed på befolkningsniveau.
Risici, beskyttelsesforanstaltninger og oprindelse
Vigtige risici omfatter hallucination, prompt‑injektion, skadeligt indhold, efterligning, usikker brug af værktøjer, privatlivs‑lækager, ophavsrets‑konflikter, automatiseringsbias og uigennemsigtige forsyningskæder. NIST’s Generative AI Profile organiserer handlinger på tværs af styring, indholdsoprindelse, test før implementering og hændelses‑offentliggørelse.
Brug mindst‑privilegerede værktøjer, input/output‑kontroller, menneskelig gennemgang for væsentlige beslutninger, logning, rollback og bruger‑rapportering. Vandmærker eller indholdscertifikater kan tilføje signaler, men ingen enkelt detektor eller mærkat fastslår sandheden. Den bredere syntetiske‑medie-arbejdsproces skal bevare kontekst og ansvarlighed.
Modelfamilier og genereringsmekanismer
Generative AI‑modeller estimerer eller lærer en proces, der kan producere ny tekst, billeder, lyd, video, kode eller strukturerede data. Autoregressive modeller forudsiger den næste token eller element; diffusionsmodeller lærer at vende en støjproces; variationale autoencodere lærer probabilistiske latente variable; GAN’er træner en generator mod en diskriminator. Multimodale systemer forbinder repræsentationer på tværs af medier. Outputtet samples fra den lærte statistiske struktur, betinget af prompts, kontekst, værktøjer eller andre input – det hentes ikke som en garanteret kendsgerning.
Fundamentale modeller er fortrænet på brede data og tilpasses gennem prompting, genfinding, finjustering, præferenceoptimering, kontrolnetværk eller opgavespecifikke hoveder. Tokenizere, encodere, decodere, latente rum og sampling‑indstillinger former resultaterne. Temperatur og kandidatfiltrering afvejer determinisme og diversitet. Længere prompts giver kontekst, men kan konflikte, distrahere eller indeholde ondsindede instruktioner. Genfinding kan forankre skiftende viden, mens deterministisk kode bør håndtere præcise beregninger og regler.
Evaluering, oprindelse og rettigheder
Evaluer efter opgave: faktuel korrekthed og citation for svar, udførelse og sikkerhed for kode, fidelitet og diversitet for medier, samt menneskeligt resultat for kreativ assistance. Inkluder afvisning, kalibrering, latenstid, omkostninger, sprog, tilgængelighed og adversarielle tests. Et flydende eller fotorealistisk output kan være forkert. Bevar model, prompt, seed, kilde‑evidens, værktøjskald og efterbehandling for reproducerbarhed. Adskil genfindingskvalitet fra generering, så et poleret svar ikke kan skjule manglende evidens.
Træning og output rejser spørgsmål om ophavsret, licens, samtykke, privatliv, offentlighed og fortrolighed. Etablér oprindelse og tilladt brug af input‑data; forhindre brugere i at afsløre hemmeligheder; test memorisering; og tilbyd rapporterings‑ og fjernelsesprocesser. Syntetisk medie bør bære holdbar oprindelse eller afsløring, hvor det er muligt, især når det kan forveksles med bevis. Brug ikke lighed, stemme eller stil på måder, der krænker rettigheder eller vildleder.
Implementeringskontroller
Behandl modeloutput som upålidelig input. Valider skemaer, saniter kode og filer, isoler eksekvering, autoriser hvert værktøj eksternt, begræns omkostninger og hastighed, og kræv bekræftelse for væsentlige handlinger. Overvåg fejl, misbrug, drift og brugerrettelser, med rollback og en ikke‑generativ fallback. Dokumentér tilsigtet og forbudt brug. Generativ AI udvider grænsefladen for at skabe og transformere information, men pålidelighed og ansvarlighed kommer fra de omgivende data, evaluering, sikkerhed, oprindelse og den menneskelige beslutningsproces.
Praktisk eksempel: en generativ produktbeskrivelsesassistent
En forhandler lader redaktører generere udkast til beskrivelser kun ud fra godkendte produktattributter og brand‑vejledning. Prompten indeholder strukturerede fakta, mens genfinding leverer gældende politik. Output skal følge et skema og valideres mod kildeværdier; ikke‑understøttede dimensioner, sikkerhedspåstande eller certificeringer medfører afvisning. Evalueringen dækker faktuel nøjagtighed, stil, duplikering, flersproglig kvalitet, tilgængelighed, latenstid og redaktørkorrektion, sammenlignet med skabeloner og manuel skrivning.
Redaktører godkender hver publikation og kan se kildefelter. Modellen har ingen mulighed for at ændre pris, lagerbeholdning eller publicere direkte. Prompter og produktdata er beskyttet mod injektion, og fortrolige leverandørnoter er udelukket. Overvågning sporer ikke‑understøttede påstande, redigeringer, klager, omkostninger og leverandørversioner. Genereret tekst gemmes med oprindelse. Systemet sparer udarbejdelsestid kun hvis korrektioner og gennemgang ikke udligner gevinsten, og produktets sandhed forbliver styret af autoritative data.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar basislinje og et versioneret evalueringssæt inden finjustering. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed til frigivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genopretning, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er generativ AI det samme som en stor sprogmodel?
Nej. LLM’er er én klasse af generativ model. Generativ AI omfatter også billed‑, lyd‑, video‑ og strukturerede datasystemer bygget med flere arkitekturer.
Kopierer en model sit træningsdata?
Den syntetiserer typisk ud fra lærte mønstre, men memorisering og næsten‑duplikering kan forekomme. Privatlivs‑ og oprindelsesrisici skal evalueres i stedet for blot at antage, at de er fraværende.
Primære referencer












