
Grundlæggende AI
Off-the-Shelf vs. Tilpassede Machine Learning-modeller

 Føj Unite.AI til dine foretrukne kilder på Google
Det er sjældent en simpel køb‑vs‑byg‑beslutning at vælge en maskinlæringsløsning. Det egentlige kontinuum spænder fra en hosted API eller en pakket model, gennem prompting, hentning og finjustering, til en fuldt tilpasset arkitektur trænet på organisationsspecifikke data.
Den bedste løsning er den mindst komplekse tilgang, der opfylder et verificeret produktkrav. En tilpasset model kan give kontrol og differentiering, men den medfører også en løbende forpligtelse til at drive datapipelines, evalueringer, overvågning, sikkerhed, opdateringer og rollback.
Vigtige pointer
- Start med en målbar opgave, en ikke‑ML baseline og accepttærskler.
- Evaluer kandidatmodeller på repræsentative private data i stedet for kun offentlige benchmark‑resultater.
- Inkluder integrations‑, latenstid‑, gennemgangs‑, gen‑trænings‑ og hændelsesomkostninger i den samlede ejeromkostning.
- Foretræk reversible faser: baseline, hent eller prompt, finjuster, og træn fra bunden kun når beviserne understøtter det.
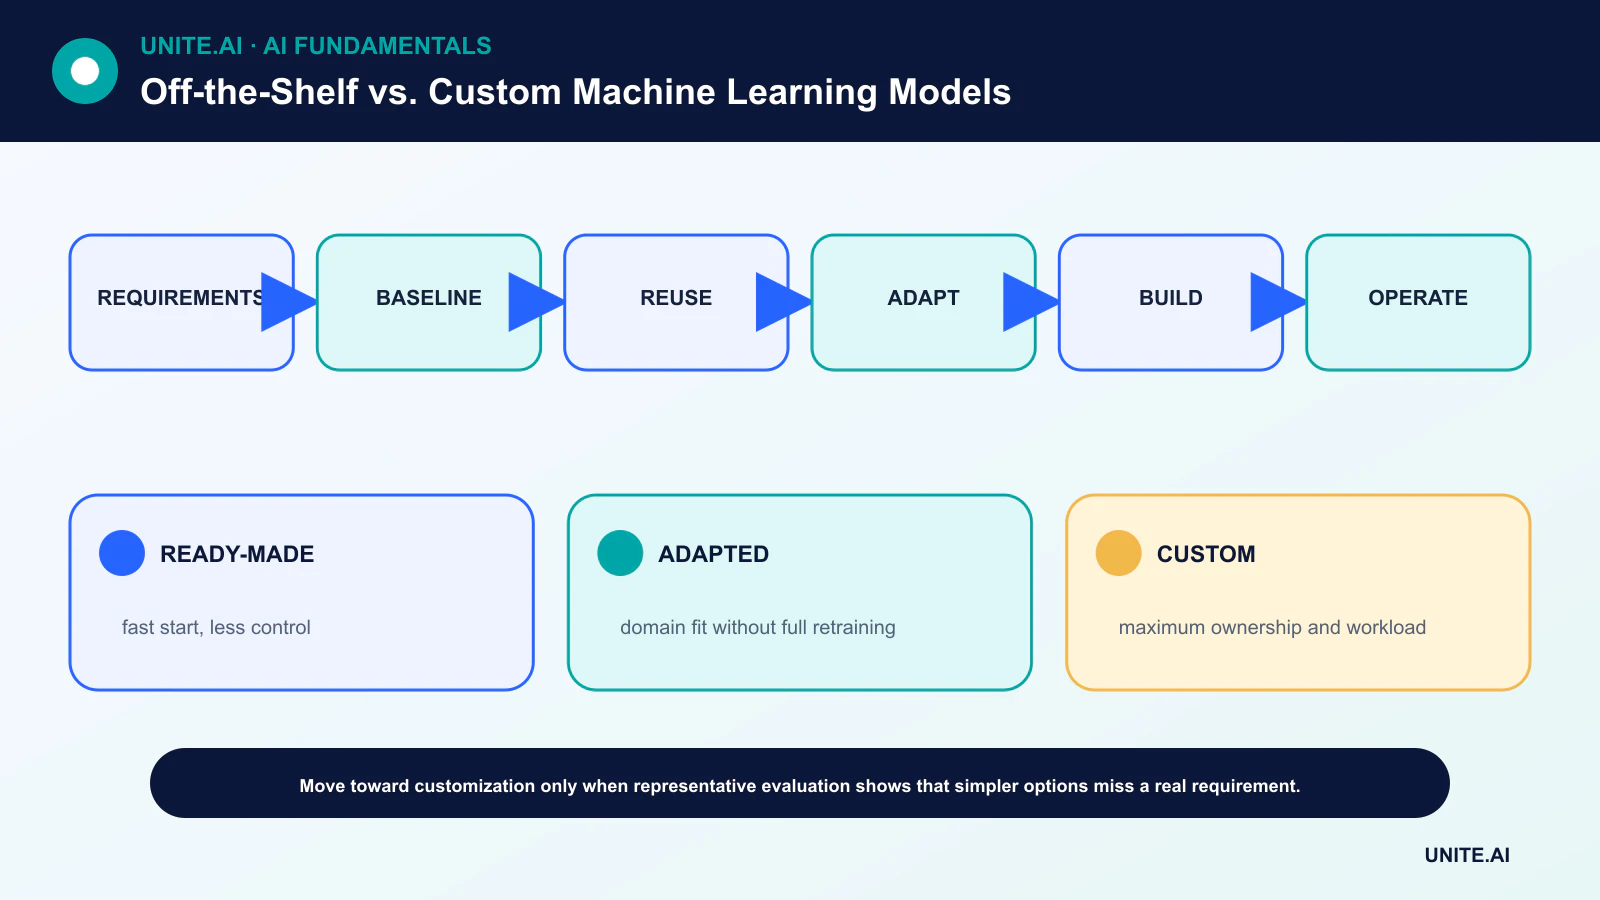
Definér beslutningen, før du vælger en model
Specificér brugeren, beslutningen, input, output, fejlkostnader, latenstidbudget, trafikmønster og eskaleringsvej. Bestem om en deterministisk regel eller et søgesystem løser en tilstrækkelig del af problemet. Googles Rules of ML anbefaler simple baselines og pålidelig infrastruktur før kompleks modellering.
Opret et offline evalueringssæt, der afspejler produktionen, inklusive sjældne og modstandere tilfælde. Hvor beslutninger påvirker mennesker, definér undergruppe‑kontroller og menneskelig‑gennemgangsregler. Disse porte gør sammenligninger konkrete i stedet for at gøre arkitekturvalget til en præference.
Genbrugs‑ og tilpasningskontinuummet
En hosted API giver hurtig integration og administreret skalering, men begrænset kontrol over modellens interne, versioner og datahåndtering. En åben fortrænet model øger deployments‑kontrol. Hentning eller prompt‑engineering kan tilføje domænekontekst uden at ændre vægte.
Finjustering eller parameter‑effektive adapters kan specialisere adfærd. Træning fra bunden er kun berettiget, når data, mål, skala eller ejerskabskrav ikke kan opfyldes gennem genbrug. Transfer learning fanger ofte størstedelen af værdien med væsentligt mindre data og beregning.
Kvalitet, kontrol og indlåsning
Mål opgavens kvalitet, kalibrering, latenstid, gennemløb, tilgængelighed og fejl‑konsistens. En leverandørmodel kan automatisk forbedres, men kan også ændre adfærd; en selv‑hostet model kan låses, men kræver at teamet håndterer opgraderinger og sårbarheder.
Kontraktbetingelser bør omfatte datalagring, træningsbrug, regional behandling, immaterielle rettigheder, serviceniveauer, eksportveje og udfasning. Portabilitet forbedres, når applikationen adskiller model‑specifikke adapters fra forretningslogik og gemmer reproducerbare evalueringsartefakter.
Privatliv, sikkerhed og drift
Kortlæg hver datastream og trusselsgrænse. Følsomme input kan kræve privat netværk, on‑premise inferens eller edge AI. Selv‑hosting gør ikke automatisk et system sikkert; det overfører sikkerheds‑ og compliance‑ansvar til operatøren.
Produktionsansvar omfatter observerbarhed, driftstjek, misbrugs‑overvågning, hændelsesrespons og rollback. Driftsteamet skal kunne svare på, hvilken model, prompt, dataversion og politik der producerede resultatet.
Brug trinvis evidens, ikke ideologi
Kør en tidsbegrænset benchmark med samme datasæt og acceptkriterier på tværs af muligheder. Estimér ingeniørtid, annotering, accelerator‑brug, leverandørgebyrer, gennemgangsarbejde, fejlkostnader og den forventede ændrings‑cadence.
Vælg den enkleste kandidat, der passerer portene, og revurder derefter når krav eller priser ændrer sig. Tilpasning er værdifuld, når den giver målbar fordel eller nødvendig kontrol – ikke blot fordi en skræddersyet model lyder strategisk vigtig.
Krav og totalomkostnings‑sammenligning
En off-the-shelf model, API eller pakket system leverer forudbygget funktionalitet med leverandørsupport og hurtigere første udrulning. En tilpasset model trænes eller tilpasses væsentligt til en specifik opgave, data og driftsmiljø. Valget begynder med krav: målresultat, kvalitet pr. undergruppe og kant‑case, latenstid, gennemløb, tilgængelighed, forklarbarhed, data‑residens, opdaterings‑kontrol, integration, sikkerhed og fejlkonssekvens. En generisk benchmark eller demo kan ikke besvare, om et produkt opfylder disse krav.
Den samlede omkostning inkluderer evaluering, datapreparation, mærkning, integration, licenser eller forbrug, infrastruktur, overvågning, gennemgang, hændelsesrespons, opgraderinger og exit. Off-the-shelf sænker den indledende ingeniøromkostning, men kan skabe variable omkostninger, indlåsning, adfærdsændringer og begrænset observerbarhed. Tilpasset udvikling tilføjer data‑ og MLOps‑ansvar og kan stadig afhænge af fortrænede vægte og leverandører. Modelomkostning bør måles pr. succesfuld opgave ved påkrævet kvalitet, ikke pr. token eller træningskørsel alene.
Evaluering, indkøb og tilpasning
Byg et repræsentativt privat testsæt før leverandørudvælgelse og kør hver kandidat under identiske prompts, forbehandling, tærskler og driftsgrænser. Inkluder tvetydige, modstandende, ikke‑understøttede, flersprogede og høj‑konsekvens‑cases. Mål nøjagtighed, kalibrering, latenstid, omkostning, afvisning, sikkerhed og påvirkning af menneskelige arbejdsprocesser. Test API‑nedbrud, rate‑limits, regional adfærd og versionsskift. Leverandørpåstande kræver dokumentation for træning, rettigheder, privatliv, lagring, underdatabehandlere, sikkerhed, support og hændelses‑meddelelse.
Tilpasningsmuligheder danner et spektrum: konfiguration, hentning, prompting, finjustering, parameter‑effektive opdateringer, tilpassede heads eller træning fra bunden. Brug den mindst komplekse metode, der opfylder evidensen. Hentning er passende for hyppigt skiftende viden; tuning kan forme format‑ eller domæneadfærd; deterministisk kode bør håndtere eksakte regler. Valider kombinerede systemer, fordi en stærk basismodel stadig kan fejle gennem dårlig hentning, tilladelser eller integration.
Livscyklus og exit‑planlægning
Hosted produkter kan ændre sig eller forsvinde, mens tilpassede modeller bliver teknisk gæld uden ejere. Versionsafhængigheder, overvåg adfærd og resultater, definér gen‑trænings‑ eller revurderings‑triggere, og vedligehold rollback. Bevar data og grænseflader, der er nødvendige for at migrere, forhandle sletning og eksport, og undgå at eksponere en leverandørs proprietære skema i hele applikationen. Det bedste valg kan være hybrid: kommerciel kapacitet til standardopgaver og tilpassede komponenter hvor domæne‑performance, kontrol eller risiko skaber varig værdi.
Praktisk eksempel: valg af en dokument‑ekstraktionsmodel
En virksomhed opretter et privat testsæt af fakturaer fra forskellige leverandører, sprog, scanninger, håndskrift og kant‑cases, og sammenligner derefter en administreret API, en åben fortrænet model, en tilpasset model og en regel‑baseline. Den scorer felt‑nøjagtighed, økonomisk fejl, ikke‑understøttede dokumenter, latenstid, gennemløb, privatliv, residens, integration og omkostning pr. korrekt behandlet faktura. Leverandør‑demoer og offentlige benchmarks erstatter ikke denne matchede evaluering.
Den valgte hybrid bruger en kommerciel OCR‑tjeneste med lokal validering og menneskelig gennemgang for lav tillid eller store beløb. Kontrakter definerer lagring, underdatabehandlere, opdateringer og sletning; arkitekturen bevarer kildefiler og en exit‑vej. En skyggeperiode opdager schema‑ og leverandør‑huller. Overvågning adskiller OCR, ekstraktion, validering og korrektur fra reviewer. Hvis leverandørens adfærd ændrer sig, kan teamet fryse, skifte eller flytte mere arbejde til sin tilpassede komponent uden at omskrive den finansielle arbejdsproces.
Implementerings‑evidens og drifts‑klarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsebetingelser, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underbetjent. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne evidens fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Drifts‑telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑status, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, og gennemgå real‑world evidens efter implementering i stedet for at antage, at offline‑performance vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændrer sig. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og lagringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Hvornår bør et team træne en model fra bunden?
Når fortrænede eller hosted muligheder ikke kan opfylde validerede krav, og teamet har tilstrækkelige proprietære data, beregningskraft, ekspertise og langsigtet driftskapacitet.
Er en off-the-shelf model vedligeholdelsesfri?
Nej. Integration, evaluering, versionsændringer, overvågning, privatlivskontroller og fallback‑adfærd forbliver adopterens ansvar.
Primære referencer











