
Grundlæggende AI
Hvad er platform engineering? Platforme, udvikleroplevelse og sikkerhedsrammer

 Føj Unite.AI til dine foretrukne kilder på Google
Platform engineering er praksissen med at bygge og drive delte interne kapabiliteter, der hjælper software‑teams med at levere og køre applikationer gennem understøttede selvbetjenings‑arbejdsgange. Platformen betragtes som et produkt, hvis brugere er udviklere og andre tekniske teams.
En platform er ikke automatisk en portal, Kubernetes‑klynge eller en samling af scripts. Den bliver nyttig, når den reducerer den kognitive belastning og gennemløbstid, samtidig med at den forbedrer pålidelighed, sikkerhed, observabilitet og organisatorisk konsistens.
Vigtige pointer
- Start med udviklerundersøgelser og tilbagevendende friktion, ikke en forudbestemt værktøjskæde.
- Tilbyd valgfrie, understøttede golden paths med klare undslipningsveje for legitime undtagelser.
- Eksponér kapabiliteter via API’er, skabeloner, automatisering og dokumentation; en portal er kun én grænseflade.
- Mål brugerresultater og produktadoption sammen med levering, pålidelighed, sikkerhed og omkostninger.
Platform som et internt produkt
Et platformteam identificerer interne brugere, rejser, smertepunkter og ønskede resultater. Det vedligeholder en roadmap, serviceniveauer, dokumentation, support og feedback‑loops som ethvert produktteam. Adoption opnås gennem nytte, ikke ved at pålægge et centralt team.
Dette udvider samarbejdet med DevOps. Applikationsteams bevarer ejerskabet af deres tjenester, mens platformen leverer genanvendelige kapabiliteter og politik.
Kapabiliteter, portaler og golden paths
Kapabiliteter kan omfatte repositories, miljøer, CI/CD, hemmeligheder, identitet, infrastruktur, observabilitet, servicekataloger, omkostninger og incident‑integration. En udviklerportal kan eksponere dem, men orkestrering og driftsservices gør platformen virkelig.
En golden path er en velunderstøttet måde at udføre en almindelig opgave på. Den skal indkode sikre standardindstillinger og forblive gennemsigtig. Teams har brug for en styret undtagelsessti, når kravene afviger.
Arkitektur og sikkerhedsrammer
Brug stabile grænseflader og deklarative API’er, så platformen kan udvikle sig bag dem. Adskil kontrolplanen fra arbejdsbelastninger, afgræns legitimationsoplysninger, bevar ejerskabs‑metadata, og gør genererede ændringer gennemgåelige og reversible.
Integrér DevSecOps-kontroller, politik og artefakt‑oprindelse i arbejdsgange. Sikkerhedsrammer bør give hurtig feedback og handlingsorienteret afhjælpning i stedet for uforklarede afslag.
Mål og udvikl
Mål tid til første implementering, gennemløbstid, genopretning efter fejlet ændring, platformens tilgængelighed, supportbyrde, adoption, tilfredshed, sikkerhedsposition og omkostninger. Undgå at tælle portal‑login som en proxy for forbedret levering.
Instrumentér platformen gennem IT‑drifts-praksisser og interview regelmæssigt brugere. Afvikl ubrugte stier, standardisér hvor gentagelse er dyrt, og tillad diversitet hvor den skaber produktværdi.
Interne udviklerplatforme og golden paths
En intern udviklerplatform er et produkt, der eksponerer godkendt infrastruktur og operationelle kapabiliteter via selvbetjenings‑grænseflader. Den kan kombinere en portal, servicekatalog, skabeloner, API’er, kommandolinjeværktøjer, implementerings‑arbejdsgange, hemmeligheder, miljøer og observabilitet. Platformen erstatter ikke cloud eller Kubernetes; den organiserer dem til brugbare kapabiliteter.
En golden path er en opinioneret, understøttet måde at fuldføre en almindelig opgave på, fx at oprette en service med et repository, CI‑pipeline, runtime, dashboards, alarmer og ejerskabs‑metadata. Den skal være den letteste sikre mulighed, samtidig med at den tillader berettigede undtagelser. En obligatorisk sti, der ikke kan understøtte reelle arbejdsbelastninger, bliver en flaskehals eller omgås.
Platformsteams bør betragte udviklere som kunder og kapabiliteter som produkter. Opdagelsesinterviews, brugsanalyse, supportdata, roadmaps, dokumentation og serviceniveau‑mål er lige så vigtige som automatisering. Adoption er bevis på nytte, men adoption alene beviser ikke, at levering, pålidelighed, sikkerhed eller udvikleroplevelsen er forbedret.
Kontrolplaner, grænseflader og driftsmodel
Platformens kontrolplan afstemmer en udviklers erklærede intention med de underliggende ressourcer. En servicedefinition kan anmode om en runtime, database, region og pålidelighedsniveau; controllere oversætter dette til cloud‑, netværks‑, politik- og observabilitets‑konfiguration. Stabile abstraktioner bør skjule tilfældig kompleksitet uden at skjule den operationelle tilstand, der er nødvendig for fejlfinding.
Grænseflader kan omfatte web‑portaler, API’er, Git‑baseret konfiguration, CLI’er og genanvendelige pipeline‑komponenter. Den bedste grænseflade afhænger af opgavens hyppighed og brugerens arbejdsgang. Hver grænseflade kræver autentifikation, autorisation, validering, revisionshistorik, fejlforklaringer og versionering. Selvbetjening uden livscyklushåndtering fører til forladte ressourcer og konfigurations‑spredning.
Et platformteam ejer delte kapabiliteter og udlagte veje, mens applikationsteams bevarer ansvaret for softwareadfærd og forretningsresultater. Sikkerheds‑, pålideligheds‑, finans‑ og infrastrukturteams bidrager med politikker og tjenester. Tydelige ansvarsgrænser forhindrer, at platformen bliver enten en uansvarlig ticket‑kø eller et forsøg på at centralisere alle ingeniørbeslutninger.
Måling af værdi og undgåelse af platformfejl
Mål gennemløbstid til første produktions‑implementering, tid til miljø‑provisionering, implementeringsfrekvens, fejlrate ved ændringer, genoprettelsestid, kognitiv belastning, supportvolumen, pålidelighed og adoption af sikkerhedskontroller. Segmentér resultater efter team og arbejdsbelastning. En hurtigere skabelon‑lancering har begrænset værdi, hvis dag‑to‑ændringer forbliver langsomme eller hændelser bliver sværere at diagnosticere.
Almindelige fejl omfatter at bygge, før man forstår brugerne, kopiere en stor virksomheds stack, eksponere rå infrastruktur bag en portal, tvinge for tidlig standardisering og optimere for platformteamets output. Start med én smertefuld tilbagevendende rejse, kortlæg dens trin og ventetider, lever en tynd ende‑til‑ende‑sti, og iterér baseret på observerede resultater.
Platforme skal udvikle sig uden at destabilisere alle tjenester. Brug versionerede kontrakter, deprecations‑vinduer, automatiserede migrationer, kompatibilitetstests og klar ejerskab. Spor platform‑afhængigheder, så et kontrol‑plane‑nedbrud ikke blokerer alle implementeringer eller beskadiger kørende arbejdsbelastninger. Dokumentér nød‑procedurer og test regelmæssigt genoprettelse efter platformfejl.
Arbejdeeksempel: en selvbetjeningssti for en ny API
En udvikler vælger en godkendt API‑skabelon og angiver service‑navn, ejer, dataklassificering, sprog og pålidelighedsniveau. Platformen opretter et repository, afhængighedspolitik, CI‑pipeline, testmiljø, implementeringskonfiguration, servicekatalog‑post, dashboards, alarmer og en indledende runbook. Politikken validerer navne, regioner, tilladelser og netværkseksponering inden provisionering, mens de genererede artefakter forbliver inspicerbare og ejet af teamet.
Platformen eksponerer livscyklus‑operationer — opret miljø, implementer, skaler, roter en hemmelighed, vis logs, rul tilbage og afvikl — via stabile API’er og en portal. Kørende arbejdsbelastninger fortsætter, hvis portalen er utilgængelig. Undtagelser bruger et dokumenteret udvidelses‑punkt og udløbsdato i stedet for en uregistreret manuel ændring. Versionerede skabeloner og automatiserede migrationer forhindrer, at platformforbedringer stille bryder eksisterende tjenester.
Mål tid fra repository‑oprettelse til en sund produktions‑implementering, udviklerindsats, supportbehov, fejlrate ved ændringer, genoprettelse, politik‑overholdelse og adoption efter arbejdsbelastningstype. Interview brugere, der opgiver stien, og inspicer hvor de venter eller undslipper abstraktionen. Platformteamet bør prioritere den største tilbagevendende friktion, offentliggøre pålidelighed og roadmap, og afvikle ubrugte kapabiliteter. Et poleret katalog er ikke en platform, hvis teams stadig har brug for tickets til hver meningsfulde handling.
Adoption bør rulles ud i faser. Start med frivillige teams og én arbejdsbelastningsklasse, bevis dag‑to‑operationer, og migrér derefter med værktøjer og support. Offentliggør platformens service‑mål og afhængighedsstatus, og design en nød‑rute, der er kontrolleret men brugbar under nedbrud. Chargeback eller showback kan afsløre ressourceomkostninger, men produktteams har også brug for fornuftige standardindstillinger, så økonomisk styring ikke bliver en ny manuel godkendelses‑kø.
Praktisk implementerings‑tjekliste
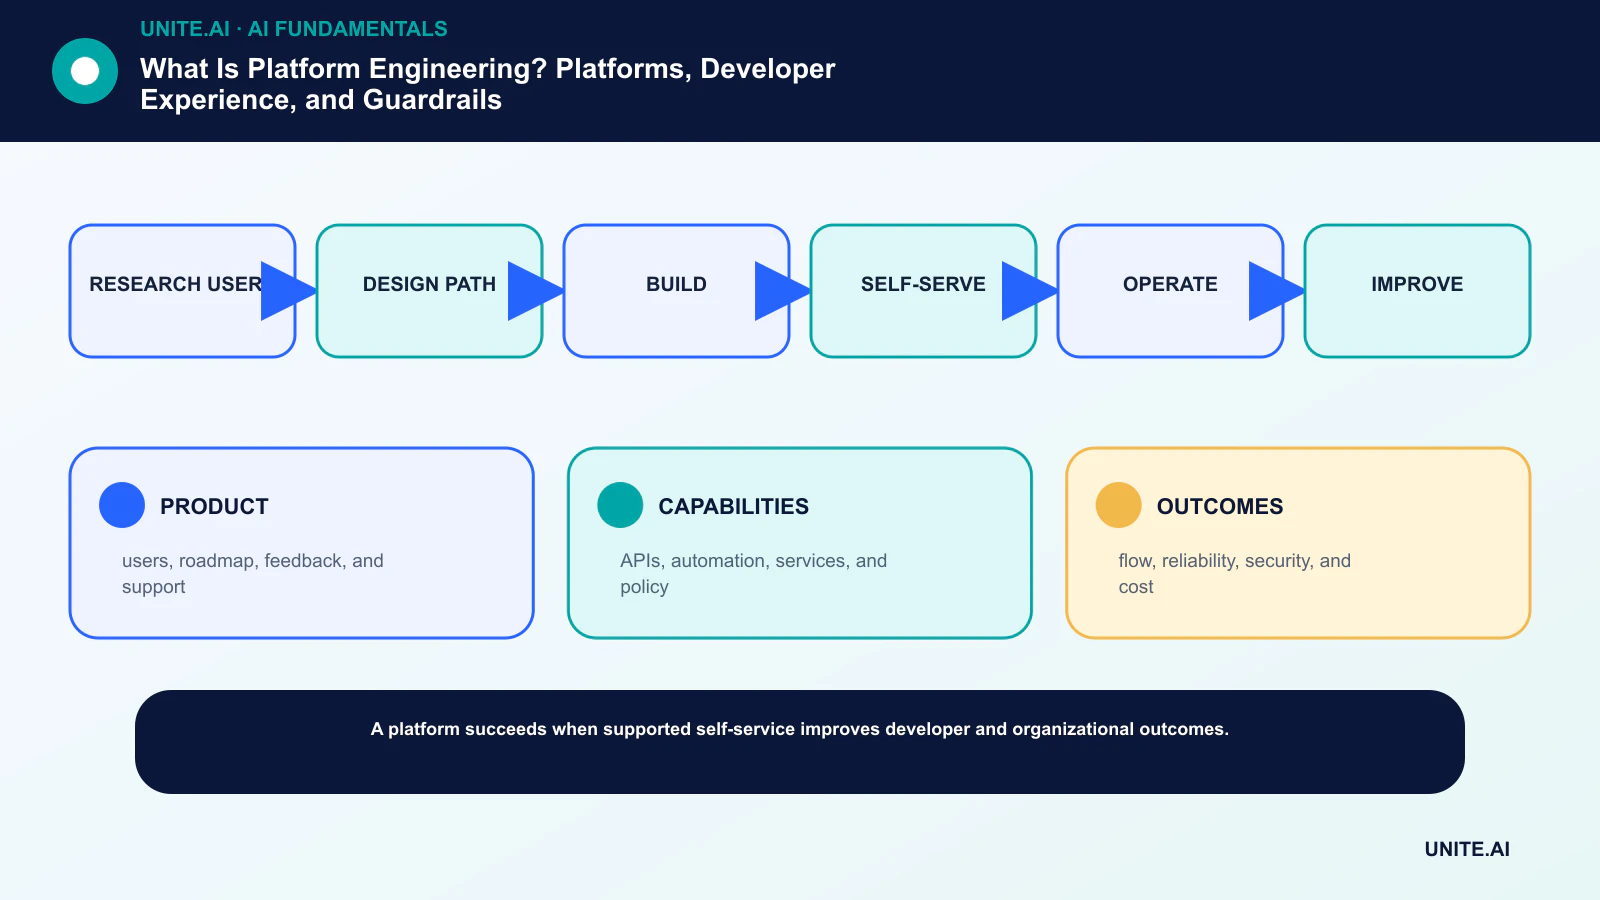
Omform konceptet til en afgrænset, testbar arbejdsgang: undersøg brugere → design sti → byg → selvbetjen → drifts → forbedr. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, fastlæg en simpel baseline, sæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér overvågning, rollback og review, før du udvider omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabs‑review med de personer, der bygger, drifter, sikrer og påvirkes af systemet. Test normale tilfælde, grænsebetingelser, afhængighedsfejl og misbrug; bevar beviserne og de uløste risici. Definér hvem der kan godkende en release, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når virkelige data ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- PRODUCT: brugere, roadmap, feedback og support.
- CAPABILITIES: API’er, automatisering, tjenester og politik.
- OUTCOMES: flow, pålidelighed, sikkerhed og omkostninger.
Ofte stillede spørgsmål
Er platform engineering ved at erstatte DevOps?
Nej. Platform engineering er én måde at skalere DevOps‑principper på ved at levere delte produkter og selvbetjenings‑kapabiliteter. Samarbejde og service‑ejerskab forbliver væsentlige.
Er en intern udviklerportal selve platformen?
Normalt ikke. En portal er en grænseflade. Platformen omfatter også API’er, automatisering, infrastruktur, politikker, tjenester, dokumentation, support og driftsansvar.
Primære referencer











