Grundlæggende AI
Hvad er AIOps? Kunstig intelligens til IT-drift

 Føj Unite.AI til dine foretrukne kilder på Google
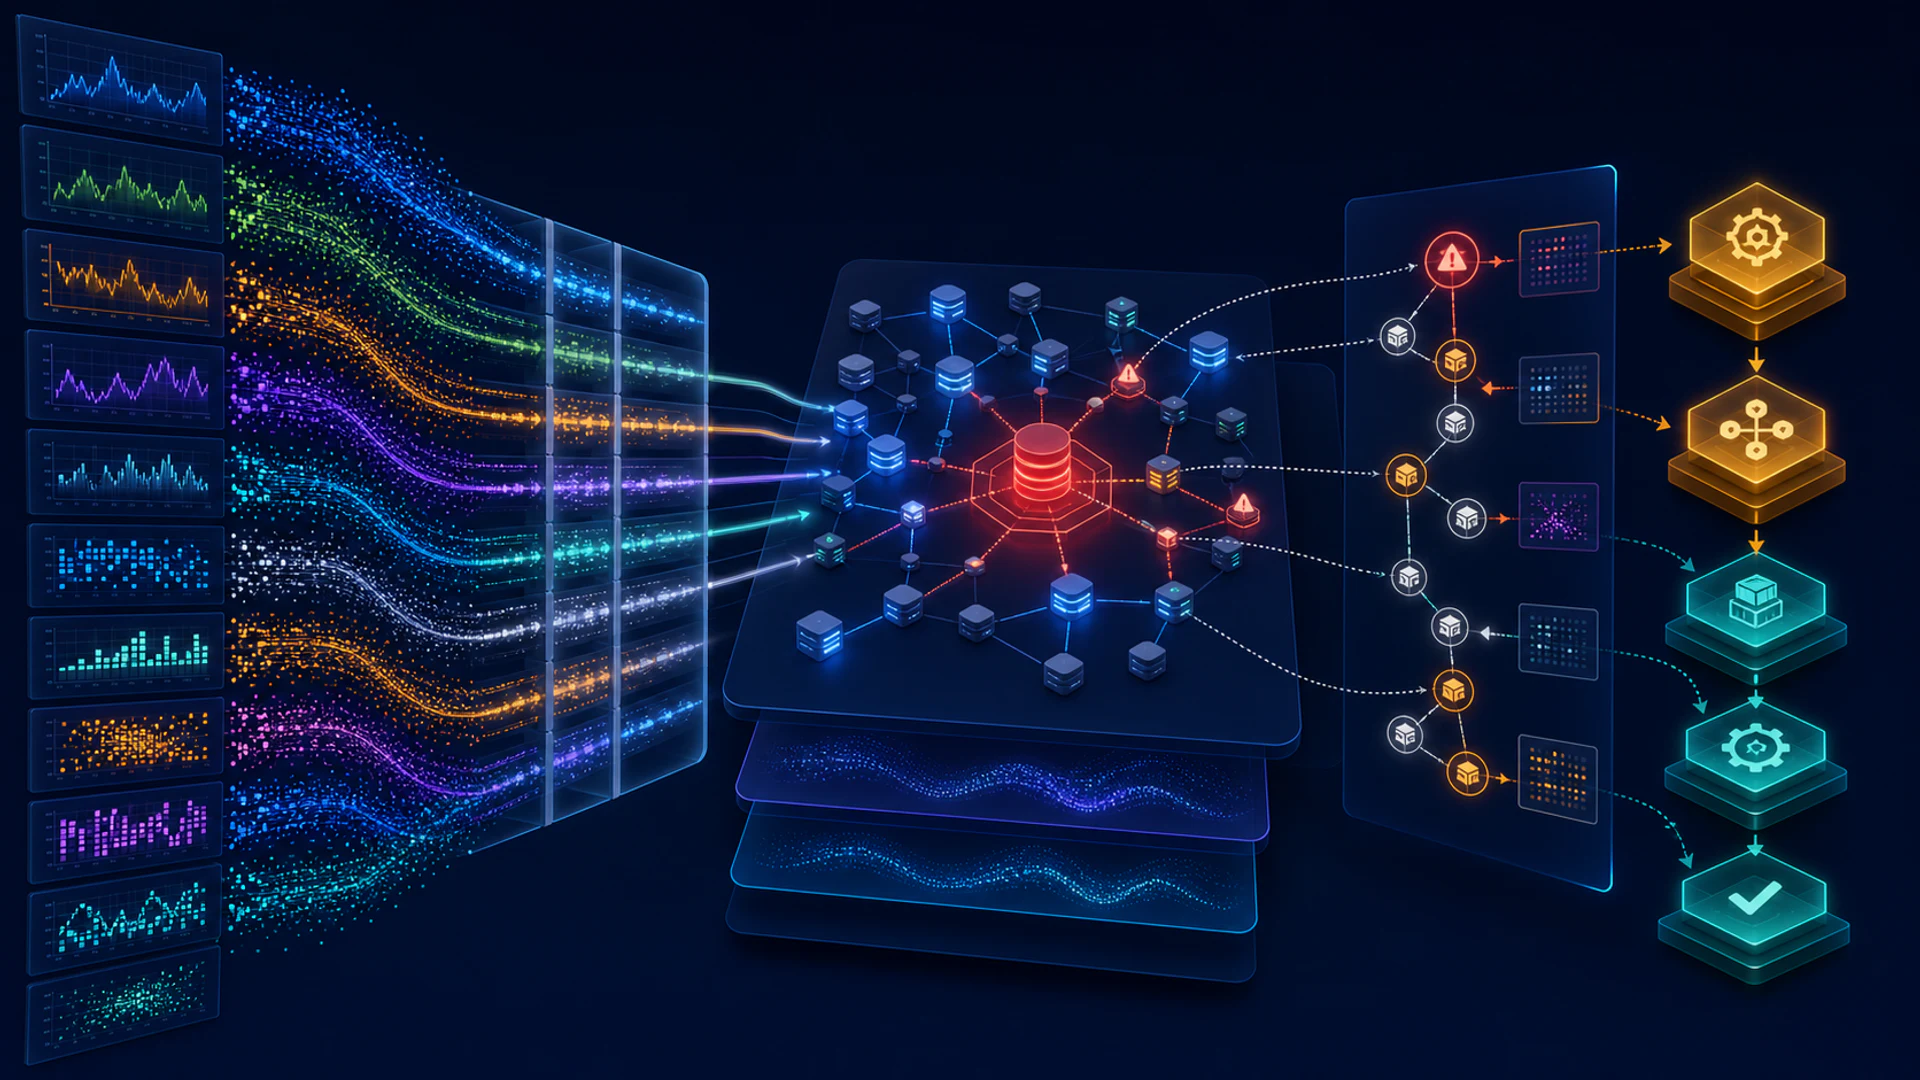
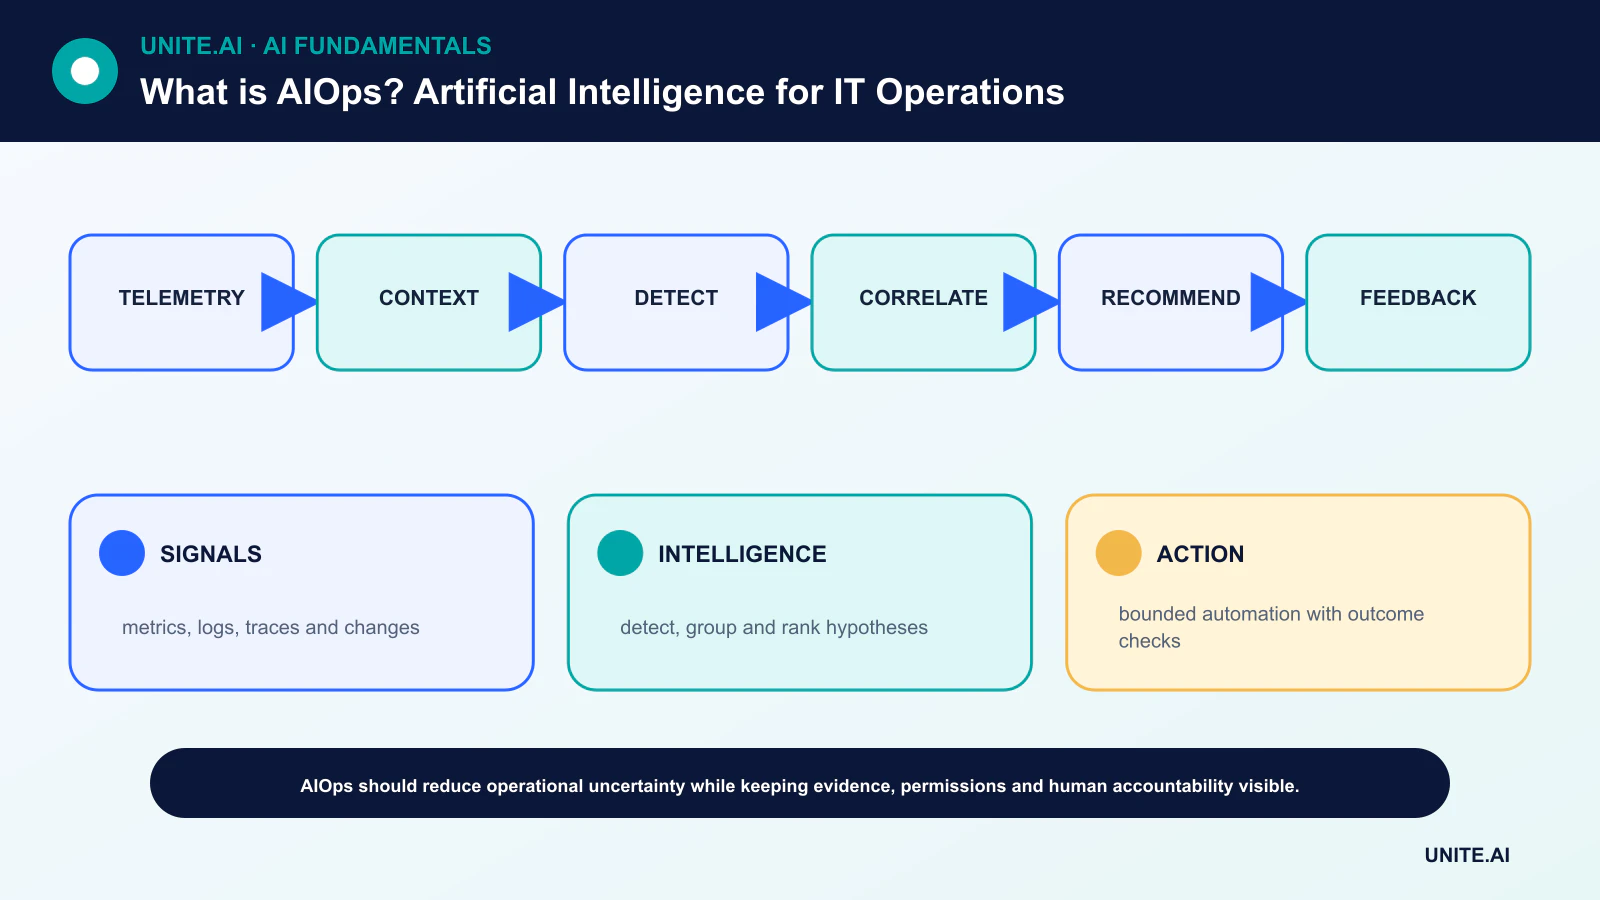
AIOps anvender maskinlæring og automatisering på data fra IT-drift, så teams kan opdage usædvanlig adfærd, reducere dublerede alarmer, forbinde relaterede hændelser, rangere sandsynlige årsager og anbefale eller udføre responshandlinger.
AIOps er ikke en autonom erstatning for driften. Det er et lag inden i et ITOps-system, og dets værdi afhænger af telemetrisk kvalitet, service-topologi, ændringshistorik, menneskelig feedback og sikre automatiseringsgrænser.
Vigtige pointer
- Normaliser hændelser og tilføj servicekontekst, før du anvender avancerede modeller.
- Anomalidetektion identificerer afvigelser, men nødvendigvis ikke fejl eller grundårsager.
- Korrelation og rangering af sandsynlige årsager bør fremvise beviser og usikkerhed.
- Automatiseret afhjælpning kræver mindst mulige rettigheder, godkendelser, kanariefugle, rollback og overvågning af resultater.
Opbyg et operationelt datalag
AIOps-platforme indsamler metrik, logfiler, spor, alarmer, tickets, topologi, implementeringer og konfigurationsændringer. Tidsstempler, identifikatorer og serviceejerskab skal afstemmes, så systemet kan forbinde signaler, der refererer til den samme hændelse.
Manglende eller inkonsistent kontekst forårsager falske korrelationer. Dataopbevaring, adgang og privatliv er også vigtigt, da logfiler kan indeholde legitimationsoplysninger eller personlige data. Anvend den samme styring som forventes af andre produktionsdatabaser.
Detektion og støjreduktion
Statiske tærskler fungerer for kendte grænser; statistiske og maskinlærings-metoder kan modellere sæsonvariationer eller multivariate mønstre. Deduplikering grupperer gentagne notifikationer, mens undertrykkelse fjerner alarmer, der ikke er handlingsbare under definerede regler.
En anomalie er kun en afvigelse fra forventet adfærd. Planlagte udgivelser, trafikkampagner og forretningscyklusser kan være usædvanlige men sunde. Vurder præcision, recall, detektionsforsinkelse og operatørbelastning i stedet for at fejre antallet af fjernede alarmer.
Korrelation og sandsynlig årsag
Hændelseskorrelation forbinder symptomer på tværs af en afhængighedsgraf og tidsvindue. En sandsynlig-årsagsmodel kan rangere komponenter eller nylige ændringer, der kan forklare hændelsen. Dette prioriterer undersøgelsen; det fastslår ikke årsagssammenhæng.
Vis bidragende beviser, alternative hypoteser og sikkerhed. Forklarbar AI er især vigtig, når en operatør skal beslutte, om en service skal isoleres eller en implementering rulles tilbage.
Fra anbefaling til automatisering
En runbook kan indsamle diagnostik, genstarte en tilstandsløs worker eller skalere kapacitet. Copilots kan opsummere hændelser og hente procedurer. Agenter kan planlægge værktøjskald, men produktionsrettigheder bør være snævre, og handlinger skal valideres mod den aktuelle tilstand.
Start med kun-læse-anbefalinger. Fremhæv modne handlinger gennem simulering, menneskelig godkendelse, kanariefugle og automatisk rollback. Registrer input, modelversion, autorisation og resultat for hver handling.
Evaluering og operationel feedback
Afspil historiske hændelser uden at lække deres endelige etiketter ind i funktioner. Test på nye tjenester og ændringer, mål falsk undertrykkelse, tid til at opdage, tid til at afbøde, operatøraccept og gentagelse. Sammenlign med eksisterende regler og simple baseline-modeller.
Drift opstår, når arkitektur, trafik eller responspraksis ændres. Luk kredsløbet ved at lade operatører rette korrelationer og resultater, og gennemgå derefter om systemet reducerer trivsel uden at skjule risiko eller skabe automatiseringsselvtilfredshed.
AIOps-data og analytisk pipeline
AIOps anvender statistiske og maskinlæringsmetoder på driftsdata såsom metrik, logfiler, spor, hændelser, topologi, tickets og ændringer. Pipelines indsamler og normaliserer signaler, beriger dem med service- og ejerskabskontekst, opdager anomalier, korrelerer relaterede hændelser, estimerer sandsynlige årsager og anbefaler eller udløser handling. Kvaliteten afhænger af tidsstempler, identifikatorer, topologi og ændringsregistre. En sofistikeret model kan ikke pålideligt korrelere alarmer, der refererer til den samme service under inkonsistente navne.
Anomalidetektion lærer baseline pr. service, sæson og driftstilstand; statiske tærskler kan være bedre for kendte sikkerhedsgrænser. Hændelseskorrelation grupperer symptomer til en hændelse ved hjælp af tid, topologi, tekst og historiske mønstre. Rangering af grundårsag foreslår hypoteser, men kan forveksle den første observerede fejl med den egentlige årsag eller overse en fælles afhængighed, der mangler i topologien. Opsummeringer på naturligt sprog kan hjælpe responderende, men skal linke til rå beviser og angive usikkerhed.
Automatisering, evaluering og feedback
Start med beslutningsstøtte og lavrisiko reversibel afhjælpning. Hver automatiseret handling kræver autorisation, forudsætninger, begrænset omfang, timeout, efterbetingelsesverificering, rollback og en revisionsspor. Modellen må ikke give sig selv legitimationsoplysninger eller behandle logtekst som betroede instruktioner. Menneskelige responderende bør acceptere, afvise eller korrigere anbefalinger, og disse resultater bør opdatere regler eller træningsdata gennem gennemgang i stedet for ukontrolleret selvlæring.
Evaluer alarmreduktion uden at gå glip af hændelser, detektionsforsinkelse, korrelationspræcision, rangering af grundårsag, afhjælpningssucces, genoprettelsestid, gentagelse og responderbelastning. Brug historisk afspilning og indsprøjtede fejl, men tag højde for ufuldstændige hændelsesetiketter. Mål pr. service og hændelsestype; et gennemsnit kan skjule farlige fejl i sjældne kritiske systemer. Sammenlign med deterministiske regler og forbedret observabilitet før du tilføjer AI-kompleksitet.
Styring og fejlsituationer
AIOps kan forstærke telemetrisk huller, automatisere en forkert diagnose eller skabe korrelerede handlinger på tværs af hele flåden. Isoler miljøer, begræns samtidighed, vedligehold en kill-switch uden for modellen, og øv fejlsituationer for AIOps-platformen selv. Beskyt logfiler og tickets, der indeholder hemmeligheder eller personlige data. Overvåg modeldrift, topologifrished, falske handlinger og overstyringer. AIOps understøtter pålidelig drift, når det gør beviser og afgrænsede handlinger hurtigere; det er ikke en autonom erstatning for serviceejerskab, hændelseskommando eller teknisk dømmekraft.
Praktisk eksempel: AIOps for en betalingshændelse
AIOps grupperer en bølge af API-fejl, databaseoverbelastning og regionale alarmer til én hændelse og beriger den med en nylig implementering, topologi og ejer. Den rangerer implementeringen som en sandsynlig bidragsyder, men viser rå telemetri og alternativer. En deterministisk politik pauser yderligere udrulning; en menneskelig hændelseskommandør godkender trafikskift efter at have kontrolleret, at kapacitet og datakonsistens er sikre.
Systemet måler gruppens præcision, detektionsforsinkelse, rangeringens nøjagtighed, responderaccept, genoprettelse og falsk afhjælpning i historisk afspilning og øvelsesdage. Alle automatiserede handlinger har begrænsninger, idempotens, efterbetingelseskontrol og rollback. Logfiler renses, og ondsindet tekst kan ikke blive til en kommando. Efter hændelsen opdaterer den bekræftede årsag og handlingsresultater gennemgåede regler og evalueringsdata. AIOps-platformen assisterer med beviser og koordinering; den erstatter aldrig hændelseskommando eller ekstern autorisation.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsebetingelser, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underbetjent. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latency, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne beviser fra en attraktiv prototype.
Før lancering skal der tildeles myndighed til udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model- eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmtærskler og en responsansvarlig, og gennemgå derefter realverdensbeviser efter implementering i stedet for at antage, at offline‑præstationen vil vedvare. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er AIOps det samme som observabilitet?
Nej. Observabilitet leverer og udforsker systemsignaler; AIOps bruger analyse og automatisering på disse signaler. Hver kan eksistere uden den anden.
Kan AIOps automatisk bestemme grundårsagen?
Den kan rangere hypoteser og indsamle beviser, men årsagspåstande kræver topologi, ændringskontekst og validering. Mange hændelser har samvirkende årsager.
Primære referencer