Grundlæggende AI
Hvad er forklarlig AI?

 Føj Unite.AI til dine foretrukne kilder på Google
Forklarlig AI (XAI) omfatter metoder og praksisser, der hjælper folk med at forstå en AI-systems adfærd eller output. En forklaring kan beskrive indflydelsesrige input, vise et lignende eksempel, præsentere en kontrafaktisk ændring, opsummere en global regel eller kommunikere, når systemet ikke ved.
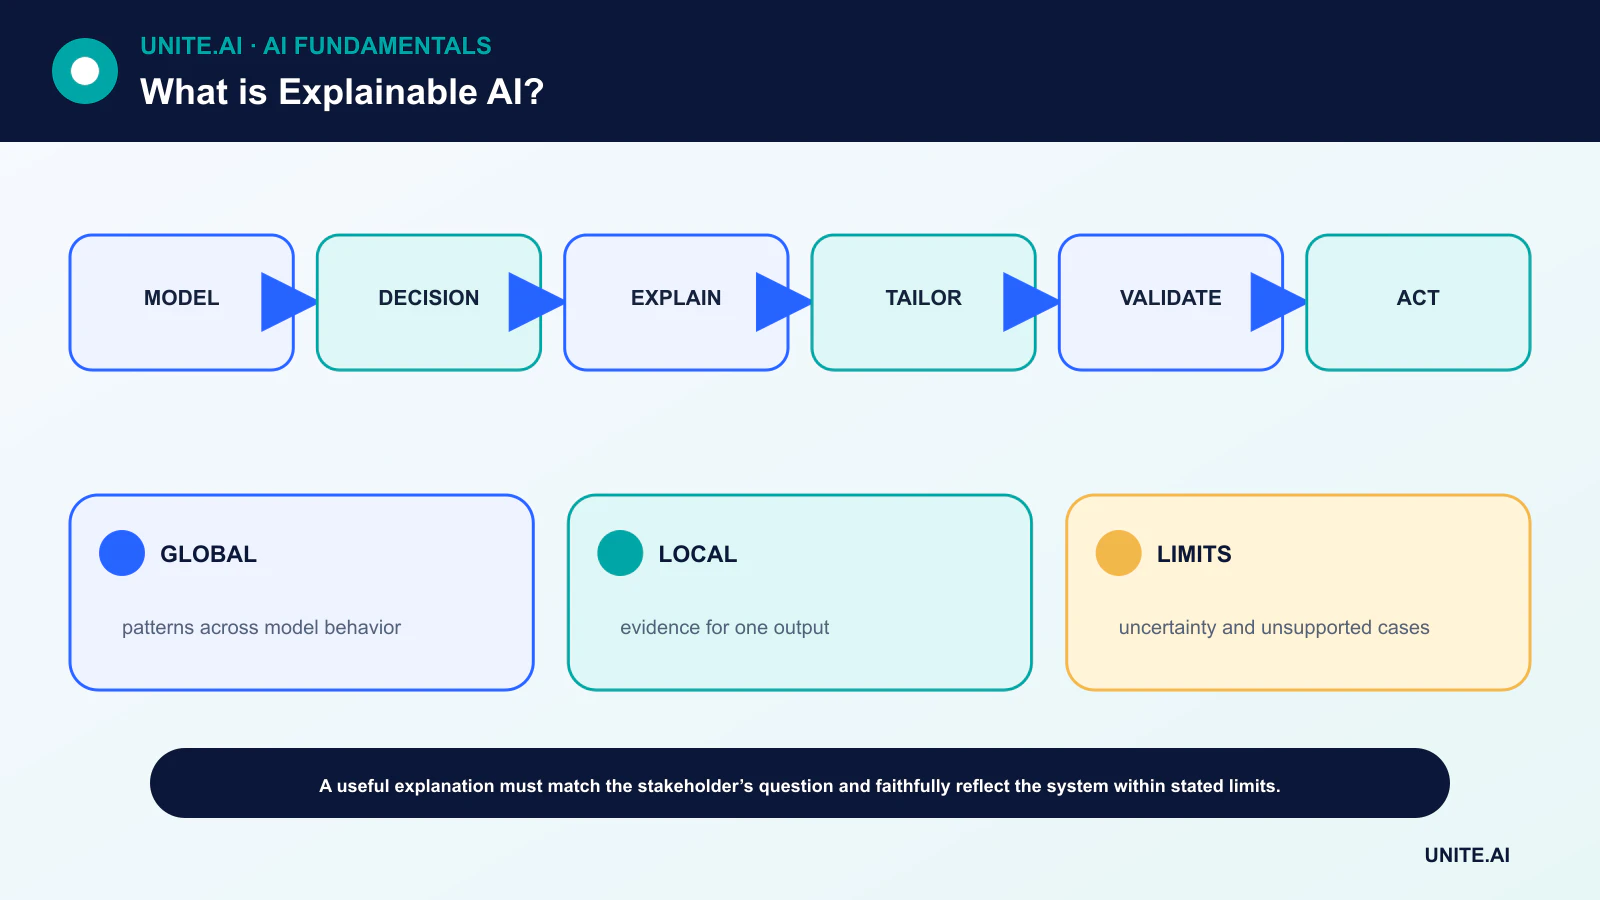
Ingen forklaring er universelt bedst. En udvikler, der fejlsøger en model, en revisor, der tester overholdelse af politik, og en person, der påvirkes af en beslutning, har brug for forskellige beviser. Forklaringer skal derfor evalueres for nøjagtighed, mening og tiltænkt brug – ikke kun visuel appel.
Vigtige pointer
- Gennemsigtighed beskriver tilgængelig information; fortolkelighed vedrører mening; forklaring kommunikerer beviser eller årsager.
- Globale metoder opsummerer en model, mens lokale metoder adresserer én forudsigelse eller et lille område.
- Post-hoc-forklaringer kan være nyttige, men kan være ustabile eller uærlige i forhold til den underliggende model.
- En forklaring beviser ikke retfærdighed, kausalitet, robusthed eller korrekthed.
Fire principper for brugbare forklaringer
NIST foreslår, at et system leverer en forklaring, gør den meningsfuld for den tiltænkte bruger, sikrer at den nøjagtigt afspejler systemets proces, og kommunikerer dets vidensbegrænsninger. Disse principper adskiller eksistensen af en forklaring fra dens kvalitet.
Mening er publikumsafhængig. En kort begrundelseskode kan hjælpe en ansøger, mens en modeludvikler kan have brug for fordelinger, funktioners opførsel og fejlklynger. Begge bør knyttes til det samme dokumenterede system og beslutningskontekst.
Intrinsiske og post-hoc metoder
En sparsom lineær model eller en begrænset decision tree kan være direkte fortolkelig inden for sit gyldige område. En kompleks model kan i stedet anvende post-hoc-funktionsattribution, en lokal surrogat, eksempler, saliencymaps eller kontrafaktiske forklaringer.
Intrinsisk enkelhed er ikke automatisk troværdig, når funktioner er dårligt definerede eller pipeline er skjult. Post-hoc-kompleksitet er ikke automatisk vildledende. Metoden skal testes mod det spørgsmål, den er tiltænkt at besvare.
Funktionattribution og korrelerede input
Attributionsmetoder tildeler dele af et output til inputfunktioner under eksplicitte antagelser. LIME tilpasser en simpel lokal surrogat omkring en forudsigelse; SHAP-relaterede metoder forbinder additive attributioner med Shapley‑værdikonceptet.
Korrelerede funktioner kan dele eller udveksle attribution, og en høj attribution er ikke en kausal effekt. At ændre en funktion isoleret kan skabe en umulig person, billede eller transaktion. Forklaringer bør angive deres baseline, sampling og afhængighedsantagelser.
Kontrafaktiske forklaringer, eksempler og global adfærd
En kontrafaktisk forklaring spørger, hvilken gennemførlig ændring der ville ændre et resultat. Begrænsninger er essentielle: en handlingsorienteret forklaring bør ikke anbefale uforanderlige, ulovlige eller urealistiske ændringer. Eksempeldrevne metoder viser prototyper eller indflydelsesrige træningssager, men kan afsløre private data.
Global analyse undersøger ydeevne, delvis afhængighed, monotonicitet, interaktioner og undergruppeadfærd. For ensembles såsom gradient boosting kombineres opsummeringer med lokal evidens og direkte tests af forventede begrænsninger.
Valider forklaringen og systemet
Test troværdighed, stabilitet under små forstyrrelser, konsistens på tværs af ækvivalente input, brugerforståelse og om forklaringen understøtter en passende beslutning. Adversarietests bør undersøge, om en overbevisende forklaring kan ledsage et forkert eller manipuleret output.
XAI indgår i en bredere evaluering: hold-out kvalitet, kalibrering, retfærdighed, privatliv, sikkerhed, overvågning og klageprocedurer. En forklaring kan understøtte ansvarlighed, men kan ikke erstatte ansvarlig styring.
Forklaringsmål og metodefamilier
Forklarlig AI bør starte med et spørgsmål og en målgruppe: hvorfor en beslutning indtraf, hvordan modellen generelt opfører sig, hvilke beviser der påvirkede den, hvad der ville ændre resultatet, eller om en politik blev fulgt. Lokale forklaringer adresserer én forudsigelse; globale forklaringer opsummerer bredere adfærd. Intrinsisk fortolkelige modeller afslører koefficienter, regler eller strukturer, mens post-hoc metoder tilnærmer komplekse modeller. En forklaring af modelens adfærd er ikke automatisk en kausal forklaring på verden eller en begrundelse for, at en beslutning er retfærdig.
Funktionattributionsmetoder omfatter gradienter, integrerede gradienter, SHAP‑lignende værdier, permutation og lokale surrogatmodeller. Eksempeldrevne forklaringer henter indflydelsesrige eller lignende sager; kontrafaktiske foreslår ændringer, der er forbundet med et andet output; konceptmetoder relaterer interne repræsentationer til menneskelige kategorier. Hver har antagelser om baselines, funktionuafhængighed, lokal linearitet eller modeladgang. Korrelerede variable, interaktioner og forbehandling kan gøre attributioner ustabile eller vildledende. Sammenlign metoder og forstyr input for at teste, om en forklaring forudsiger adfærd.
Evaluering og menneskelige faktorer
Evaluer troværdighed – om forklaringen svarer til modellen – separat fra plausibilitet for en person. Test stabilitet, følsomhed, fuldstændighed, sparsitet og nytte for en defineret opgave såsom fejlsøgning eller appel. Menneskelige studier kræver repræsentative deltagere og bør måle beslutningskvalitet, fejlopdagelse, tillid og tid, ikke om brugerne siger, at et diagram ser klart ud. En overbevisende forklaring kan øge tilliden til en forkert model, så grænseflader skal vise usikkerhed, alternativer og begrænsninger.
Kontrafaktiske forklaringer bør være gennemførlige, handlingsorienterede og ikke anbefale ændring af beskyttede eller uforanderlige egenskaber. Forklaringer kan lække model‑ eller personlige oplysninger og hjælpe angribere med at reverse engineer beslutninger. Anvend adgangskontrol og output‑minimering. For regulerede eller høj‑impact anvendelser, bevar data‑proveniens, modelversion, tærskel og den faktiske beslutningslogik; en generisk funktion‑vigtighedsgrafik kan ikke erstatte en juridisk meningsfuld begrundelse eller menneskelig gennemgang.
Brug af forklaringer på en ansvarlig måde
Vælg den simpleste model, der opfylder præstations‑ og driftsbehov, men ofr ikke gyldighed for overfladisk fortolkelighed. Kombinér forklaringer med undergruppe‑testning, robusthedstjek, kausal analyse hvor relevant, og resultat‑overvågning. Dokumentér den tiltænkte målgruppe og ugyldige slutninger. Hvis en forklaring ændrer sig efter en harmløs forstyrrelse, undersøg det før implementering. Forklarlighed er bevis om et system under en metode; den er værdifuld for fejlsøgning, tilsyn og kommunikation, men den certificerer ikke sandhed, retfærdighed, sikkerhed eller forståelse.
Eksempel: Forklaring af en kredit‑risikomodel
En långiver definerer først målgruppen og det nødvendige begrundelse: ansøgere har brug for præcise beslutningsfaktorer og en korrigeringsvej, mens udviklere har brug for diagnostik. En kalibreret fortolkelig baseline sammenlignes med en boosted model. Lokale attributioner, kontrafaktiske forklaringer og global fejlanalyse testes for troværdighed, stabilitet, korreleret‑funktion‑adfærd og nytte. Forklaringer kan ikke anbefale ændring af alder, handicap eller en anden uforanderlig egenskab, og de præsenteres ikke som kausale effekter.
Produktions‑beslutningsjournalen bevarer kilde‑data, funktionstransformation, model, tærskel, politik og menneskelig handling. Ansøgere kan udfordre ukorrekte data og modtage en meningsfuld gennemgang. Overvågning kontrollerer resultat‑ og forklaringsstabilitet på tværs af grupper og modelopdateringer. Hvis en plausibel forklaring ændrer sig under en harmløs funktions‑forstyrrelse eller udelader en afgørende politikregel, stoppes implementeringen. Forklarlighed supplerer validering og proceduremæssige rettigheder; den fritager ikke for et ugyldigt mål, diskriminerende resultater eller mangel på ansvarlig menneskelig myndighed.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, randbetingelser, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug samt de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløbshastighed, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed til udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre inputkvalitet, output‑adfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en responsansvarlig, og gennemgå real‑world beviser efter implementering i stedet for at antage, at offline‑ydelse vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret gendannelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er opmærksomhedskort forklaringer?
De kan fungere som diagnostiske signaler, men opmærksomhedsvægte alene garanterer ikke en trofast gengivelse af årsagerne til en models output.
Kræver forklarlig AI en simpel model?
Ikke altid. Komplekse modeller kan analyseres med post-hoc‑metoder, men disse forklaringer kræver uafhængig validering og tydeligt angivne begrænsninger.
Primære referencer