Grundlæggende AI
Hvad er en forvirringsmatrix?

 Føj Unite.AI til dine foretrukne kilder på Google
En forvirringsmatrix er en tabel, der tæller hvor ofte en klassifikators forudsigelser stemmer overens med eller afviger fra kendte mærkater. Den viser, hvilke klasser der forveksles, og giver de tællinger, der bruges til at beregne metrikker såsom præcision, recall, specificitet og F1. Den er et af de centrale diagnostiske værktøjer til overvåget læring klassifikationsproblemer.
Matriksen i sig selv er ikke en enkelt præstationsscore. Den er en struktureret visning af udfald ved en bestemt beslutningstærskel, datasæt og klassedefinition.
Vigtige pointer
- For binær klassifikation er de fire udfald sand positiv, falsk positiv, falsk negativ og sand negativ.
- Marker altid akserne: biblioteker og publikationer placerer ikke altid de faktiske og forudsagte klasser i samme orientering.
- Nøjagtighed kan skjule alvorlige fejl, når klasser er ubalancerede.
- Ændring af klassifikationstærsklen ændrer forvirringsmatriksen og afvejningen mellem præcision og recall.
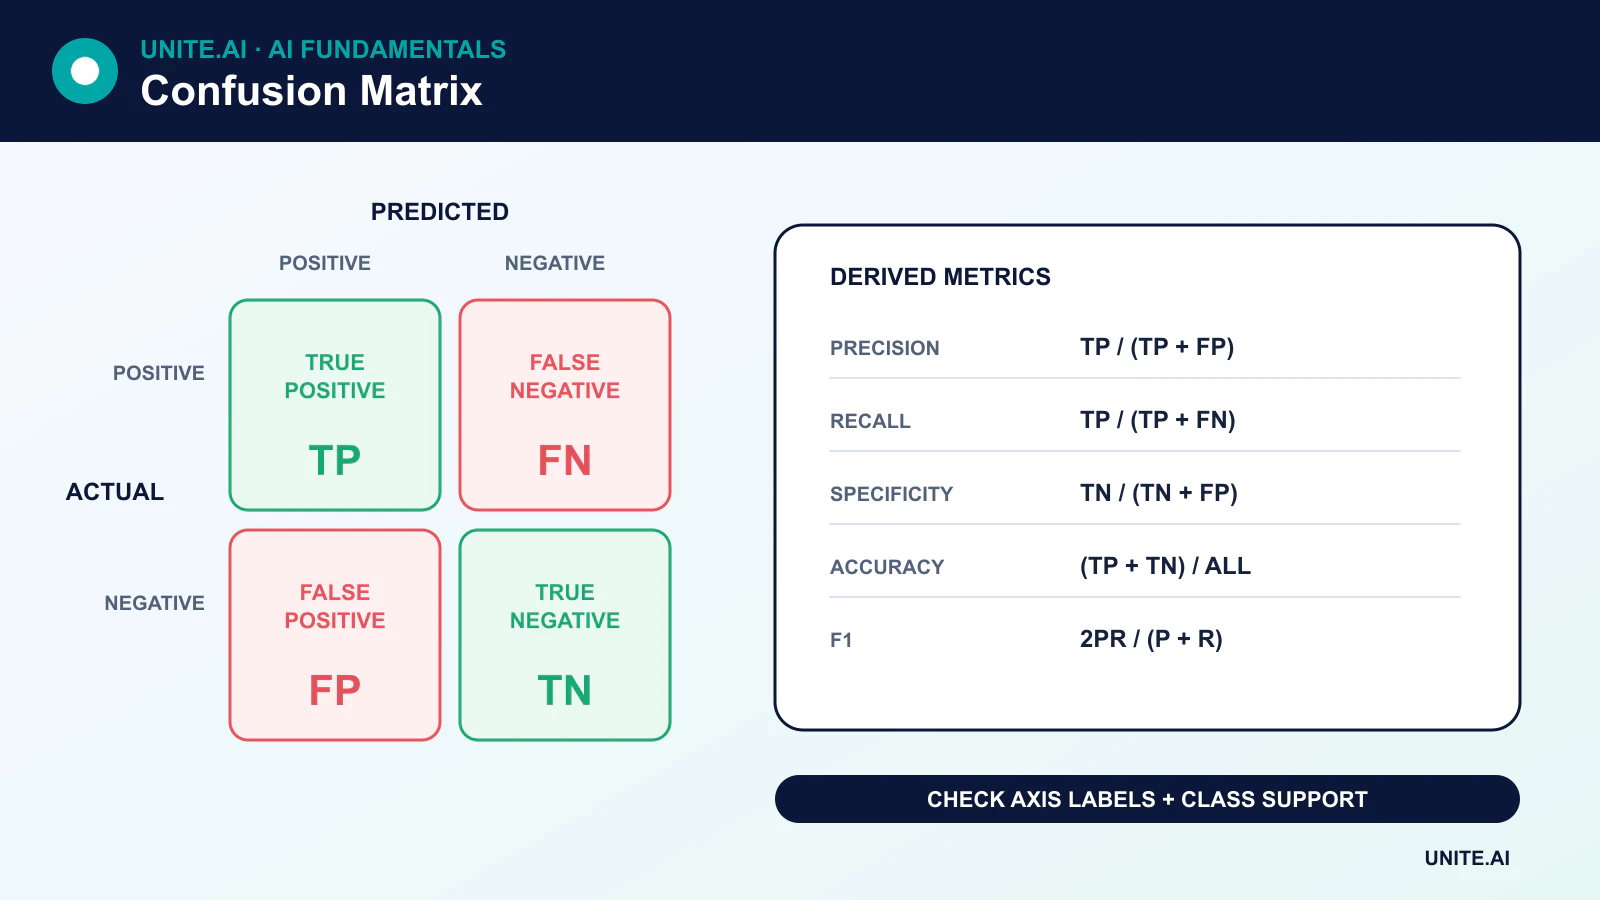
De fire binære klassifikationsudfald
- Sand positiv (TP): eksemplet er positivt, og modellen forudsiger positivt.
- Falsk positiv (FP): eksemplet er negativt, men modellen forudsiger positivt.
- Falsk negativ (FN): eksemplet er positivt, men modellen forudsiger negativt.
- Sand negativ (TN): eksemplet er negativt, og modellen forudsiger negativt.
I scikit-learn’s konvention er rækker de sande klasser og kolonner de forudsagte klasser. Andre visualiseringer kan transponere denne opsætning, så etiketterne – ikke hjørnepositionerne – bør guide fortolkningen.
Metrikker udledt fra en forvirringsmatrix
Præcision
Precision = TP / (TP + FP)
Præcision svarer på: blandt de eksempler, der er forudsagt som positive, hvilken andel var faktisk positive?
Recall eller sensitivitet
Recall = TP / (TP + FN)
Recall svarer på: blandt alle faktiske positive eksempler, hvilken andel identificerede modellen? I binær klassifikation kaldes recall for den positive klasse også sensitivitet eller sand-positiv-rate.
Specificitet
Specificity = TN / (TN + FP)
Specificitet er recall for den negative klasse: blandt faktiske negative, hvilken andel afviste modellen korrekt?
Nøjagtighed
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Nøjagtighed er nyttig, når klasser og fejlkostnader er rimeligt afbalancerede. Den kan være vildledende, når én klasse dominerer.
F1‑score
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1‑score sammenfatter præcision og recall med et harmonisk gennemsnit. Den ignorerer sande negative, så den er ikke den rette opsummering for enhver opgave.
Et gennemarbejdet eksempel
Lad os antage, at et testdatasæt indeholder 1.000 transaktioner. Halvtreds er svigagtige. En model finder 40 af disse svindel, men markerer 30 legitime transaktioner:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Modellen har 96 % nøjagtighed, men dens præcision er omkring 57 % og recall 80 %. Den høje nøjagtighed skyldes i høj grad de mange legitime transaktioner. Om modellen er acceptabel afhænger af omkostningerne ved overset svindel, efterforskningskapacitet og hvor godt dens risikoscores er kalibreret.
Tærskler ændrer matricen
Mange klassifikatorer giver en score i stedet for et uundgåeligt ja/nej-svar. Sænkning af den positive tærskel øger typisk recall og falske positiver; hævning af den øger typisk præcision eller specificitet, mens flere positive går tabt. Tærsklen bør vælges ved hjælp af valideringsdata og reelle fejlkostnader, ikke automatisk fastsat til 0,5.
Precision‑recall‑ og ROC‑kurver opsummerer præstationen på tværs af tærskler. Precision‑recall‑kurver er ofte mere informative, når den positive klasse er sjælden.
Multiklasse‑forvirringsmatrikser
For K klasser er matricen K × K. Korrekte forudsigelser ligger på diagonalen; celler uden for diagonalen viser, hvilke klassepar der forveksles. Per‑klasse‑metrikker kan gennemsnitsberegnes på forskellige måder:
- Makro‑gennemsnit: giver hver klasse lige vægt.
- Vægtet gennemsnit: vægter hver klasse efter antallet af eksempler.
- Mikro‑gennemsnit: aggregerer udfaldstællinger før beregning af metrikken.
Kun at rapportere ét gennemsnit kan skjule dårlig præstation på mindre klasser. Medtag support‑tællinger og per‑klasse‑resultater, hvor forskellene er vigtige.
Almindelige fejl
- At læse en transponeret matrix uden at tjekke akseetiketter.
- At beregne metrikker fra træningsdata i stedet for et passende hold‑out‑sæt.
- At ignorere klassens forekomst, udtagningsstrategi eller dublerede enheder på tværs af split.
- At sammenligne matricer genereret ved forskellige tærskler uden at bemærke ændringen.
- At behandle alle falske positiver og falske negativer som lige omkostningsfulde.
En forvirringsmatrix er derfor et diagnostisk værktøj, ikke en fuldstændig evaluering. Kalibrering, undergruppeanalyse, robusthed og nedstrøms konsekvenser hører også til i en klassifikationsgennemgang.
Læsning af hver celle og udledning af nyttige metrikker
For binær klassifikation tæller forvirringsmatricen sande positiver, falske positiver, falske negativer og sande negativer for en valgt positiv klasse og tærskel. Nøjagtighed dividerer korrekte forudsigelser med alle tilfælde; præcision spørger, hvilken andel af de forudsagte positive der var korrekte; recall spørger, hvilken andel af de faktiske positive der blev fundet; specificitet måler de faktiske negative, der korrekt blev afvist. F1 er det harmoniske gennemsnit af præcision og recall. Ingen er per definition bedst: svindelkontrol, medicinsk triage og spam‑filtrering tilskriver forskellige konsekvenser til de samme celler.
For multiklasse‑problemer repræsenterer rækker typisk faktiske klasser og kolonner forudsagte klasser, selvom konventionerne varierer, så etiketter skal være eksplicitte. One‑vs‑rest‑tællinger giver per‑klasse‑præcision og recall. Makro‑gennemsnit vægter klasser lige; mikro‑gennemsnit aggregerer beslutninger og favoriserer hyppige klasser; vægtet gennemsnit følger klassens support. Multilabel‑opgaver tillader flere etiketter pr. element og kræver label‑vise eller prøve‑vise definitioner. Normaliser efter rækker for at inspicere recall‑mønstre eller efter kolonner for at inspicere forudsigelses‑sammensætning, men behold råtællinger så sjældne grupper ikke overdrives visuelt.
Tærskler, usikkerhed og operationelle beslutninger
En forvirringsmatrix opsummerer hårde beslutninger ved én tærskel. Brug precision‑recall‑ eller ROC‑kurver til at sammenligne tærskler, og vælg derefter et drifts‑punkt ud fra kapacitet, forekomst og fejlkostnad. Kalibrering spørger, om de forudsagte sandsynligheder matcher den observerede frekvens og er adskilt fra rangering. Når forekomsten ændres, kan præcisionen ændre sig, selvom sensitivitet og specificitet forbliver stabile. Rapporter konfidensintervaller eller bootstrap‑variation, og undgå at drage konklusioner ud fra et håndfuld fejl i en lille undergruppe.
Gennemgå matricer efter tid, sted, enhed, sprog og relevante berørte grupper for at finde koncentrerede fejl. Sammenlign modellen med den eksisterende beslutningsproces, inklusive menneskelig gennemgang. For kæder skal fejl registreres på hvert trin: hentning, klassifikation, tærskling og handling. Overvåg live‑resultat‑etiketter med deres forsinkelse og korrigeringsproces. En tilsyneladende forbedret F1 kan stadig øge skadelige falske negativer eller overstige gennemgangskapaciteten. Forvirringsmatricen er en beslutningsbog; forbind hver celle med den, der oplever fejlen, og hvilken respons der følger.
Gennemarbejdet eksempel: valg af tærskel for medicinsk screening
En maskinlærings-screeningsmodel udgiver en risikoscore for en tilstand med lav forekomst. Teamet laver forvirringsmatricer på tværs af tærskler og rapporterer sensitivitet, specificitet, præcision, falske henvisninger og oversete tilfælde med konfidensintervaller. Da positiv prædiktiv værdi afhænger af forekomsten, modellerer den den tilsigtede population i stedet for at citere én datasæts præcision. Resultaterne segmenteres efter enhed, sted, alder, køn og andre klinisk begrundede grupper.
Klinikere vælger et drifts‑punkt, der bevarer den nødvendige sensitivitet uden at overbelaste bekræftende testning. Matricen omsættes til forventede tællinger pr. 10.000 screenede personer, så konsekvenserne er forståelige. Scores uden for validerede betingelser giver ingen automatiseret konklusion. Overvågning sammenligner forudsigelser med forsinkede bekræftede diagnoser, sporer kapacitet og kalibrering, og udløser gennemgang, når forekomsten eller indsamlingen ændres. Forvirringsmatricen forbliver knyttet til den præcise model, tærskel og population.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt inden finjustering. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latency, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der udpeges myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmtærskler og en ansvarlig for respons, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Hvad er en normaliseret forvirringsmatrix?
Normalisering dividerer tællinger med den sande‑klasse‑total, den forudsagte‑klasse‑total eller alle observationer. Det gør rater lettere at sammenligne på tværs af klasser, men rapporten bør også bevare de rå support‑tællinger, så små grupper ikke forveksles med lige så store.
Kan en forvirringsmatrix evaluere regression?
Ikke direkte. En forvirringsmatrix kræver diskrete klasser. At opdele et kontinuert mål i intervaller kasserer information; regression bør normalt bruge residualanalyse og metrikker designet til kontinuerlige værdier, såsom MAE eller RMSE.
Primære referencer