
Grundlæggende AI
Hvad er et beslutningstræ?

 Føj Unite.AI til dine foretrukne kilder på Google
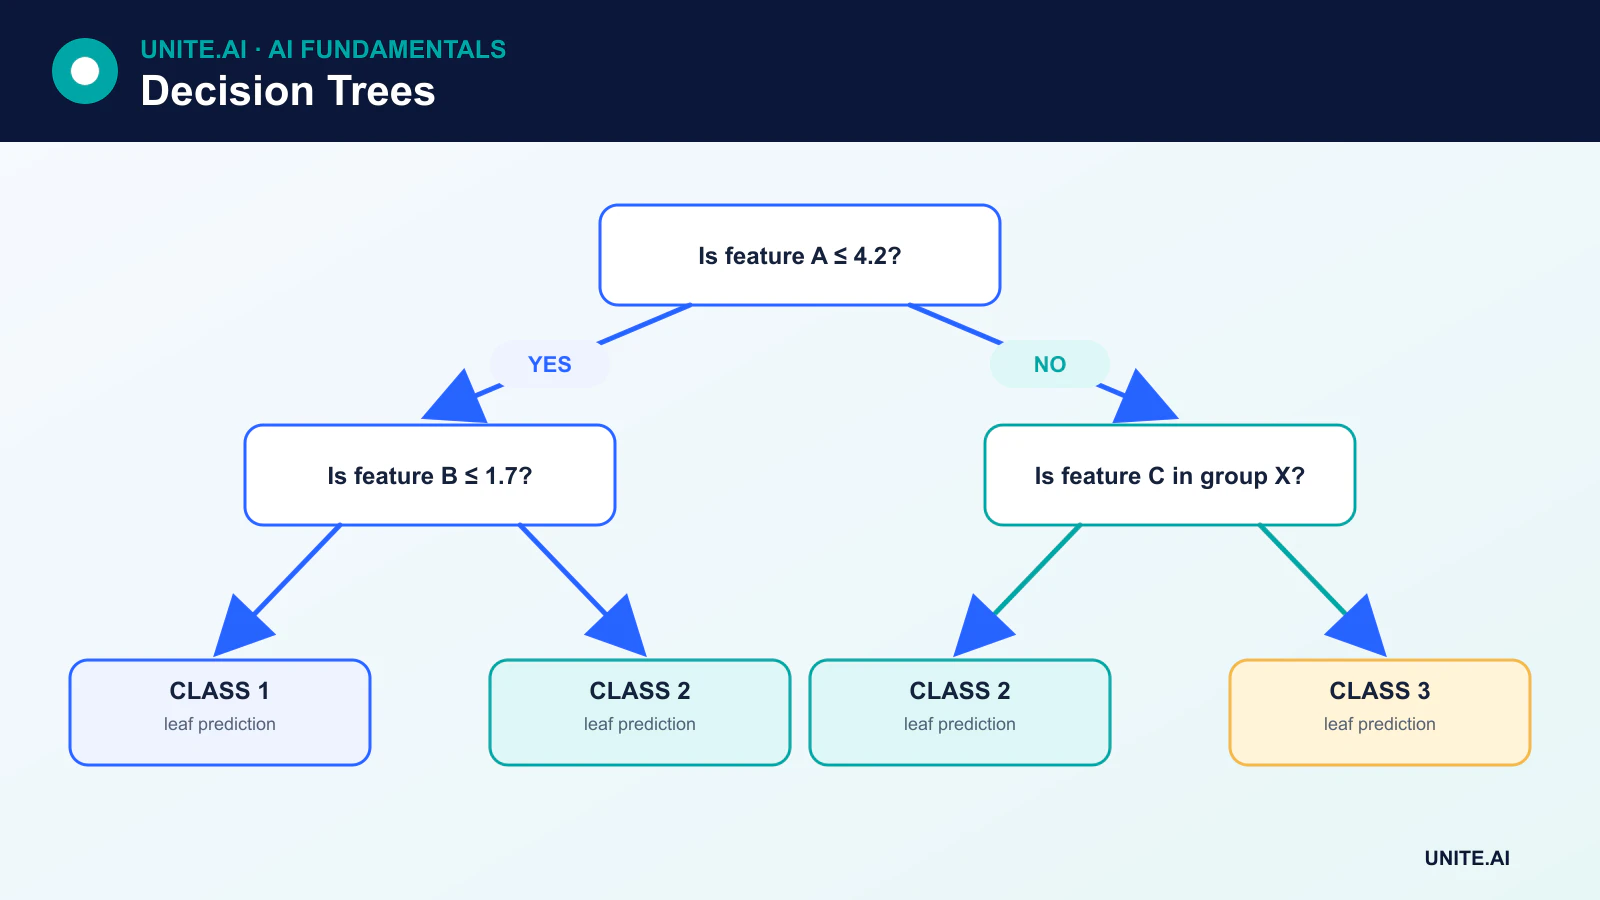
Et beslutningstræ er en superviseret‑læringsmodel, der foretager en forudsigelse ved at anvende en sekvens af hvis‑så‑regler. Hvert internt knudepunkt tester en funktion, hver gren repræsenterer udfaldet af denne test, og hvert blad producerer en klasseforudsigelse, sandsynlighed eller numerisk værdi.
Beslutningstræer bruges til klassifikation og regression. Deres tiltrækningskraft er praktisk: de kan repræsentere ikke‑lineære interaktioner, kræver relativt lidt forbehandling og giver en sti, som en person kan inspicere. Deres svaghed er ustabilitet – små ændringer i træningsdata kan skabe et andet træ.
Vigtige pointer
- Et træ opdeler rekursivt funktionsrummet; det behøver ikke isolere hver træningsobservation.
- Klassifikations‑opdelinger bruger typisk Gini‑impuritet eller entropi, mens regressions‑opdelinger reducerer forudsigelsesfejl eller varians.
- Dybde, minimum bladstørrelse og beskæring styrer kompleksitet og overfitting.
- Random forests og gradient‑boostede træer forbedrer den forudsigende kraft ved at kombinere mange træer.
Sådan laver et beslutningstræ en forudsigelse
Antag, at en model forudsiger, om en maskine sandsynligvis vil fejle. Rodknuden kan spørge, om vibrationerne overstiger en lærte tærskel. En gren kan derefter teste driftstemperaturen. Observationen når et blad, der indeholder den estimerede fejl‑sandsynlighed blandt trænings‑eksempler, som fulgte den samme sti.
For regression kan bladet returnere den gennemsnitlige mål‑værdi for observationerne i den region. For klassifikation kan det returnere majoritetsklassen eller en fordeling af klasse‑frekvenser. Et blad kan indeholde mange observationer; at adskille træningsdata fuldstændigt er som regel uønsket, fordi det kan producere et over‑fit træ.
Sådan vælger et træ en opdeling
Træningen overvejer kandidat‑funktioner og tærskler og vælger derefter den opdeling, der mest forbedrer et defineret mål. Forbedringen skal vægtes efter hvor mange observationer, der går til hvert barn‑knudepunkt.
Gini-impuritet
For klassifikation måler Gini‑impuritet, hvor blandede klasserne er i et knudepunkt:
Gini = 1 - Σ p(k)²
Et knudepunkt, der kun indeholder én klasse, har impuritet nul. En kandidat‑opdeling er nyttig, når den vægtede impuritet af dens børn er lavere end forældrenes impuritet.
Entropi og informationsgevinst
Entropi er et andet mål for klasseusikkerhed:
Entropy = -Σ p(k) log₂ p(k)
Informationsgevinst er forælder‑entropi minus den vægtede børne‑entropi. Gini og entropi giver ofte lignende træer, selvom de ikke altid er identiske.
Regresions‑tab
Regressions‑træer vælger typisk opdelinger, der reducerer kvadreret fejl, absolut fejl eller et andet regressionskriterium. Hvert blad forudsiger derefter en værdi baseret på trænings‑målene inden for den region.
CART og andre træalgoritmer
CART, eller Classification and Regression Trees, bruger binære opdelinger og ligger til grund for almindelige implementeringer såsom scikit‑learn’s beslutningstræer. Andre algoritmer omfatter ID3, C4.5 og C5.0. Implementeringerne varierer i de understøttede opdelingstyper, håndtering af manglende værdier, beskæring og mål.
Kategoriske variable kan kræve kodning, direkte delmængde‑opdelinger eller implementeringsspecifik håndtering. Manglende værdier kan imputeres eller håndteres gennem lærte standard‑retninger eller surrogat‑opdelinger. Det er vigtigt at forstå den specifikke biblioteks‑adfærd i stedet for at antage, at alle træ‑implementeringer fungerer ens.
Kontrol af trækompleksitet
Et dybt træ kan memorere støj. Almindelige kontroller omfatter:
- Maksimal dybde: begrænser længden af en forudsigelsessti.
- Minimum antal prøver pr. opdeling eller blad: forhindrer meget små regioner.
- Minimum impuritets‑reduktion: kræver, at en opdeling giver tilstrækkelig gevinst.
- Maksimalt antal blade: sætter en grænse for den samlede kompleksitet.
- Cost‑complexity beskæring: fjerner grene, hvis forbedring ikke retfærdiggør den ekstra kompleksitet.
Beskæring er en struktureret optimeringsproces, ikke tilfældig sletning. Hyperparametre bør vælges med valideringsdata eller kryds‑validering, mens det endelige test‑sæt forbliver urørt.
Styrker og begrænsninger
Beslutningstræer kan modellere interaktioner og tærskel‑effekter uden funktions‑skalering. De accepterer numeriske og, afhængigt af implementeringen, kategoriske input. Forudsigelsen er hurtig, og et lille træ er let at visualisere.
Dog kan et enkelt træ have høj varians, skabe pludselige forudsigelses‑ændringer nær en opdeling og favorisere funktioner med mange mulige opdelings‑punkter. Træer extrapolerer også dårligt i regression: uden for de observerede regioner returnerer et blad stadig en værdi lært fra sine trænings‑prøver. Et stort træ er måske ikke mere forståeligt end en anden kompleks model.
Fra ét træ til ensembles
Ensemble‑læring kombinerer flere modeller. En random forest træner mange træer på gen‑samplede observationer og under‑sæt af funktioner og gennemsnitliggør deres forudsigelser. Gradient boosting bygger træer sekventielt, så hvert nyt træ adresserer den resterende fejl. Disse tilgange overgår typisk ét træ, men de går på kompromis med noget fortolkelighed og tilføjer beregningsomkostninger.
Funktions‑vigtighed fra et træ eller ensemble bør fortolkes omhyggeligt. Impuritet‑baseret vigtighed kan være biased, og en funktions vigtighed beviser ikke kausalitet. Permutations‑vigtighed, partial‑dependence‑værktøjer og domæne‑gennemgang giver yderligere kontekst.
Sådan lærer et træ opdelinger og forudsigelser
Et beslutningstræ opdeler rekursivt funktionsrummet. Ved hvert knudepunkt evaluerer en træningsalgoritme kandidat‑funktion‑tærskler eller kategori‑partitioner og vælger den opdeling, der mest reducerer impuritet, såsom Gini‑impuritet eller entropi for klassifikation og kvadreret fejl for regression. Blade gemmer en klassefordeling eller numerisk forudsigelse baseret på trænings‑observationer, der når dem. Grådig opdeling er beregningsmæssigt praktisk, men garanterer ikke det globalt bedste træ, og forskellige prøver eller tie‑breaking kan producere forskellige strukturer.
Kontinuerlige, ordinale, kategoriske og manglende funktioner kræver eksplicit håndtering. One‑hot‑kodning kan skabe mange kandidat‑opdelinger; native‑kategoriske metoder kan bruge ordnede statistikker, men kræver lækage‑sikker implementering. Træer kræver ingen skalering, men de kan favorisere høj‑kardinalitets‑variable og isolere små grupper. Dybde, minimum bladstørrelse, minimum impuritets‑reduktion og cost‑complexity beskæring styrer varians. Vælg dem med valideringsdata og evaluer kalibrering, fordi en blad‑sandsynlighed baseret på få tilfælde kan være ekstrem og ustabil.
Fortolkning, fejlsituationer og produktionsbrug
En sti fra rod til blad er en præcis regel for én model‑forudsigelse, men den er ikke automatisk en kausal forklaring. Korrelerede variable kan erstatte hinanden, små dataændringer kan ændre de øvre opdelinger, og en simpel sti kan afhænge af biased mærkninger. Global funktions‑vigtighed baseret på impuritet kan være misvisende; permutations‑vigtighed, partial‑dependence og kontrafaktiske tjek tilføjer kontekst men har også antagelser. Rapporter usikkerhed og test, om en påstået regel holder på uafhængige data og relevante undergrupper.
Enkelt‑træer er nyttige, når gennemsigtighed, lav latenstid og beskeden ikke‑lineær struktur er vigtige, men ensembles giver typisk stærkere forudsigelses‑præstation. Valider grænse‑adfærd, sjældne kategorier, manglende værdier og input uden for trænings‑intervallet. Eksporterede regler skal reproducere trænings‑forbehandling og numerisk sammenligning præcist. Overvåg blad‑beskæftigelse, output‑fordeling, fejl og nye kategorier. Et træ, der dirigerer mange nye sager ind i en lille eller tidligere tom region, bør udløse en gennemgang, selvom samlet drift‑drift forbliver lille. Hav en fallback for ugyldige skemaer og dokumenter hver beskæring eller tærskel‑beslutning.
Arbejds eksempel: et fortolkeligt lånetriage‑træ
En långiver bruger kun et træ til at prioritere ufuldstændige ansøgninger til manuel gennemgang, ikke til at godkende eller afvise kredit. Målet er et dokumenteret fuldstændigheds‑resultat, og de funktioner, der er tilgængelige ved indtagelse, udelukker senere beslutninger. Grupperet tids‑validering sammenligner et grunt beskåret træ med regler og logistisk regression. Minimum bladstørrelse forhindrer regler baseret på kun få ansøgere, mens kalibrering og klasse‑specifikke fejl rapporteres på tværs af kanaler og relevante beskyttede grupper.
Gennemgangere ser den præcise sti og kilde‑værdier, men kan rette fejlagtige data og tilsidesætte routing. Organisationen tester korrelerede proxy‑variable og kontrafaktiske ændringer, overvåger blad‑beskæftigelse og manglende værdier, og betragter pludselig trafik ind i et lille blad som en datakvalitets‑hændelse. Politik‑ændringer skaber en ny model‑version og validering, ikke en u‑dokumenteret opdelings‑redigering. Da brugen påvirker adgang og byrde, får ansøgere en menneskelig kanal, og træet præsenteres aldrig som en kausal forklaring på kreditværdighed.
Implementeringsbeviser og driftsparathed
En produktions‑beslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver væsentlig fejl. Etabler et reproducerbart grundlag og et versioneret evaluerings‑sæt før tuning. Test almindelige tilfælde, grænse‑betingelser, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der sandsynligvis vil blive underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressource‑omkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for frigivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑helbred, menneskelige overrides og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil vedvare. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genopretning, hændelses‑læring, sletnings‑ og opbevarings‑procedurer samt et klart punkt, hvor det skal deaktiveres eller udskiftes.
Primære referencer












