Grundlæggende AI
Overvåget vs uovervåget læring

 Føj Unite.AI til dine foretrukne kilder på Google
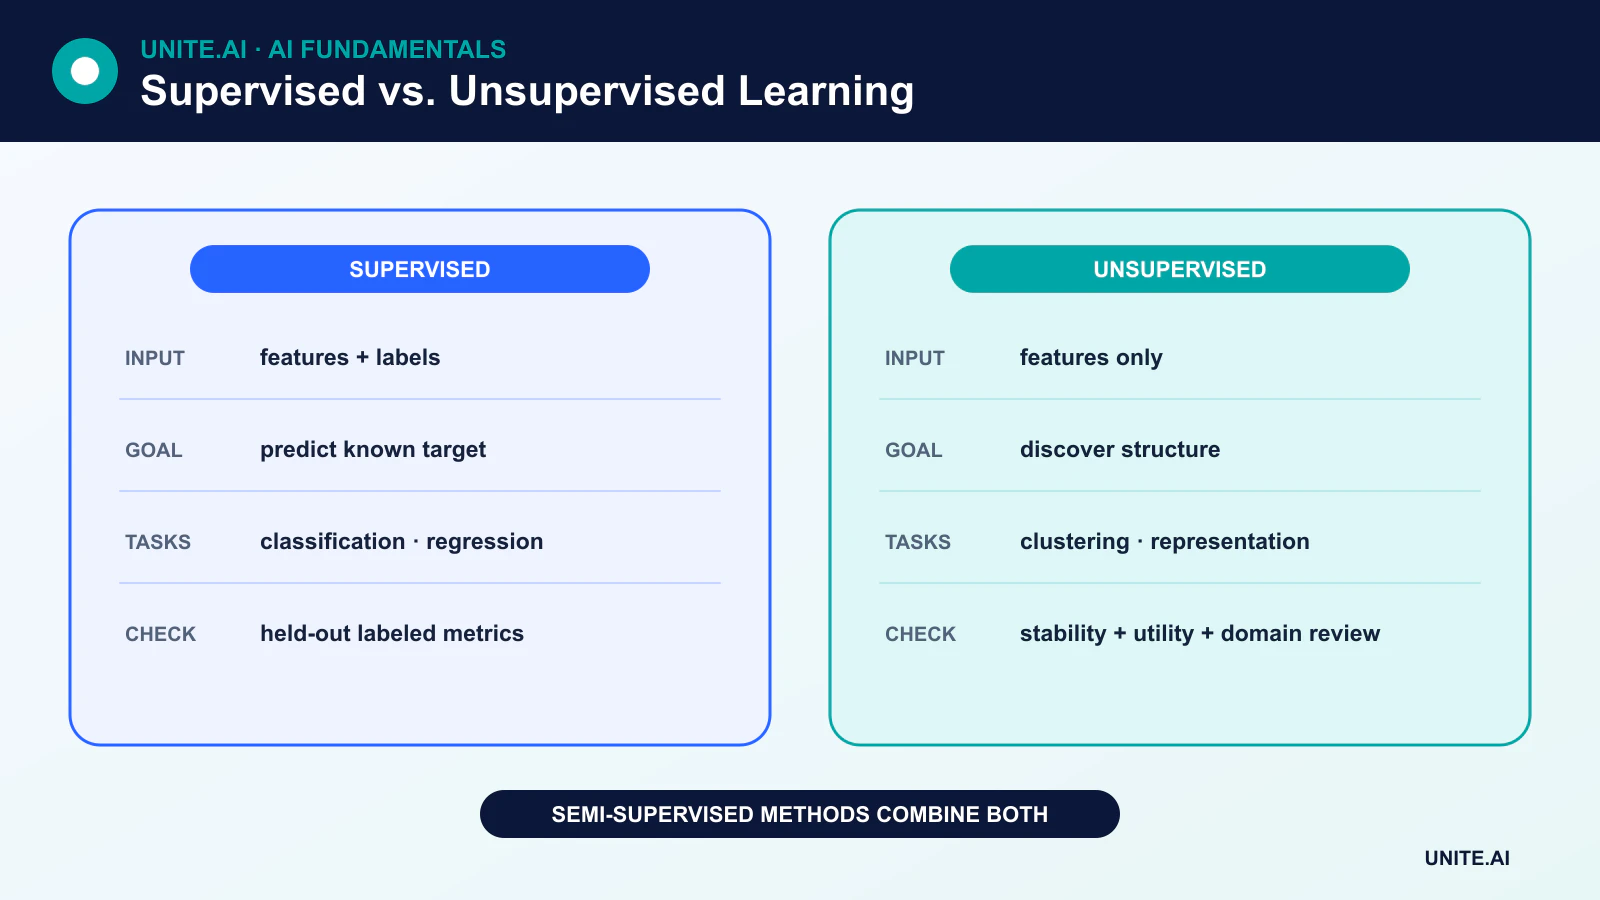
Overvåget læring lærer fra eksempler parret med mål‑svar. Uovervåget læring søger efter struktur i data uden mål‑etiketter. Forskellen er ikke, hvilken tilgang der er mere intelligent eller præcis; det er den type læringssignal, der er tilgængelig, og det spørgsmål, systemet er designet til at besvare.
Dette er to store paradigmer inden for maskinlæring, men moderne systemer bruger også semisupervised, selv‑supervised og forstærkningslæring.
Vigtige pointer
- Overvåget læring forudsiger en kendt mål; uovervåget læring opdager mønstre eller repræsentationer.
- Klassificering og regression er overvågede opgaver; klyngedannelse, tæthedsanalyse og mange dimensionsreduktion‑metoder er uovervågede.
- Uovervågede output er ikke automatisk virkelige klasser og kan være sværere at evaluere.
- Beregningsomkostninger og nøjagtighed afhænger af algoritmen, data, opgaven og evalueringen – ikke kun af paradigmet.
Hvordan overvåget læring fungerer
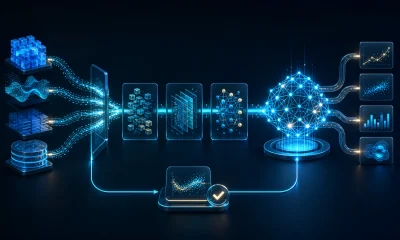
Et overvåget datasæt indeholder funktioner X og et mål y. Træning justerer en model, så dens forudsigelser nærmer sig målene. Evaluering bruger hold‑out mærkede eksempler til at estimere, hvor godt den generaliserer.
Klassificering
Klassificering forudsiger en kategori: spam eller ikke‑spam, ét dokumentemne blandt flere, eller ét eller flere objekter i et billede. Relevante målinger omfatter præcision, recall, F1, kalibrering og omkostningsfølsomme mål. Nøjagtighed kan være misvisende, når én klasse er sjælden; en forvirringsmatrix viser, hvilke klasser der forveksles.
Regression
Regression forudsiger en kontinuert værdi, såsom efterspørgsel, varighed eller temperatur. Lineær regression kan bruge én eller mange funktioner; den er ikke begrænset til at beskrive et forhold mellem to variable. Regressionsmålinger omfatter gennemsnitlig absolut fejl, rodfirkantfejl (RMSE) og opgavespecifikke omkostninger.
Almindelige overvågede algoritmer
Overvågede metoder omfatter lineære og logistiske modeller, beslutningstræer, tilfældige skove, gradientforstærkning, supportvektormaskiner, K‑nærmeste naboer og neurale netværk.
Logistisk regression producerer en score eller sandsynlighed, der kan konverteres til en klasse ved hjælp af en valgt tærskel. Et blad i et beslutningstræ indeholder en forudsigelse baseret på et område af funktionrummet, ikke nødvendigvis en enkelt træningsobservation. KNN forudsiger ud fra nærliggende mærkede træningseksempler og kræver stadig et solidt design af træning/validering/test.
Hvordan uovervåget læring fungerer
Uovervåget læring modtager funktioner uden en mål‑kolonne. Dens mål defineres indirekte – for eksempel at minimere afstand inden for klynger, rekonstruere en input, estimere datatæthed eller bevare så meget varians som muligt i færre dimensioner.
Klyngedannelse
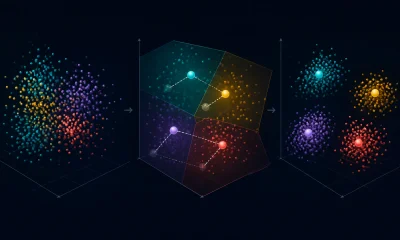
K‑means tildeler punkter til et valgt antal klynger og opdaterer klyngecentre for at reducere den kvadrerede afstand inden for klyngen. Algoritmen opdager geometriske grupper under en bestemt afstands‑ og funktionrepræsentation. Disse grupper svarer ikke automatisk til meningsfulde kundetyper, diagnoser eller andre domænelabels.
Dimensionsreduktion
Dimensionsreduktion repræsenterer data ved hjælp af færre variabler. Principal Component Analysis (PCA) finder ortogonale retninger, der bevarer så meget varians som muligt under en lineær projektion. Andre metoder bevarer forskellige strukturbegreber og kan producere meget forskellige visualiseringer.
Anomali‑ og tæthedsanalyse
Uovervågede metoder kan estimere, hvor data er tæt, og markere usædvanlige observationer. En anomaliscore beviser ikke svindel, fejl eller ondsindet adfærd; den identificerer en afvigelse under den valgte repræsentation og model.
Hvordan uovervåget læring evalueres
Der findes ingen universel opfattelse af uovervåget “nøjagtighed”. En praktik kan bruge interne målinger såsom silhuet‑score, sammenligne stabilitet på tværs af prøver, teste nytte i en efterfølgende opgave eller spørge domæneeksperter, om den opdagede struktur er meningsfuld. Hvis der findes sand‑sandhed‑etiketter til evaluering, kan eksterne klynge‑målinger anvendes uden at gøre træningsprocessen til overvåget læring.
Udover den todelte sammenligning
Semisupervised læring
Semisupervised læring kombinerer et mindre mærket datasæt med et større umærket datasæt. Pseudo‑labeling, konsistensregularisering og graf‑baserede metoder er eksempler. De umærkede data skal stadig ligne målfordelingen tilstrækkeligt tæt til at være hjælpsomme.
Selv‑supervised læring
Selv‑supervised læring udleder mål fra selve inputtet, såsom at forudsige maskede tokens eller matche transformerede udsigter. Det er et grundlag for moderne sprog‑, vision‑ og multimodale modeller, herunder transformer‑netværk.
Forstærkningslæring
Forstærkningslæring optimerer beslutninger gennem belønninger genereret ved interaktion. Den adskiller sig fra både mærket forudsigelse og statisk mønsteropdagelse.
Valg af den rette tilgang
Start med den beslutning eller indsigt, systemet skal levere. Hvis pålidelige mål findes, og forudsigelse er målet, er overvåget læring naturlig. Hvis målet er udforskning, repræsentation eller gruppering, kan en uovervåget metode passe. Når etiketter er knappe, kan selv‑supervised eller semisupervised fortræning efterfulgt af overvåget evaluering være mere effektiv.
I alle tilfælde kan datalækage, biased sampling, svage proxy‑variabler og distributionsskift dominere valg af algoritme. En teknisk korrekt model trænet på et forkert mål kan stadig fejle.
Læringssignaler, mål og repræsentative metoder
Overvåget læring bruger eksempler parret med mål‑etiketter eller værdier og optimerer den forudsigende fejl. Klassificering, regression, rangering og struktureret forudsigelse adskiller sig i output og tab. Uovervåget læring søger struktur uden mål‑etiketter gennem klyngedannelse, tæthedsanalyse, dimensionsreduktion, repræsentationslæring eller generativ modellering. Selv‑supervised læring skaber forudsigelsesmål fra selve dataene, mens semisupervised læring kombinerer et lille mærket datasæt med større umærkede data. Disse kategorier beskriver læringssignalet; den samme neurale arkitektur kan trænes under flere paradigmer.
Etiketter gør et mål eksplicit, men introducerer annoteringsomkostninger, støj, politiske antagelser og tidsmæssig forsinkelse. Umærkede data er lettere at indsamle, men fortæller ikke en algoritme, hvilken opdaget struktur der er nyttig. En klynge kan afspejle belysning, dokumentlængde eller indsamlingkilde i stedet for en meningsfuld kategori. Definér evaluering uafhængigt: overvågede modeller bruger hold‑out mærkede resultater, mens uovervågede modeller har brug for stabilitet, rekonstruktion, sandsynlighed, genfinding, efterfølgende nytte eller ekspertvalidering. Visuel adskillelse alene er ikke bevis på en gyldig struktur.
Valg af paradigm og forebyggelse af almindelige fejl
Brug overvåget læring, når et stabilt mål og repræsentative etiketter findes. Brug uovervåget udforskning til at opsummere, opdage nyheder, komprimere eller generere hypoteser, men betragt output som foreløbige. Selv‑supervised fortræning er værdifuld, når rådata er rigelige, og efterfølgende opgaver deler repræsentationer. Semisupervised metoder hjælper kun, når antagelser om umærkede data og klasse‑struktur holder. Sammenlign med simple baselines og tag højde for de samlede omkostninger ved indsamling, mærkning, gennemgang, beregning og fejl i stedet for at antage, at umærkede automatisk er billige.
Forebyg lækage ved at adskille relaterede enheder, før etiketter, augmentationer eller pseudo‑etiketter udledes. Overvåg klassebalance, annoterings‑overensstemmelse, klynge‑stabilitet, kollaps og drift. Pseudo‑etiketter kan forstærke tidlige fejl; klyngedannelse kan indkode følsomme attributter; en fortrænet repræsentation kan overføre kilde‑bias. Menneskelig gennemgang bør fokusere på grænsetilfælde og konsekvenser. I produktion skal du dokumentere, hvordan læringssignalet blev skabt, og hvornår det bliver forældet. Paradigmet bestemmer, hvor supervisionen træder ind i systemet, ikke om menneskelige valg og værdier er til stede.
Eksempel: opdagelse og mærkning af support‑emner
En virksomhed bruger først uovervågede indlejringer og klyngedannelse til at udforske temaer i anonymiserede support‑beskeder. Analytikere inspicerer repræsentative og grænse‑eksempler og finder, at nogle klynger afspejler beskedlængde og kanal i stedet for problemer. De udvikler en overvåget taksonomi med en ukendt klasse, annoteringsvejledning og målt enighed. En klassifikator evalueres derefter på senere tidsperioder, sprog og produkter mod nøgleord‑ og nærmeste‑nabo‑baselines.
Umærkede nye beskeder understøtter driftsopdagelse, men træner ikke klassifikatoren automatisk. Gennemgængere mærker udvalgte usikre og nye tilfælde via aktiv læring, med kvalitetskontrol og et lukket evalueringssæt. Overvågning sporer emne‑forekomst, tillid, uenighed og routeringsresultater. Når et nyt produkt lanceres, opdateres taksonomien og kapaciteten i efterfølgende teams samtidigt. Arbejdsflowet bruger uovervågede metoder til hypotesegenerering og overvågede beviser til operationel routering.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal du tildele myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller erstattes.
Primære referencer