
Grundlæggende AI
Hvad er K‑means‑klyngedannelse?

 Føj Unite.AI til dine foretrukne kilder på Google
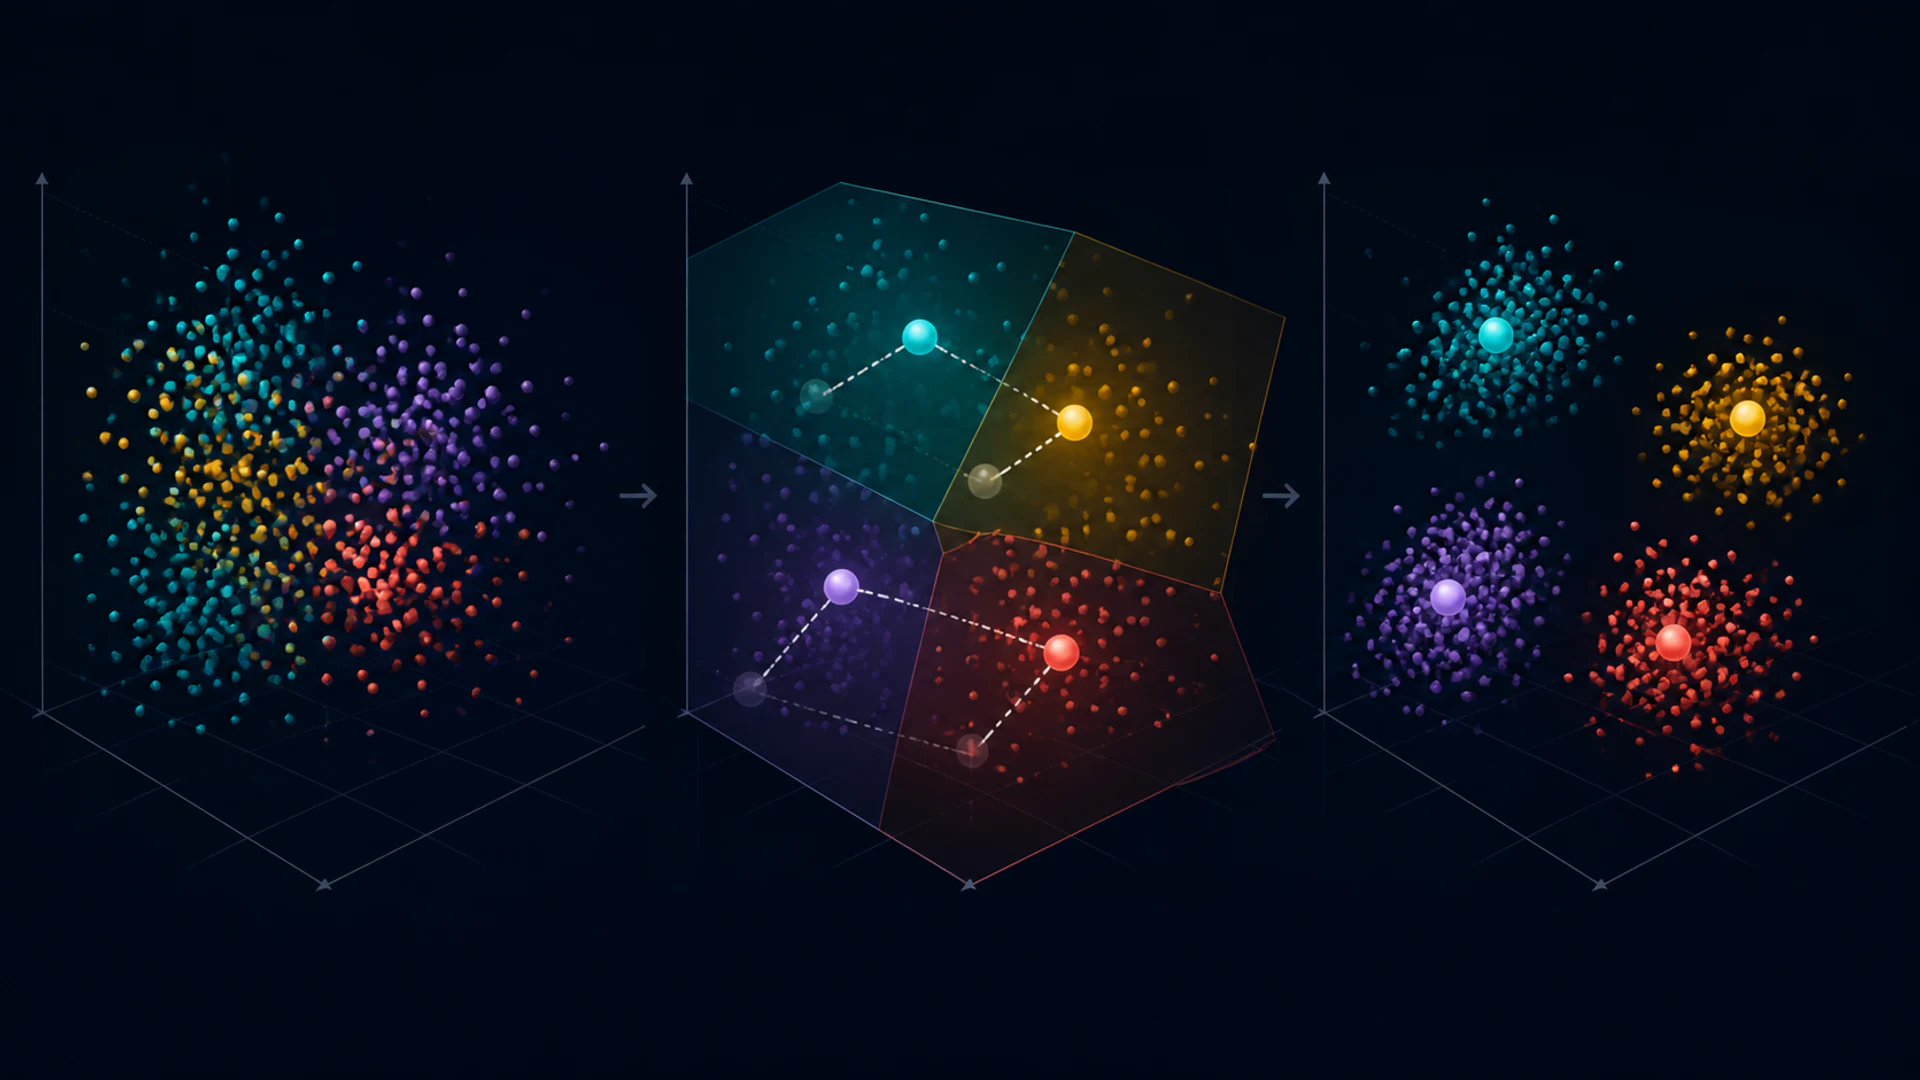
K-means er en usuperviseret algoritme, der opdeler numeriske observationer i k klynger. Den skifter mellem at tildele hvert punkt til det nærmeste centroid og at genberegne hvert centroid som gennemsnittet af de tildelte punkter.
Algoritmen er hurtig og nyttig, men resultatet påvirkes af skalering, afstand, initialisering og det valgte k. En klynge er en matematisk opdeling, ikke automatisk en kategori i den virkelige verden.
Vigtige pointer
- K-means minimerer den kvadrerede euklidiske afstand inden for hver klynge til centroids.
- Initialisering er vigtig; k-means++ spreder start‑centroids og forbedrer typisk resultaterne.
- Standardiser funktioner, når deres enheder eller skalaer skal bidrage på tilsvarende måde.
- K-means har problemer med outliers, ikke‑sfæriske klynger, ulige tætheder og kategoriske data.
Målet og opdateringsløkken
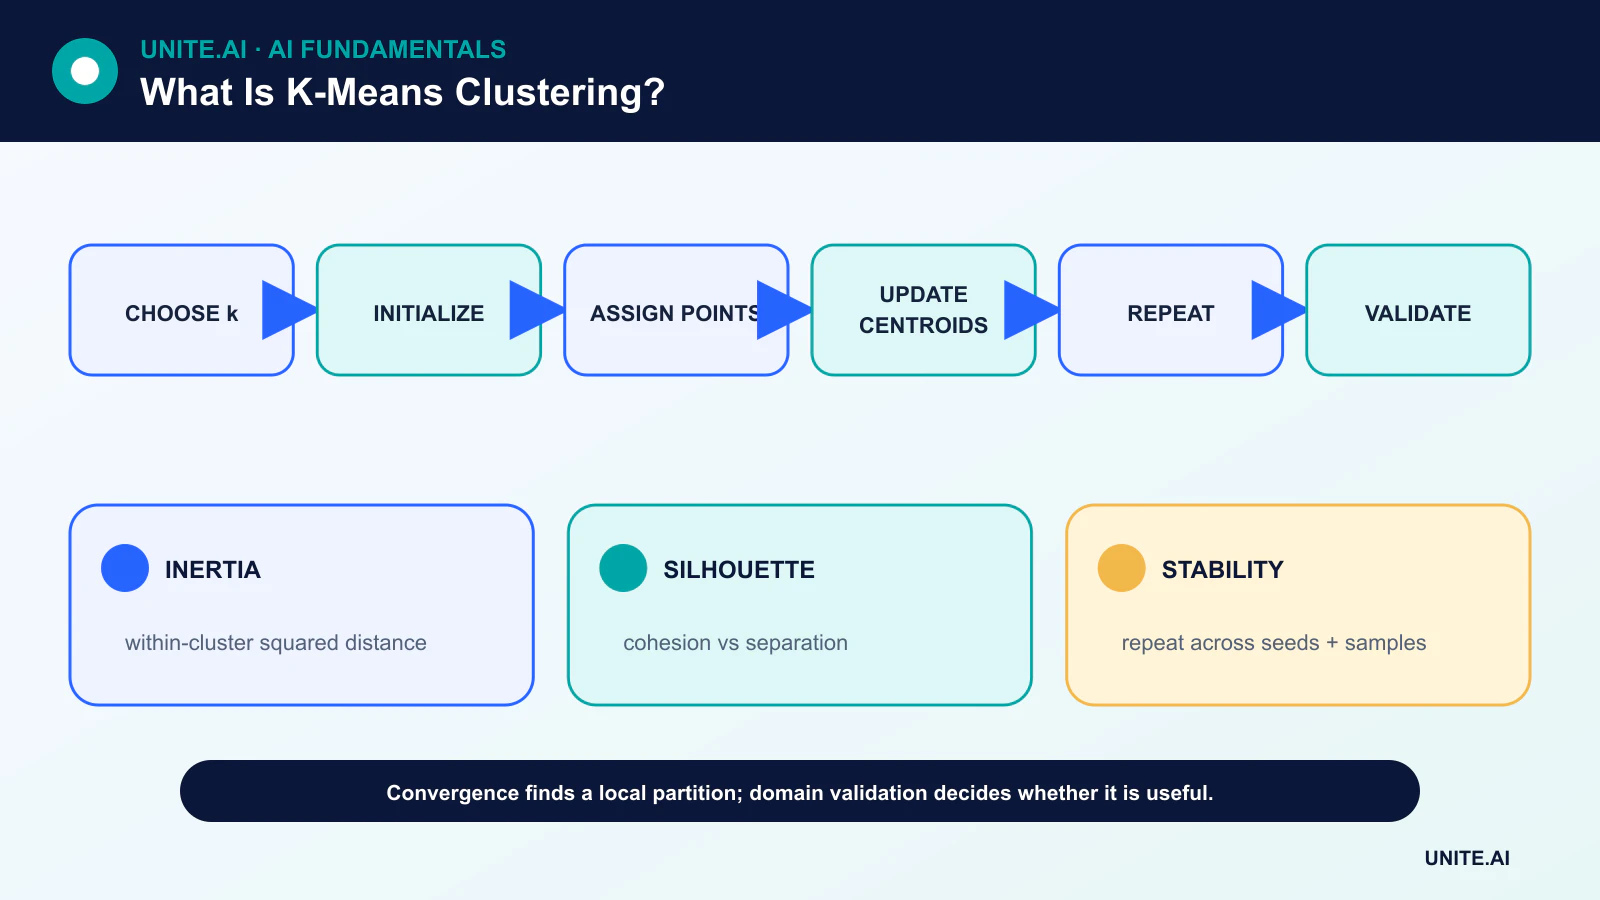
Givet k centroids sender tildelingstrinnet hver observation til den nærmeste. Opdateringstrinnet erstatter hvert centroid med gennemsnittet af de observationer, der er tildelt det. Den inden‑for‑klynge sum af kvadrater kan ikke øges under disse trin, så processen konvergerer mod et lokalt optimum.
Konvergens garanterer ikke det globale optimum. Forskellige start‑centroids kan føre til forskellige opdelinger, hvilket er grunden til, at implementeringer kører flere initialiseringer og beholder løsningen med den laveste inerti.
Initialisering og k-means++
At vælge alle start‑centroids tilfældigt fra én tæt region kan give en dårlig løsning eller langsom konvergens. K-means++ vælger frø med sandsynlighed relateret til afstanden fra eksisterende frø, hvilket fremmer dækning af datasættet.
Flere kørsel forbliver nyttige. Registrer den tilfældige seed og antallet af initialiseringer, så resultaterne kan genskabes.
Skalering og afstand
Den kvadrerede euklidiske afstand gør K-means følsom over for enheder. En funktion målt i tusinder kan dominere en anden målt mellem nul og én. Standardisering er almindelig, men domænekendskab bør afgøre, om ens standardiseret varians afspejler ens betydning.
Outliers kan trække et gennemsnit langt fra typiske punkter. Robust skalering, trimming eller metoder baseret på medoid kan være bedre. One‑hot‑kategoriske funktioner skaber en afstandsgeometri, der måske ikke svarer til kategorisammenhæng.
Valg af k og validering af klynger
Inerti falder, når k øges, så den kan ikke alene bestemme k. Albue‑heuristikken søger efter aftagende forbedring. Silhouette‑analyse sammenligner kohæsion og separation. Stabilitet på tværs af prøver og seeds tilføjer en ekstra kontrol.
Den stærkeste validering er nytteværdien for det tilsigtede domæne. Sammenlign klynger med kendte udfald, ekspertvurdering eller en efterfølgende opgave uden at foregive, at post‑hoc‑etiketter blev opdaget objektivt.
Begrænsninger og alternativer
K-means favoriserer kompakte, omtrent sfæriske grupper af lignende skala. Gaussian mixture‑modeller repræsenterer probabilistiske ellipsoide komponenter; DBSCAN‑lignende metoder identificerer tætte regioner og støj; hierarkisk klyngedannelse producerer et træ af sammensmeltninger.
Dimensionality reduction kan forbedre hastighed eller reducere støj i input, men at tilpasse den på hele datasættet kan ændre valideringsspørgsmålet. Mini‑batch K-means reducerer beregning for store datasæt på bekostning af en tilnærmet opdatering.
Mål, initialisering og konvergens
K-means opdeler numeriske observationer i k klynger ved at minimere den inden‑for‑klynge kvadrerede euklidiske afstand til centroids. Lloyds algoritme skifter mellem at tildele hvert punkt til det nærmeste centroid og at genberegne centroids, indtil tildelinger eller målet stabiliseres. Den konvergerer til et lokalt optimum, ikke nødvendigvis det globale bedste. K-means++‑initialisering spreder start‑centre og forbedrer typisk resultaterne, men flere frø forbliver vigtige. Standardiser funktioner, når enheder skal bidrage på tilsvarende måde, fordi kvadreret afstand forstørrer variabler med høj skala og outliers.
Metoden antager omtrent kompakte, sfæriske, ens skalerede klynger under euklidisk geometri. Den har vanskeligheder med udstrakte manifolder, ulige tæthed, kategoriske data, kraftige outliers og indlejrede strukturer. Tomme klynger og duplicate punkter kræver defineret håndtering. Mini‑batch k-means skalerer til store data med en tilnærmelses‑trade‑off. For spars tekst kan kosinus‑orienteret spherical k-means bedre matche retning, mens blandinger, tæthedsmetoder, hierarkisk klyngedannelse eller k‑medoids indkoder andre antagelser.
Valg af k og validering af betydning
Albue‑kurver, silhouette‑scores, informationskriterier i relaterede modeller og stabilitet kan informere k, men ingen af dem afslører et entydigt korrekt tal. Forretningsnytte og domænetolkning er afgørende. Genfit på tværs af prøver og seeds, sammenlign centroid‑bevægelse og tildelingskonsistens, og valider klynger på uafhængige udfald, som ikke blev brugt til at danne dem. En todimensionel projektion kan forvride separation, så undersøg afstande og eksempler i det oprindelige eller validerede repræsentationsrum.
Klynger er beskrivende grupper skabt af de valgte funktioner og metrik; de er ikke naturlige typer eller kausale segmenter. Profiler baseret på de samme variable, der bruges til klyngedannelse, kan blive cirkulære. Brug hold‑out‑attributter og kvalitativ gennemgang, og inspicer om klynger primært gengiver geografi, datakilde eller følsomme træk. Små klynger kan være anomalier eller artefakter. At navngive en klynge gør ikke, at hvert medlem passer til etiketten.
Implementering og vedligeholdelse
Gem skalering, funktionsrækkefølge, centroids, afstandsdefinition og klyngeetiketter sammen. For nye punkter, overvåg afstanden til den tildelte centroid og andelen, der ligger langt uden for trænings‑support; lever en ukendt tilstand i stedet for at tvinge hver sag ind i en klynge. Spor klyngestørrelser, centroids og udfaldsrelevans over tid. Gen‑træning ændrer klyngidentiteter, så map eller versionér downstream‑regler i stedet for tavst at genbruge gamle navne. K-means er en nyttig komprimerings‑ og segmenteringsbaseline, når geometrien matcher spørgsmålet, men ikke en universel opdagelsesmaskine.
Eksempel: kundesegmentering med k-means
Et abonnementsselskab standardiserer brugsfunktioner over et fast vindue, fjerner kontoidenter og tester k på tværs af frø. Stabilitet, silhouette og hold‑out forretningsresultater gennemgås, men produktteams inspicerer også repræsentative og grænse‑konti. De opdager, at én klynge blot er nye kunder med kortere observationsperiode, så anciennitet håndteres eksplicit. K-means sammenlignes med hierarkisk og tætheds‑baserede alternativer i stedet for at antage, at den er passende. Øvelsen betragtes som usuperviseret læring, ikke som etiket‑opdagelse.
Segmenterne guider forskning og besked‑eksperimenter, ikke berettigelse eller prisfastsættelse. Nye konti langt fra enhver centroid får en ukendt tildeling. Skalering, funktioner, centroids og navne versioneres, og gen‑træning kortlægger nye klynger til gamle kun med bevis. Overvågning sporer klyngestørrelse, afstand og udfaldsrelevans. Følsomme attributter og proxy‑variabler auditeres, og teamet undgår at beskrive klynger som naturlige personlighedstyper, når de blot er matematiske opdelinger af udvalgt adfærd.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér et reproducerbart grundlag og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænsebetingelser, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre inputkvalitet, output‑adfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede udfald uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller erstattes.
Ofte stillede spørgsmål
Er K-means superviseret eller usuperviseret?
Det er usuperviseret, fordi det modtager funktioner og et valgt antal klynger, men ingen mål‑etiketter.
Klassificerer K-means nye data?
Efter tilpasning kan et nyt punkt tildeles til det nærmeste centroid. Det er klynge‑tildeling, ikke nødvendigvis en superviseret klassifikations‑forudsigelse.
Primære referencer












