Grundlæggende AI
Hvad er datavidenskab?

 Føj Unite.AI til dine foretrukne kilder på Google
Datavidenskab er praksissen med at omdanne data til forsvarlig viden, forudsigelser eller beslutninger. Den kombinerer domæneekspertise, statistik, beregning, dataengineering, visualisering og kommunikation. En model kan indgå i arbejdet, men disciplinen begynder før modellering og fortsætter efter implementering.
Det vigtigste spørgsmål er ikke “Hvilken algoritme skal vi bruge?” Det er “Hvilken beslutning understøtter vi, hvilke beviser vil besvare den, og hvordan ved vi, at resultatet forbliver brugbart?”
Vigtige pointer
- Datavidenskab er en ende-til-ende evidensarbejdsproces, ikke et synonym for maskinlæring.
- Problemdefinition, måling og dataforvaltning afgør ofte succes mere end modelkompleksitet.
- Prædiktive og kausale spørgsmål kræver forskellige antagelser og evalueringsdesigns.
- En implementeret analyse kræver overvågning, dokumentation og kommunikation, der passer til dens brugere.
Start med en beslutning og et estimand
Et projekt bør identificere brugeren, beslutningen, interventionen og fejlkostnaden. For et beskrivende spørgsmål kan målet være en rate eller tendens. For en forudsigelse kan det være fremtidig efterspørgsel eller risiko. For et kausalt spørgsmål beskriver estimandet effekten af en defineret intervention under angivne antagelser.
Uklare mål som “find indsigt” gør evaluering umulig. Et mål, der kan måles, skaber en grænse for dataindsamling og forhindrer analysen i at udvide sig til alle tilgængelige felter.
Indsaml, styr og forstå data
Teams laver en oversigt over kilder, ejerskab, samtykke, opbevaring, oprindelse og adgang. De skelner mellem strukturerede og ustrukturerede data, definerer enheder og tidsstempler og undersøger, om posterne repræsenterer den ønskede population og tidsperiode.
Rensning er ikke blot at slette manglende rækker. Det omfatter at løse dubletter, umulige værdier, mærke‑uklarhed, schema‑drift, censurering og joins, der ændrer analyseenheden. Hver transformation skal kunne reproduceres og dokumenteres.
Udforsk før modellering
Explorativ analyse undersøger fordelinger, mangler, relationer og potentielle måleartefakter. Visualisering kan afsløre outliers og undergruppeforskelle, som et samlet gennemsnit skjuler. Udforskning bør informere hypoteser uden at blive forvekslet med bekræftende beviser.
Feature‑engineering, dimensionalitetsreduktion og repræsentationslæring kan forbedre modellering, men transformationer skal kun tilpasses træningsdata for at forhindre lækage.
Vælg metoder til spørgsmålet
Statistisk estimering kvantificerer usikkerhed omkring de relevante størrelser. Maskinlæring er nyttig, når hovedmålet er forudsigelsespræstation på nye data. Eksperimenter og kausale inferensmetoder er nødvendige, når målet er en interventionsvirkning.
En baseline bør være enkel nok til at forstås. Mere komplekse modeller skal retfærdiggøre deres ekstra omkostninger gennem bedre hold‑out‑præstation, kalibreret usikkerhed, operationel værdi eller en nødvendig funktion som billed‑ eller sprogbehandling.
Evaluer, kommuniker og overvåg
Evalueringen bør matche beslutningen. En klassifikator kan kræve præcision, recall, kalibrering og undergruppeanalyse frem for kun nøjagtighed; et prognosesystem har brug for tidsbevidst backtesting. Overfitting og lækage er procesfejl, ikke blot modelegenskaber.
Kommunikation omfatter antagelser, usikkerhed, begrænsninger og anbefalede handlinger. Når en model eller et dashboard er i brug, overvåger teams inputkvalitet, resultatdrift, brugeradfærd og downstream‑påvirkning. En udfaset beslutningsproces har brug for et arkiv og klar ejerskab, ligesom en implementeret proces har brug for en operatør.
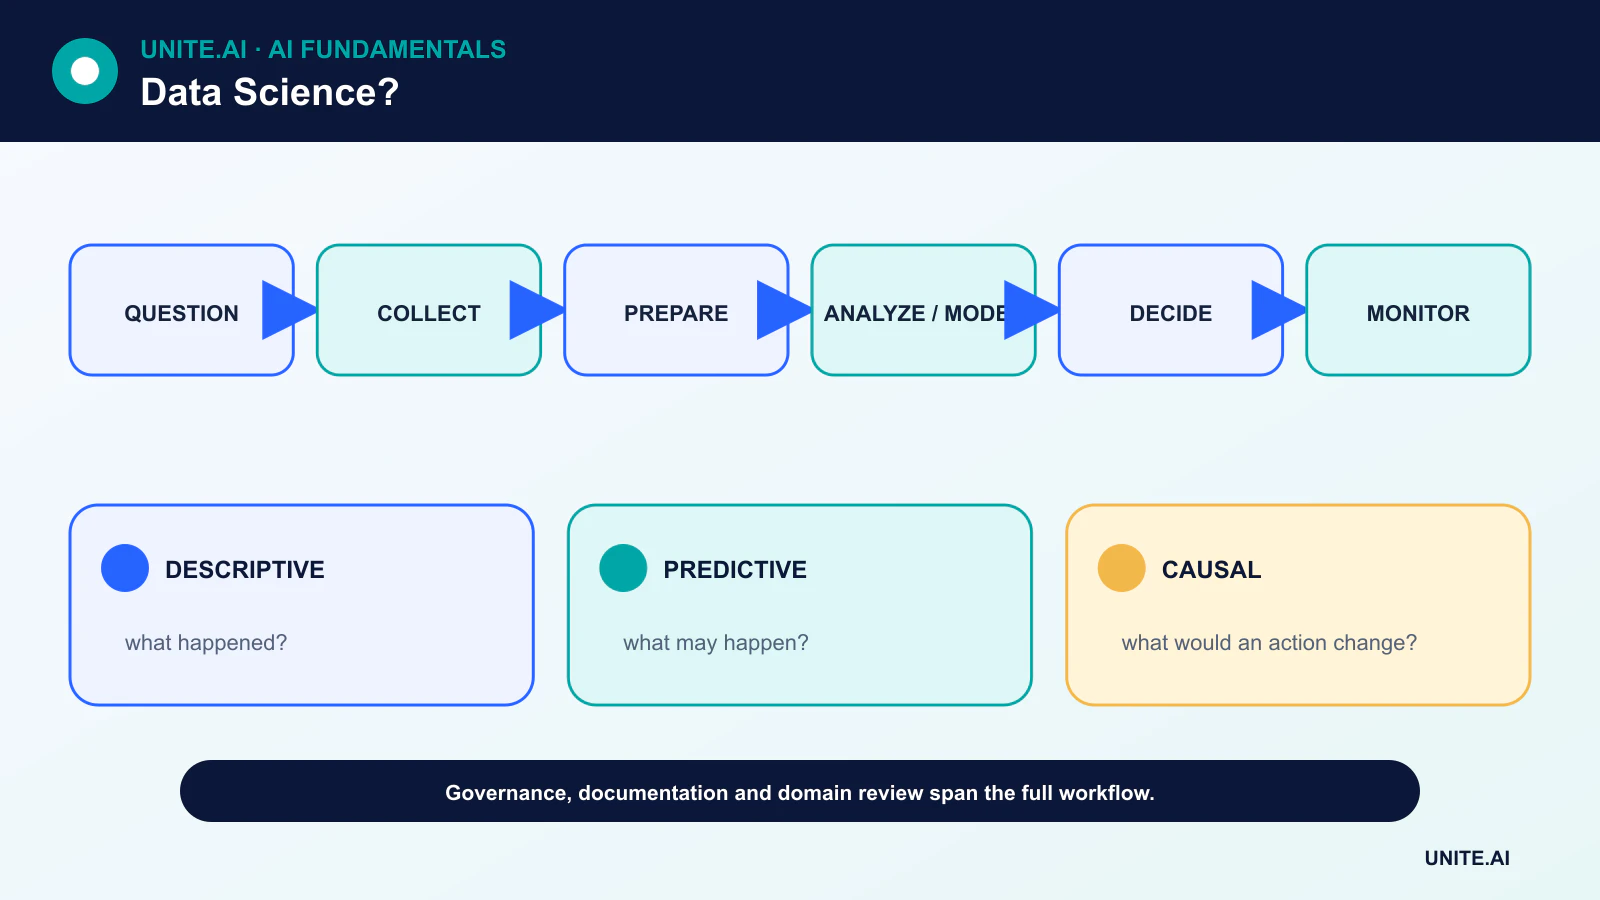
Datavidenskabens livscyklus og analytiske spørgsmål
Datavidenskab kombinerer domæneviden, statistik, beregning og kommunikation for at omsætte data til beviser for beslutninger. Start med at skelne mellem beskrivelse, diagnose, forudsigelse og kausal inferens. Et dashboard, der rapporterer hvad der skete, en model, der forudsiger hvem der vil frafalde, og et eksperiment, der estimerer om en intervention ændrer frafald, besvarer forskellige spørgsmål. Definér enheden, populationen, tidsvinduet, udfaldet, handlingen og fejlkostnaden inden data udtrækkes. Mange mislykkede projekter løser en målbar proxy, som ikke kan understøtte den tilsigtede beslutning.
Indsamling kræver oprindelse, tilladelser, prøveudtagningsdesign og en datakontrakt. Udforskning tjekker fordelinger, mangler, dubletter, outliers, relationer, målingsændringer og potentiel lækage. Rensevalg er analytiske antagelser: sletning af manglende rækker, imputering af værdier eller begrænsning af outliers kan ændre populationen og konklusionen. Versionér rådata uforanderligt og transformationer som kode, og opret et datadictionary med enheder og betydning. Del evalueringsdata før læring af transformationer eller gentagen test af hypoteser.
Modellering, inferens og reproducerbarhed
Statistisk inferens kvantificerer usikkerhed under antagelser; prædiktiv modellering estimerer out‑of‑sample‑præstation; kausal analyse kræver identifikation gennem design eller forsvarlige antagelser. Vælg metoder, der matcher spørgsmålet og den data‑genererende proces. Sammenlign med simple baselines, brug grupperet eller tidsbevidst validering, og rapportér usikkerhed og følsomhed. En høj korrelation eller feature‑importance etablerer ikke kausalitet. Multipel testning, forskerens frihedsgrader og selektiv rapportering kan fremstille overbevisende mønstre, så forudregistrering eller en tydeligt adskilt bekræftelsesfase kan hjælpe.
Reproducerbarhed omfatter kode, miljø, datasnapshot, tilfældige frø, forespørgselsdefinitioner og en registrering af manuelle beslutninger. Automatiserede tests bør dække skemaer, forretningsinvarianter, transformationer og målinger. Notebooks er værdifulde til udforskning, men produktionsarbejde kræver modulære, gennemgåelige pipelines. Peer review bør udfordre antagelser, lækage, målvaliditet og om resultaterne kan generaliseres. Kommuniker effektstørrelser, usikkerhed, begrænsninger og modbeviser frem for kun statistisk signifikans eller en modelscore.
Udrulning og beslutningspåvirkning
Hvis analysen driver en tilbagevendende proces, tildel ejere, overvåg datafriskhed og udfaldskvalitet, og definér rollback eller udfasning. Beskyt personlige og fortrolige oplysninger gennem minimalisering, adgangskontrol, opbevaring og sikre output. Evaluer undergruppeeffekter og hvordan brugere reagerer på modellen; feedback‑loops kan ændre fremtidige data. Mål om beslutningen forbedrede det reelle mål, ikke blot om en model blev implementeret. Datavidenskab er succesfuld, når beviser ændrer handlinger pålideligt og gennemsigtigt – ikke når en organisation akkumulerer dashboards, funktioner eller eksperimenter uden ejerskab.
Arbejdseksempel: måling af en fastholdelsesintervention
Et produktteam observerer lavere fastholdelse og definerer en aktiv bruger, kohorte, tidsvindue, udelukkelser og beslutning. Analytikere reviderer instrumentering, manglende hændelser og acquisitionsmix før modellering. Beskrivende kohorter identificerer, hvor faldet forekommer, en prædiktiv model prioriterer forskningsdeltagere, og et randomiseret onboarding‑eksperiment estimerer, om den foreslåede ændring forbedrer fastholdelsen. Dette er tre separate analyser med forskellige antagelser og output.
Notebogen, forespørgsler, datasnapshot, metrikdefinition og eksperimentplan er versionerede og peer‑reviewede. Resultaterne rapporterer effektstørrelse og usikkerhed med sikkerhedsrammer for supportbehov og tilgængelighed. Et dashboard overvåger eksperimentet, men erstatter ikke den foruddefinerede analyse. Hvis interventionen lykkes, forbliver udrulningen i faser og kontrollerer langsigtet adfærd.
Arbejdet anses for værdifuldt kun hvis det understøtter en reproducerbar beslutning, ikke fordi en kompleks model eller et visuelt overbevisende diagram blev produceret.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver væsentlig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og udfasning. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmtærskler og en responsansvarlig, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret gendannelse, hændelseslæring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er datavidenskab det samme som dataanalyse?
Begreberne overlapper. Datavidenskab omfatter ofte opbygning af dataprodukter og prædiktive systemer, mens analyse kan fokusere mere på beskrivende og diagnostisk beslutningsstøtte. Anvendelsen varierer mellem organisationer.
Behøver hvert datavidenskabsprojekt AI?
Nej. En veludformet forespørgsel, diagram, eksperiment eller statistisk estimat kan være mere nyttig og pålidelig end en kompleks model.
Primære referencer