
Grundlæggende AI
Hvad er et Data Fabric?

 Føj Unite.AI til dine foretrukne kilder på Google
data fabric er et arkitektonisk mønster til at opdage, forbinde, styre og levere data på tværs af distribuerede systemer. Det giver et delt metadata‑ og kontrol‑lag, så personer og applikationer kan finde pålidelige data uden at tvinge hvert datasæt ind i en fysisk lagerplads.
Et data fabric er ikke et enkelt produkt, og det udvisker ikke forskelle mellem kildesystemer. Dets værdi afhænger af præcis metadata, klar ejerskab, håndhævelig politik, pålidelig integration og beviser for, at forbrugerne modtager data, der passer til deres formål.
Vigtige pointer
- Et metadata‑rigt kontrolplan forbinder kataloger, lineage, kvalitet, politik og adgang.
- Data kan forblive distribueret og blive kopieret, streamet, transformeret eller virtualiseret efter arbejdsbelastning.
- Data fabric er teknologiorienteret; data mesh lægger vægt på domæneejerskab og data‑som‑produkt.
- Automatisering hjælper med at skalere styring, men ansvarlige ejere definerer stadig betydning, kvalitet og tilladt brug.
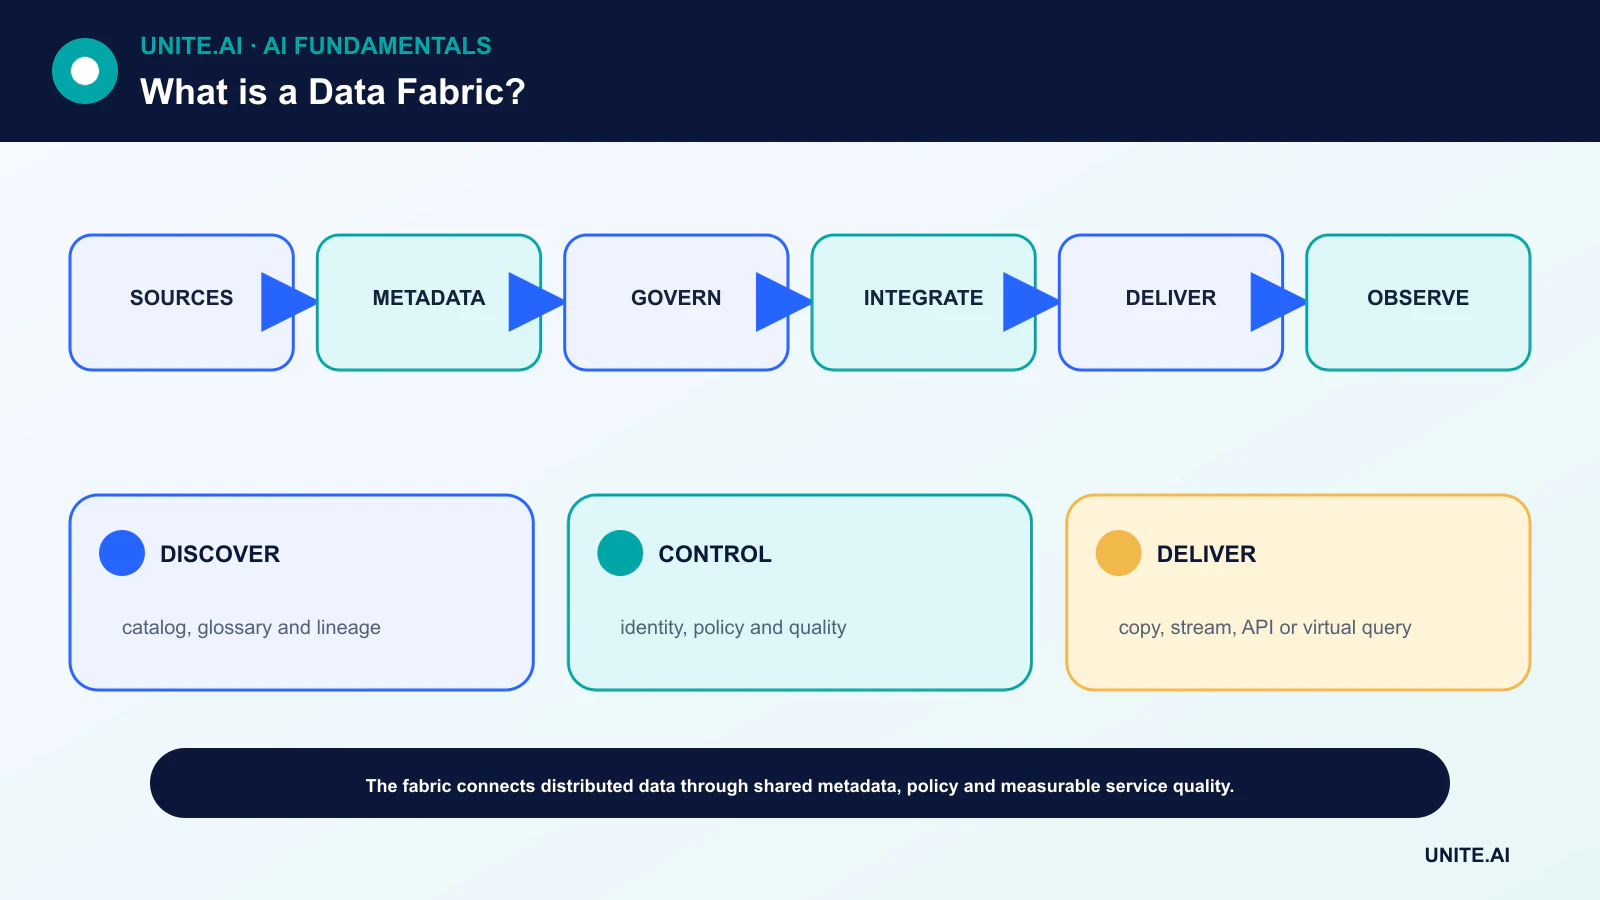
Kontrolplanet og dataplanet
Dataplanet indeholder databaser, filer, streams, API’er og de pipelines, der flytter eller forespørger dem. Kontrolplanet registrerer teknisk og forretningsmæssig metadata: skemaer, ejere, klassifikationer, kvalitetsmålinger, lineage, politikker og brug.
Et katalog eller en vidensgraf kan forbinde disse fakta, så en forbruger kan opdage et datasæt og forstå dets kontekst. Fabric’en bruger derefter metadata til at styre adgang, transformation, observerbarhed og håndhævelse af politik på tværs af heterogene platforme.
Integration uden én obligatorisk lagring
Nogle arbejdsbelastninger kopierer data via ETL; andre bruger change‑data capture, event‑streams, API’er eller forespørgsels‑virtualisering. Det korrekte mønster afhænger af friskhed, ydeevne, konsistens, suverænitet, omkostninger og begrænsninger i kildesystemet.
Virtuel adgang kan reducere duplikering, men kan udsætte forbrugerne for kilde‑latens og tilgængelighed. Fysisk materialisering forbedrer ydeevne og reproducerbarhed, men skaber synkroniserings‑ og livscyklusansvar.
Styring, semantik og kvalitet
Et forretningsglossar giver fælles betydning til termer som kunde, ordre eller aktiv konto. Lineage viser, hvor et felt stammer fra, og hvordan det har ændret sig. Klassifikation og politik bestemmer, hvem der kan få adgang til følsomme poster, og under hvilket formål.
Kvalitetsregler bør knyttes til specifikke anvendelsestilfælde. Fuldførelse, der er tilstrækkelig til et dashboard, kan være usikker for automatiserede beslutninger. En fabric bør fremvise friskhed, valideringshistorik og kendte begrænsninger i stedet for blot at mærke en ressource som certificeret.
Data fabric, mesh og lakehouse
Data mesh er en socioteknisk tilgang, der tildeler domæneteams ansvar for interoperable dataprodukter. Et data fabric lægger vægt på delte tekniske tjenester og metadata‑automatisering. Organisationer kan kombinere dem: domæneejerskab kan fungere gennem en fælles fabric.
Et lakehouse kombinerer data‑lake‑fleksibilitet med lager‑lignende styring og forespørgselsfunktioner. Det kan være én deltagende platform, men det er ikke hele tvær‑system‑fabric’en. Ligeledes leverer et lager eller katalog alene ikke alle integrations‑ og politikfunktioner.
Implementering og evaluering
Start med et værdifuldt tvær‑system‑brugstilfælde og lav en oversigt over de mindst nødvendige kilder, ejere, politikker og service‑niveau‑forventninger. Etablér identitet, metadata‑standarder, kontrakter, test og observerbarhed, før du tilføjer automatiserede anbefalinger.
Mål opdagelsestid, godkendelsestid for adgang, hændelsesrater, datafriskhed, genbrug og forbrugertillid. Forbind fabric’en til styring af struktureret og ustruktureret data samt cybersikkerhed; forbindelse uden kontrol kan øge eksponeringen.
Data‑fabric‑arkitektur og metadata‑plan
Et data fabric er en arkitektonisk tilgang til at forbinde distribuerede data gennem delt metadata, styring, integration og adgangstjenester. Det er ikke én database eller ét produkt. Kilder kan forblive i lagre, søer, operationelle systemer, streams og SaaS‑platforme, mens kataloger beskriver datasæt, lineage sporer transformationer, politikker styrer adgang, og semantiske definitioner gør koncepter genanvendelige. Virtualisering, replikering, API’er og pipelines er komplementære leveringsmetoder, der vælges ud fra latens, skala, kildekapacitet og konsistensbehov.
Aktiv metadata indfanger skemaer, ejerskab, brug, kvalitet, klassifikationer, lineage, forespørgsels‑mønstre og operationelle hændelser og kan drive automatisering. En vidensgraf kan forbinde forretningskoncepter med fysiske felter og politikker. Automatisering kan anbefale joins, opdage drift, viderebringe klassifikationer eller dirigere hændelser, men afledt metadata kræver tillid og forvaltning. Et katalog, der ikke er forbundet til levering og kontrol, bliver til dokumentationsgæld; automatiseret integration uden semantisk ejerskab skaber hurtigere inkonsistens.
Integration, styring og dataprodukter
Batch‑ETL, change‑data capture, streams, federation og reverse ETL har forskellige friskheds‑ og fejl‑semantikker. Definér autoritative kilder, identifikatorer, kontrakter, hændelsestid, sene data, sletning og afstemning. Virtuelle forespørgsler undgår kopier, men afhænger af kilde‑ydeevne og tilgængelighed; materialisering forbedrer hastighed, men skaber friskheds‑ og opbevaringsforpligtelser. Følsom politik skal følges eller revurderes for afledte data, caches, indlejringer og eksport.
Behandl høj‑værdi datasæt som produkter med ejere, brugere, dokumentation, serviceforventninger, tests og support. Federeret ejerskab lader domæner styre betydning, mens delte standarder bevarer interoperabilitet. Centrale teams leverer platform‑kapabiliteter og styring, ikke ejerskab af hvert felt. Mål opdagelsestid, genbrug, datakvalitet, adgangs‑lead‑time, hændelses‑løsning, adoption af betroede målinger og omkostninger. Antallet af katalog‑poster eller forbindelser er ikke bevis på, at folk kan finde og bruge pålidelig data.
Implementeringsstrategi
Start med én tvær‑domæne‑rejse, hvis forsinkelser og risici er kendte. Lav en oversigt over kilder og kontrakter, etabler identitet og klassifikation, forbind lineage og kvalitet, og automatisér gentagne kontroller. Undgå et flerårigt forsøg på at modellere hele virksomheden, før værdi leveres. Test kilde‑nedbrud, skemaændring, tilbagekaldt adgang, sene hændelser og katastrofe‑gendannelse. Et data fabric lykkes, når distribueret data bliver lettere at styre og bruge uden at udviske de operationelle realiteter og ansvarlighed i de systemer, hvor de stammer fra.
Eksempel: en kunde‑data fabric
En virksomhed forbinder handel, support, marketing og produktdata, mens operationelle systemer forbliver autoritative. Et delt katalog linker kunde-, konto‑, ordre‑, samtykke‑ og interaktionsdefinitioner til fysiske felter. Change‑data capture fodrer styrede produkter, mens virtualisering betjener lav‑volumen‑opslag, og materialiserede tabeller understøtter analyse. Identitet, lineage, kvalitet og politik implementeres, før et AI‑personalisering‑lag får lov til at bruge dataene.
Et træk‑tilbage‑samtykke spredes gennem lager‑tabeller, søge‑indekser, indlejringer og aktiveringssystemer, med bevis på fuldførelse. Skemakontrakter og afstemningstests opdager kildeændringer. Ejere offentliggør friskheds‑ og kvalitetsforventninger, og brugs‑metadata hjælper med at udfase ubrugte kopier. Pilot‑projektet måler adgangs‑lead‑time, genbrug af betroede målinger, hændelses‑løsning og privatlivsoverholdelse. Fabric’en betragtes som succesfuld, fordi én tvær‑domæne‑rejse bliver pålidelig og styrbar – ikke fordi en leverandør har forbundet det største antal kilder.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver væsentlig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, grænsebetingelser, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underbetjent. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latens, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑helbred, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret gendannelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller erstattes.
Ofte stillede spørgsmål
Flytter et data fabric al data til ét sted?
Nej. Det kan koordinere data, der forbliver distribueret, og vælge fysisk flytning eller virtualisering pr. arbejdsbelastning.
Er et data fabric det samme som et data mesh?
Nej. Fabric beskriver primært en muliggørende arkitektur og automatisering; mesh beskriver primært decentraliseret domæneejerskab og ansvar for dataprodukter. De kan sameksistere.
Primære referencer











