Grundlæggende AI
Hvad er et data warehouse? Arkitektur, ETL og anvendelsestilfælde

 Føj Unite.AI til dine foretrukne kilder på Google
Et data warehouse er et analytisk datasystem, der integrerer information fra operationelle kilder og organiserer den til rapportering, forretningsintelligens og gentagelig analyse. Det adskiller mange analytiske arbejdsbelastninger fra de applikationer, der registrerer transaktioner.
Moderne warehouses kan være kolonnære, distribuerede, serverløse eller forbundet til objektlagring. Det grundlæggende arbejde forbliver konsistent: styret indtag, modelleret betydning, historik, forespørgselsydelse, sikkerhed, kvalitet og pålidelig levering til brugerne.
Vigtige pointer
- Operationelle systemer optimerer aktuelle transaktioner; warehouses optimerer historisk analyse på tværs af kilder.
- ETL transformerer før indlæsning, mens ELT indlæser først og transformerer inden i den analytiske platform.
- Dimensionelle, normaliserede og brede tabelmodeller tjener forskellige arbejdsbelastninger og styringsbehov.
- Tillid afhænger af lineage, tests, friskhed, adgangskontrol, semantiske definitioner og omkostningsovervågning.
Kilder, indtag og lagring
Data kan ankomme via batches, change-data capture, streams, filer og API’er. Et landingslag bevarer kilde‑konteksten; transformationer standardiserer typer, fjerner dubletter, håndterer sene hændelser og skaber genanvendelige analytiske enheder.
Dette udvider ETL‑arbejdsflowet. ELT bruger lagerets beregning til transformation, mens ETL kan reducere eller validere data før indlæsning. Det rigtige valg afhænger af latenstid, privatliv, skala og værktøjskæde.
Modellér data til spørgsmål
Dimensionelle modeller organiserer målbare fakta omkring beskrivende dimensioner såsom kunde, produkt og tid. Normaliserede kerne‑modeller kan bevare virksomhedsrelationer, mens denormaliserede marts forenkler almindelige forespørgsler.
Et semantisk lag giver målinger konsistente definitioner. Uden det kan teams producere flere tilsyneladende korrekte omsætnings‑ eller fastholdelses‑tal fra de samme rækker. Struktureret data kræver stadig enighed om betydning.
Warehouse, lake og lakehouse
Et data lake gemmer typisk filer og forskellig rå‑ eller behandlet data i objektlagring. Et warehouse leverer styrede analytiske tabeller og forespørgselstjenester. Lakehouse‑design tilføjer tabel‑metadata, transaktioner og styring til lake‑lagringen.
Disse er arkitekturmønstre, ikke garantier. Organisationer kombinerer dem ofte via et data fabric eller et delt styringslag. Arbejdsbelastning, kompetencer, interoperabilitet og livscyklusomkostninger betyder mere end betegnelsen.
Kvalitet, sikkerhed og drift
Definér ejere, kontrakter, friskhedsmål, lineage, tests, opbevaring og række‑ eller kolonneadgang. Adskil personligt identificerbare data, brug mindst mulige rettigheder, og auditér følsomme forespørgsler. Backfills og skemaændringer kræver kontrollerede, observerbare procedurer.
Mål succesfulde opdateringer, dataforsinkelse, testfejl, forespørgselsydelse, adoption, hændelses‑påvirkning og omkostning pr. arbejdsbelastning. Et warehouse er nyttigt, når folk kan spore en måling til styrede data og reproducere resultatet.
Dimensionel modellering og semantik
En faktatabel registrerer hændelser eller periodiske målinger på et erklæret granuleringsniveau, såsom én ordrelinje eller én enhed pr. time. Dimensioner giver beskrivende kontekst. At erklære granuleringsniveau før valg af kolonner forhindrer blanding af niveauer, der kan forårsage dobbeltoptælling. Additive målinger kan summeres på tværs af alle dimensioner; semi‑additive målinger kræver omhu over tid.
Surrogat‑nøgler adskiller lagerets historik fra skiftende kilde‑identifikatorer. Langsomt skiftende dimensioner definerer, hvordan attributændringer håndteres: overskrivning, bevaring af en ny historisk række eller begrænset bevaring af tidligere værdier. Den korrekte metode følger det analytiske spørgsmål og opbevaringsforpligtelser.
En semantisk måling bør definere formel, filtre, tidsadfærd, valuta, undtagelser, ejer og tests. Centrale definitioner reducerer inkonsistens, men styring bør tillade foreslåede ændringer og versionering. Et enkelt semantisk lag bliver en flaskehals, hvis brugere ikke kan inspicere eller udvide det på en ansvarlig måde.
Moderne lagring og forespørgselsarkitektur
Kolonnær lagring holder værdierne i en kolonne samlet, hvilket forbedrer kompression og kun scanner nødvendige felter. Partitionering beskærer store sektioner efter dato eller anden nøgle; clustering placerer relaterede værdier sammen; materialiserede visninger og cache genbruger resultater. Dårlige partitionsvalg skaber små filer, skævhed eller dyre fulde scanninger.
Masse‑parallelle forespørgselsmotorer deler scanninger, joins og aggregationer på tværs af arbejdere. Databevægelse under joins kan dominere køretiden, så distribution, statistik og join‑rækkefølge er vigtige. Autoscaling og serverløse tjenester forenkler kapacitet, men kræver omkostningskontrol, prioritering af arbejdsbelastning og begrænsninger på løbende forespørgsler.
Lakehouse‑tabelformater tilføjer metadata, snapshots, skema‑evolution og transaktionssemantik over objektfiler. De forbedrer interoperabilitet, men introducerer katalog‑ og vedligeholdelsesansvar. Åbne formater reducerer vendor‑låsning kun når beregningsmotorer, styring og driftsprocedurer faktisk kan bruge dem.
Pålidelige pipelines og dataprodukter
Pipelines bør være idempotente eller i stand til at håndtere dubletter. Vandmærker og hændelsestid håndterer sene ankomster; backfills gengiver historiske transformationer; skemakontrakter definerer kompatible ændringer. Datatests dækker unikhed, fuldstændighed, accepterede værdier, relationer og forretningsinvarianter — ikke kun om et job kørte.
Behandl vigtige datasæt som produkter med ejere, dokumentation, serviceforventninger, opdagelighed, support og brugere. Lineage forbinder kildefelter gennem transformationer til rapporter, hvilket gør påvirkning af ændringer og hændelsesundersøgelser hurtigere. Adgangspolitikker bør videreføres eller revurderes, når data kopieres.
Et warehouse‑program lykkes, når beslutninger bliver mere pålidelige og hurtigere, ikke når lagervolumen vokser. Afskaf ubrugte tabeller, gør forespørgsels‑ og lageromkostninger synlige, gennemgå følsom adgang, og mål om teams stoler på og genbruger styrede målinger i stedet for at vedligeholde private regneark.
Praktisk eksempel: design af et salgsanalyse‑warehouse
Definér faktagranulariteten som én fuldført ordrelinje, og link derefter produkt-, kunde-, kanal-, kampagne-, geografiske- og datodimensioner gennem surrogat‑nøgler. Hold ordrestatus‑hændelser i en separat faktatabel i stedet for at blande snapshots og transaktioner. Omsætning, kvantitet, rabat, skat og omkostninger kræver eksplicit valuta, returnering, annullering og anerkendelsesregler. Metrikdefinitionen bør give samme svar i dashboards, notebooks og finansafstemning.
Indtag fanger kildeændringer, lander uforanderlige rådata, validerer skema og transformerer dem til testede staging‑ og dimensionelle modeller. Sene opdateringer skal korrigere den relevante historiske periode uden at duplikere fakta. Sammenlign række‑tællinger og monetære totaler med kildesystemer, test unikhed og relationer, og registrer lineage fra rapportfelt til kilde. Backfills bruger versioneret kode og isoleret validering før udskiftning af betroede tabeller.
Adgang adskiller kunde‑identifikatorer fra bredt tilgængelige aggregater og anvender mindst mulige rettigheder efter rolle og formål. Arbejdsbelastningsstyring holder ledelses‑dashboards responsive, mens analytikere kører udforskende forespørgsler. Overvåg friskhed, mislykkede tests, forespørgselsomkostninger, ubrugte tabeller og semantiske ændringer. Et warehouse er succesfuldt, når styrede målinger understøtter gentagelige beslutninger; blot centralisering af data kan centralisere forvirring, hvis ejerskab, kvalitet og definitioner forbliver uafklarede.
Katastrofe‑gendannelse bør specificere backup‑dækning, tvær‑region kopier, katalog‑ og tilladelses‑gendannelse, acceptabelt datatab og genoprettelsestid. Test gendannelse i et isoleret miljø og verificér målinger, ikke kun filer. Krypteringsnøgler, identitets‑konfiguration, orkestreringskode og semantiske definitioner er en del af det genoprettelige system. Et warehouse, der kan gendanne petabytes, men ikke kan reproducere adgangspolitik eller betroede beregninger, har ikke genoprettet sin analytiske service.
Praktisk implementerings‑tjekliste
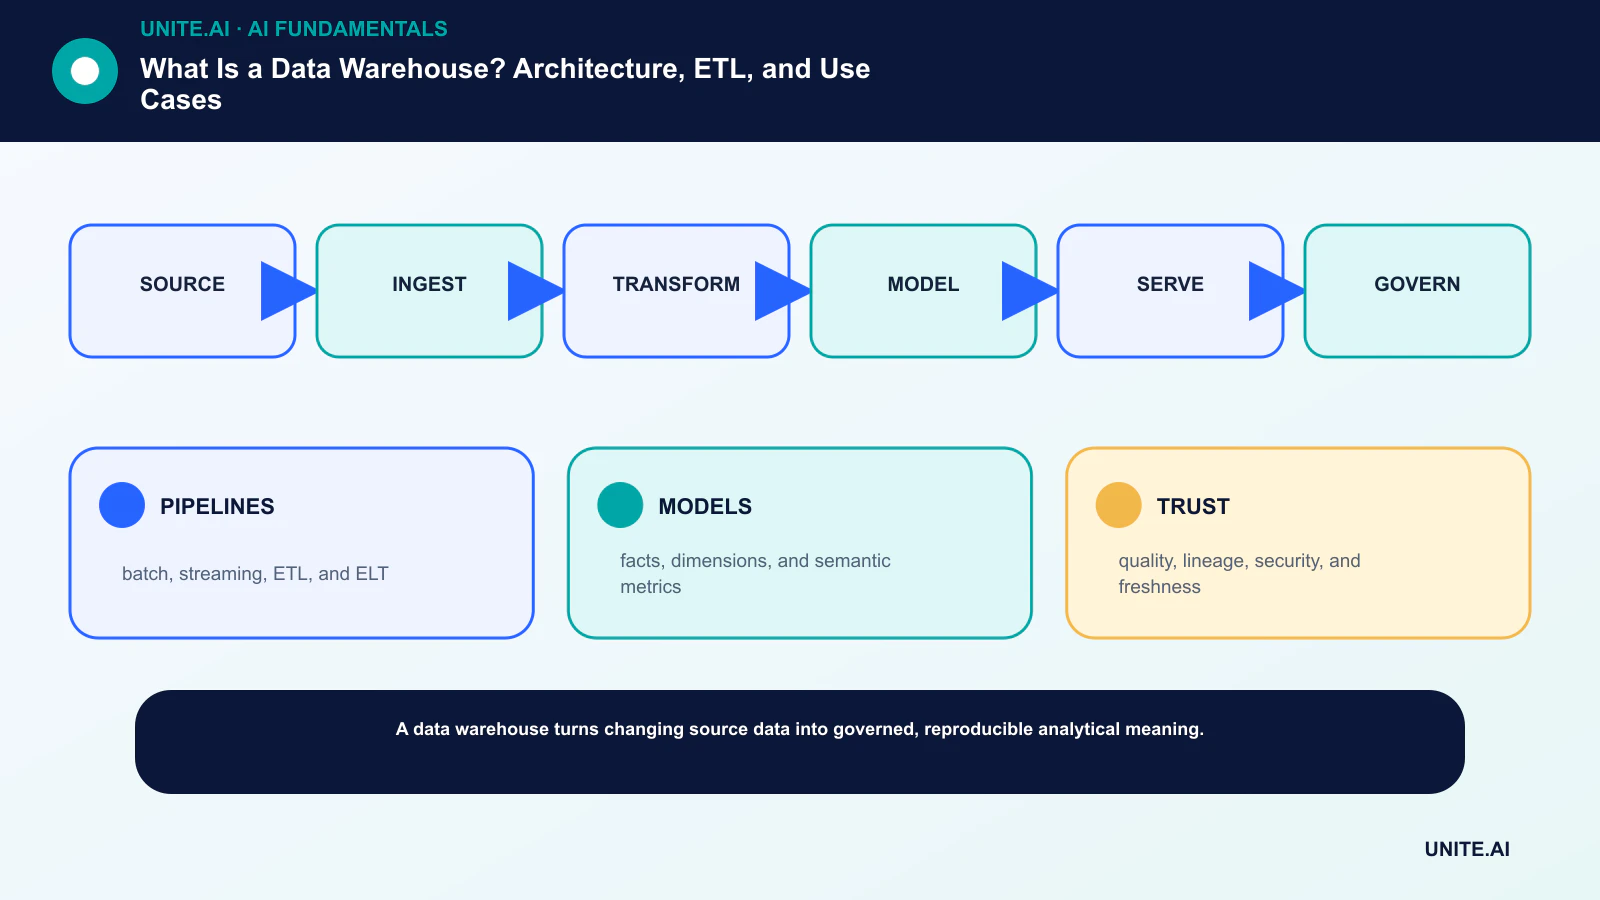
Omform konceptet til en afgrænset, testbar arbejdsgang: kilde → indtag → transform → model → levere → styre. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang før udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsetilstande, afhængigheds‑fejl og misbrug; bevar beviserne og uafklarede risici. Definér hvem der kan godkende frigivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når virkelige data ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- PIPELINES: batch, streaming, ETL og ELT.
- MODELS: facts, dimensions og semantiske målinger.
- TRUST: kvalitet, lineage, sikkerhed og friskhed.
Ofte stillede spørgsmål
Er et data warehouse blot en stor database?
Det er en database eller analytisk platform designet omkring integreret, historisk analyse. Dens modellering, indtag, styring og arbejdsbelastningsmønstre adskiller sig fra en transaktions‑applikationsdatabase.
Skal en virksomhed bruge ETL eller ELT?
Mange bruger begge dele. Transformér tidligt, når privatliv, validering eller båndbredde kræver det; transformér efter indlæsning, når lagerets beregning og hurtig iteration er fordelagtige.
Primære referencer